Область обхода, robots.txt и директивы
Решайте, чего обход может касаться: правила области, политика robots и проверка robots.txt, которая объясняет, какое правило какой URL блокирует.
Область обхода, robots.txt и директивы
Проверка robots.txt
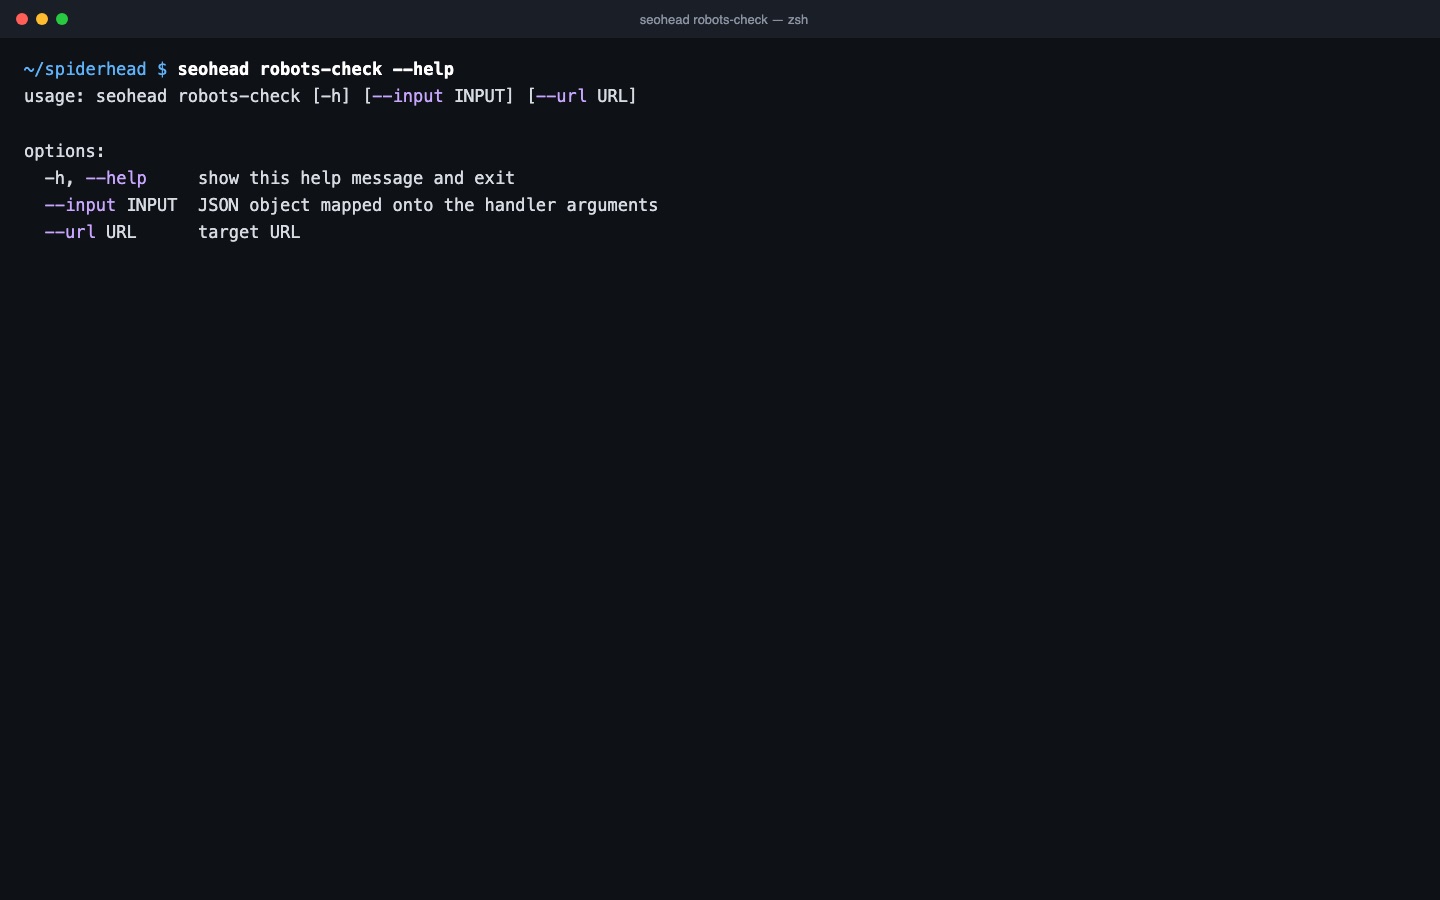
robots-check читает robots.txt и показывает заблокированные пути, заявленные sitemap и ресурсы, нужные для рендеринга.
- Заблокированный для рендера JS или CSS
- Директива Sitemap есть или нет
Директивы
Поуровневые noindex, nofollow, nosnippet, unavailable_after и X-Robots-Tag читаются и попадают в отчёт.
Три шага — один сохранённый скан
Задайте область обхода
Шаблоны включения и исключения, именованные сегменты, фильтры расширений, лимит глубины и лимит URL определяют, какие страницы скачиваются.
Выберите политику robots
Каждый обход может соблюдать robots.txt, только сообщать о блокировках или игнорировать его. Флаг — --robots respect, report_only или ignore.
Проверьте путь до обхода
robots-check читает файл для одного user-agent и проверяет заданные вами пути — вы узнаёте, что краулеру можно запрашивать.
Проверки в этой возможности
| Проверка | Что значит | Критичность | Доказательство |
|---|---|---|---|
IMPORTANT_URL_BLOCKED_BY_ROBOTS | Живая страница с внутренними ссылками заблокирована robots.txt. Ссылки не несут ценности для обнаружения, и страница выпадает из пути обхода. Robots.txt блокирует обход, а не индексацию. | Important | Заблокированный URL, ведущие на него внутренние ссылки и сработавшее правило Disallow |
BLOCKED_BY_ROBOTS | URL заблокирован robots.txt. Подтвердите, что это намеренно. | Important | Заблокированный URL и правило |
ROBOTS_BLOCKS_RESOURCES | robots.txt блокирует JavaScript или CSS, нужные для рендеринга, — поисковик может отрендерить страницу неполностью. | Important | Заблокированный .js/.css-URL и правило |
DIRECTIVES_OUTSIDE_HEAD | Мета-директива robots вне элемента head не применяется. noindex или nofollow в такой позиции не действуют. | Critical | Элемент, перед которым стоит директива в документе |
UNAVAILABLE_AFTER | На странице директива unavailable_after — она уберёт страницу из индекса в заданную дату. | Important | Значение директивы и дата |
NOINDEX | Страница содержит noindex. Подтвердите, что выход из индекса намеренен. | Tip | Источник директивы: meta robots или X-Robots-Tag |
SITEMAP_NOT_IN_ROBOTS | В robots.txt нет директивы Sitemap. Строка с абсолютным URL sitemap помогает краулерам его найти. | Tip | Директивы Sitemap в robots.txt |
Одна команда
seohead robots-check --url https://example.com/Сначала установите: руководство по установке. Каждая команда работает и как MCP-инструмент для ИИ-агентов.
Из реестра проверок
BLOCKED_BY_ROBOTSIMPORTANT_URL_BLOCKED_BY_ROBOTSROBOTS_BLOCKS_RESOURCESSITEMAP_NOT_IN_ROBOTSNOINDEXNOSNIPPET