
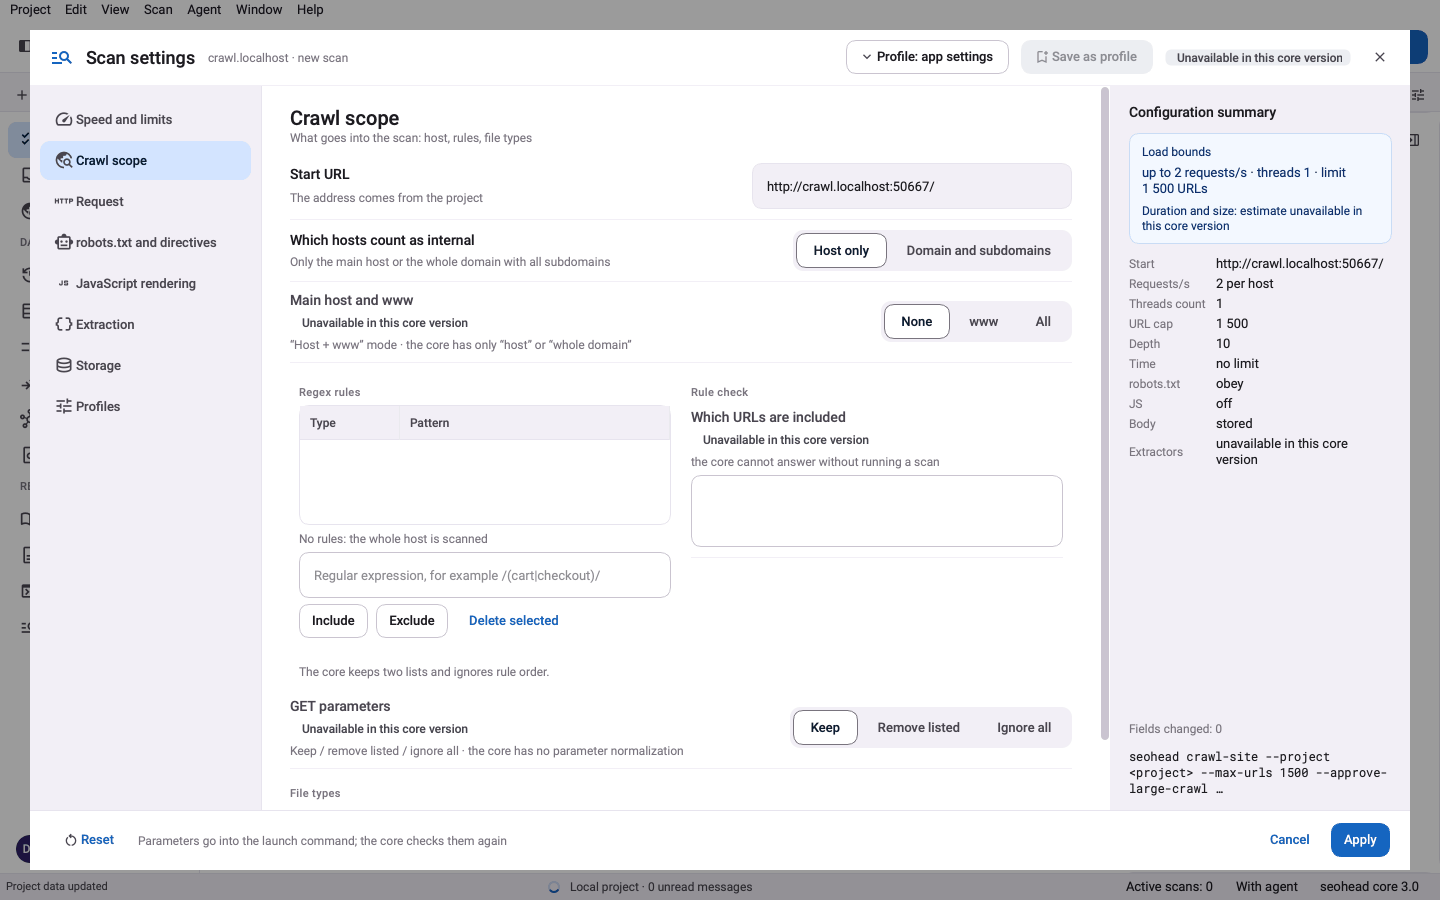
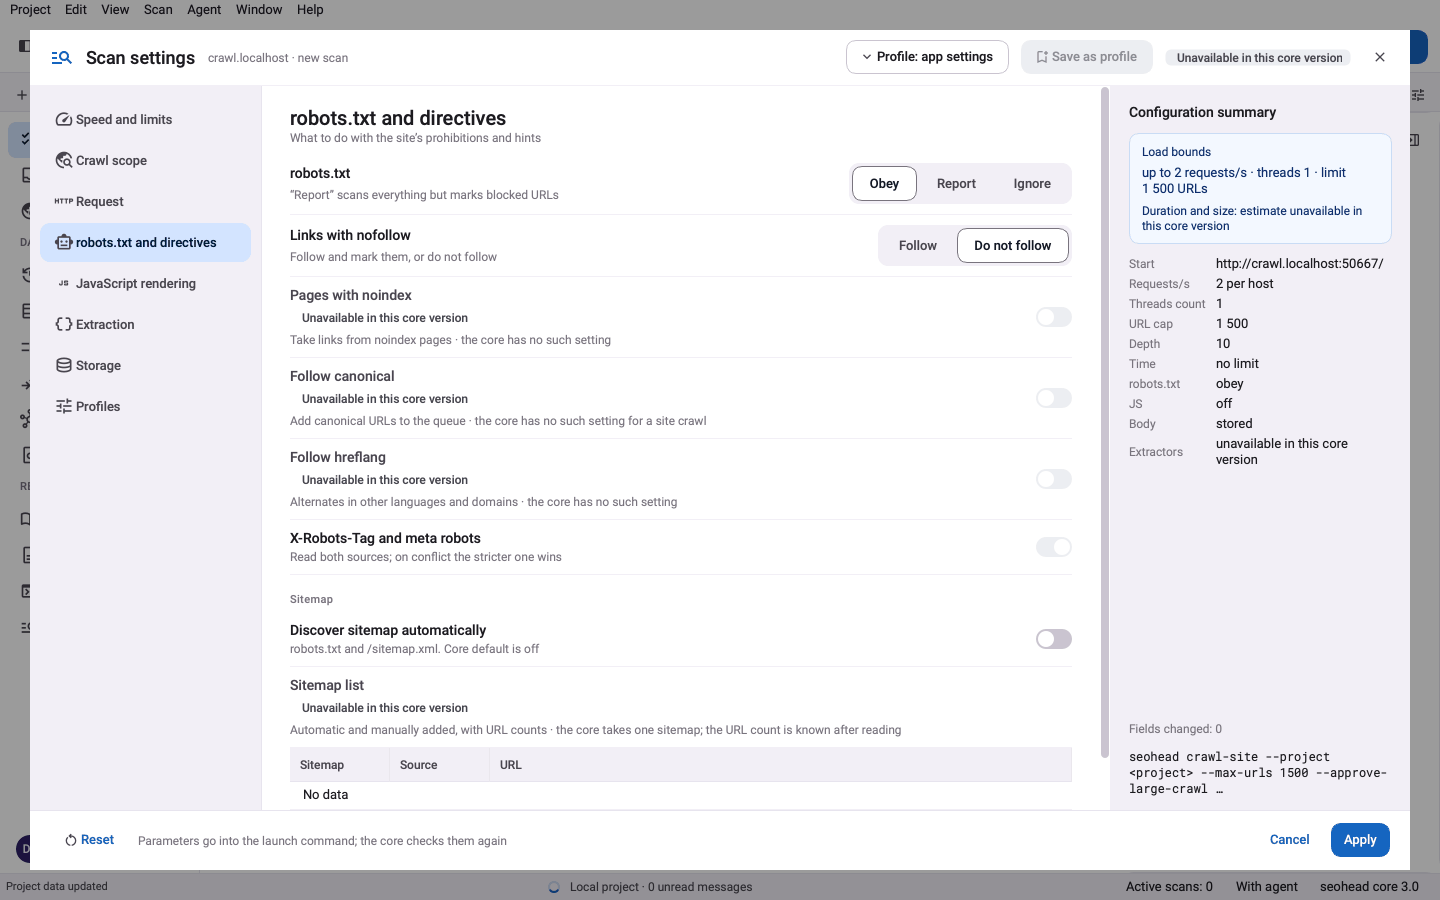
Périmètre de crawl, robots.txt et directives

Décidez ce qu’un crawl peut parcourir : règles de périmètre, politique robots et contrôle de robots.txt qui indique quelle règle bloque quelle URL.

Ce qu'elle fait

Contrôle de robots.txt

robots-check télécharge robots.txt et indique les groupes de user-agents, les sitemaps déclarés et si les chemins que vous lui donnez sont crawlables. Une réponse 4xx, comme 404, est lue comme l’absence de robots.txt : le crawl est donc autorisé. Une réponse 429 ou 5xx est une erreur : l’outil n’affirme jamais un accès qu’il n’a pas pu vérifier.

  • JS ou CSS bloqués dont le rendu a besoin : signalés par l’audit (ROBOTS_BLOCKS_RESOURCES)
  • Directive Sitemap présente ou absente (SITEMAP_NOT_IN_ROBOTS)

Directives

L’audit lit les directives noindex, nofollow, nosnippet et unavailable_after au niveau de la page, ainsi que l’en-tête X-Robots-Tag. Il signale aussi une directive meta robots placée en dehors de l’élément head, où elle reste sans effet. robots.txt contrôle le crawl, pas l’indexation : ces directives font donc l’objet d’un contrôle séparé.

Trois étapes, un seul scan enregistré

  1. Définissez le périmètre du crawl

    Les motifs d’inclusion et d’exclusion, les segments nommés, les filtres d’extensions, une limite de profondeur et un plafond d’URL déterminent les pages téléchargées par un crawl.

  2. Choisissez la politique robots

    Chaque crawl peut respecter robots.txt, se contenter de signaler ce qu’il bloque ou l’ignorer. L’option est --robots respect, report_only ou ignore.

  3. Testez un chemin avant de crawler

    robots-check lit le fichier pour un user-agent donné et liste ses groupes et ses sitemaps. Pour tester des chemins précis, transmettez-les par --input au format JSON ou via l’outil MCP seo_robots_check.

Contrôles de cette fonctionnalité

ContrôleSignificationGravitéPreuve
IMPORTANT_URL_BLOCKED_BY_ROBOTSUne page active qui reçoit des liens internes est bloquée par robots.txt. Ces liens n’ont aucune valeur pour la découverte, et la page sort du chemin du crawl. robots.txt bloque le crawl, pas l’indexation.ImportantURL bloquée, liens internes qui y pointent et règle Disallow correspondante
BLOCKED_BY_ROBOTSUne URL est bloquée par robots.txt. Vérifiez que ce blocage est voulu.ImportantURL bloquée et règle correspondante
ROBOTS_BLOCKS_RESOURCESrobots.txt bloque du JavaScript ou du CSS nécessaires au rendu : les moteurs de recherche risquent de rendre la page de façon incomplète.TipURL .js ou .css bloquée et règle qui la bloque
DIRECTIVES_OUTSIDE_HEADUne directive meta robots placée en dehors de l’élément head n’est pas appliquée. Un noindex ou un nofollow à cet endroit est sans effet.CriticalÉlément qui précède la directive dans le document
UNAVAILABLE_AFTERLa page porte une directive unavailable_after, qui la retire de l’index à une date fixée.ImportantValeur de la directive et date
NOINDEXLa page contient une directive noindex. Vérifiez que la sortie de l’index est voulue.TipSource de la directive : meta robots ou X-Robots-Tag
SITEMAP_NOT_IN_ROBOTSrobots.txt ne contient pas de directive Sitemap. Ajouter une ligne avec l’URL absolue du sitemap aide les crawlers à le trouver.TipDirectives Sitemap trouvées dans robots.txt
Aussi dans le registre des contrôles
NOSNIPPET

Une seule commande

bash
seohead robots-check --url https://example.com/

Commencez par installer : guide d'installation. Chaque commande fonctionne aussi comme outil MCP pour les agents IA.

Ce qu'il vous faut

  • Une URL de site ou de page pour robots-check
  • Pour les chemins et le user-agent : l’outil MCP seo_robots_check ou l’option --input au format JSON
  • Pour un crawl : une politique --robots et, facultativement, des règles de périmètre dans un fichier de configuration

Limites

  • robots-check en ligne de commande n’accepte qu’une URL : les chemins et le user-agent passent par --input ou MCP
  • Les règles robots.txt sont testées pour un user-agent à la fois
  • ignore ne télécharge pas du tout robots.txt
  • Les règles de périmètre déterminent ce qui est téléchargé ; les exclusions de constats ne masquent les constats qu’après le crawl

Questions

robots.txt retire-t-il une page de Google ?
Non. Il bloque le crawl, pas l’indexation. Une page bloquée peut rester indexée à partir des liens, et une directive noindex qui s’y trouve n’est jamais lue tant que la page est bloquée. Pour retirer une page de l’index, autorisez le crawl et mettez un noindex.
Que fait robots-check si robots.txt est absent ?
Une réponse 4xx, comme 404, signifie qu’aucun robots.txt n’existe : le rapport indique que le crawl est autorisé. Une réponse 429 ou 5xx renvoie une erreur, et l’outil n’affirme jamais que le crawl est autorisé.
Peut-on crawler une seule rubrique d’un site ?
Oui. Utilisez les motifs d’inclusion ou d’exclusion, scope segments_only pour télécharger des segments nommés, et les filtres par extension ou type de média. Les plafonds de profondeur et d’URL maintiennent le crawl dans les limites que vous avez fixées.
Un crawl respecte-t-il robots.txt par défaut ?
Oui. La politique par défaut est respect. report_only enregistre ce que robots.txt bloquerait sans l’appliquer, et ignore ne tient pas compte de robots.txt. Le réglage robots.user_agent_token choisit les règles de user-agent à appliquer.