
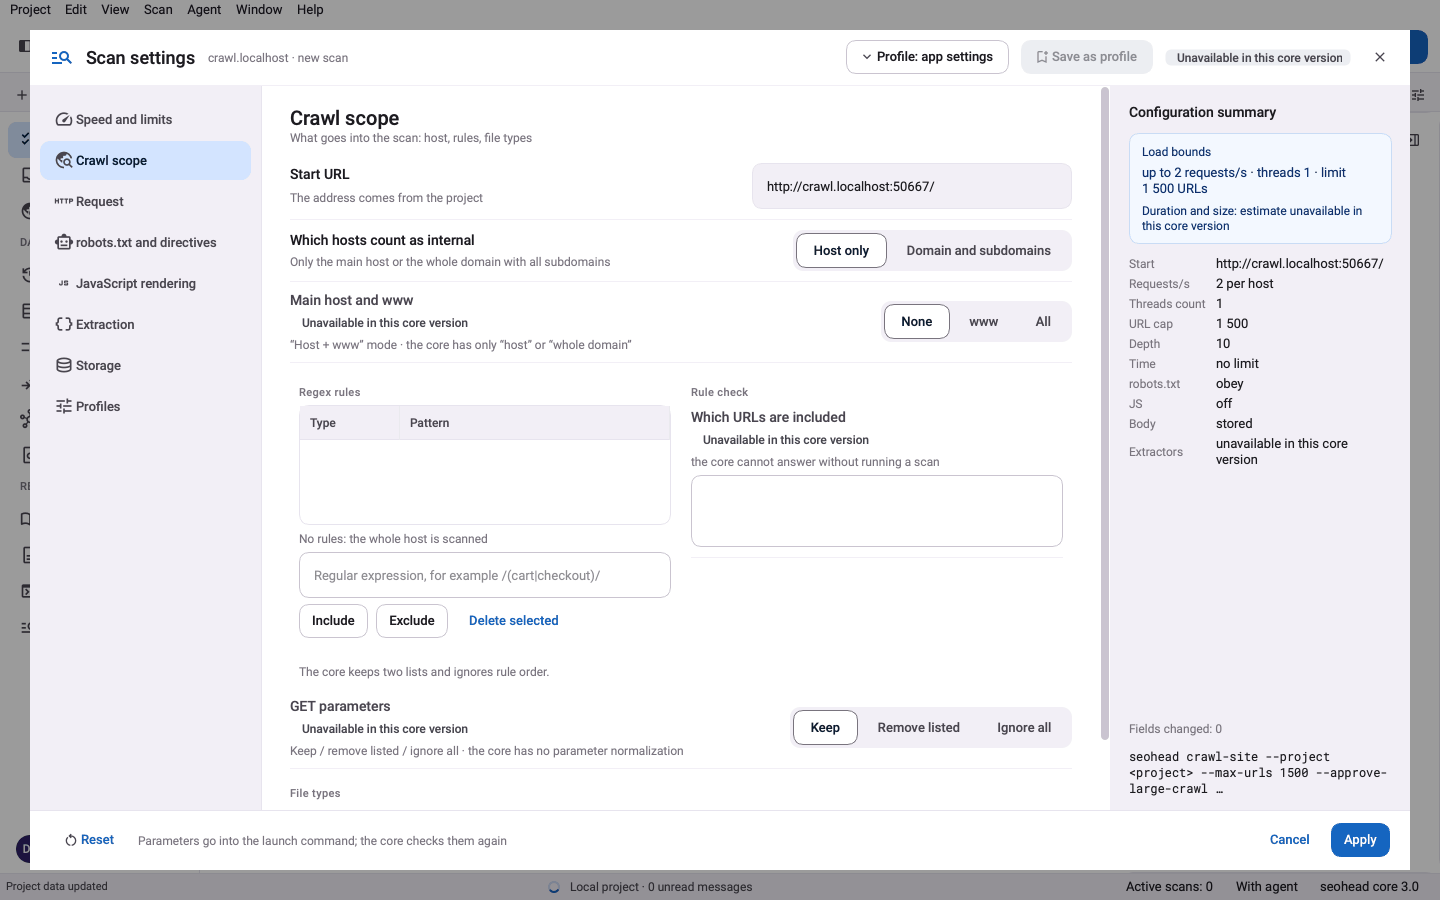
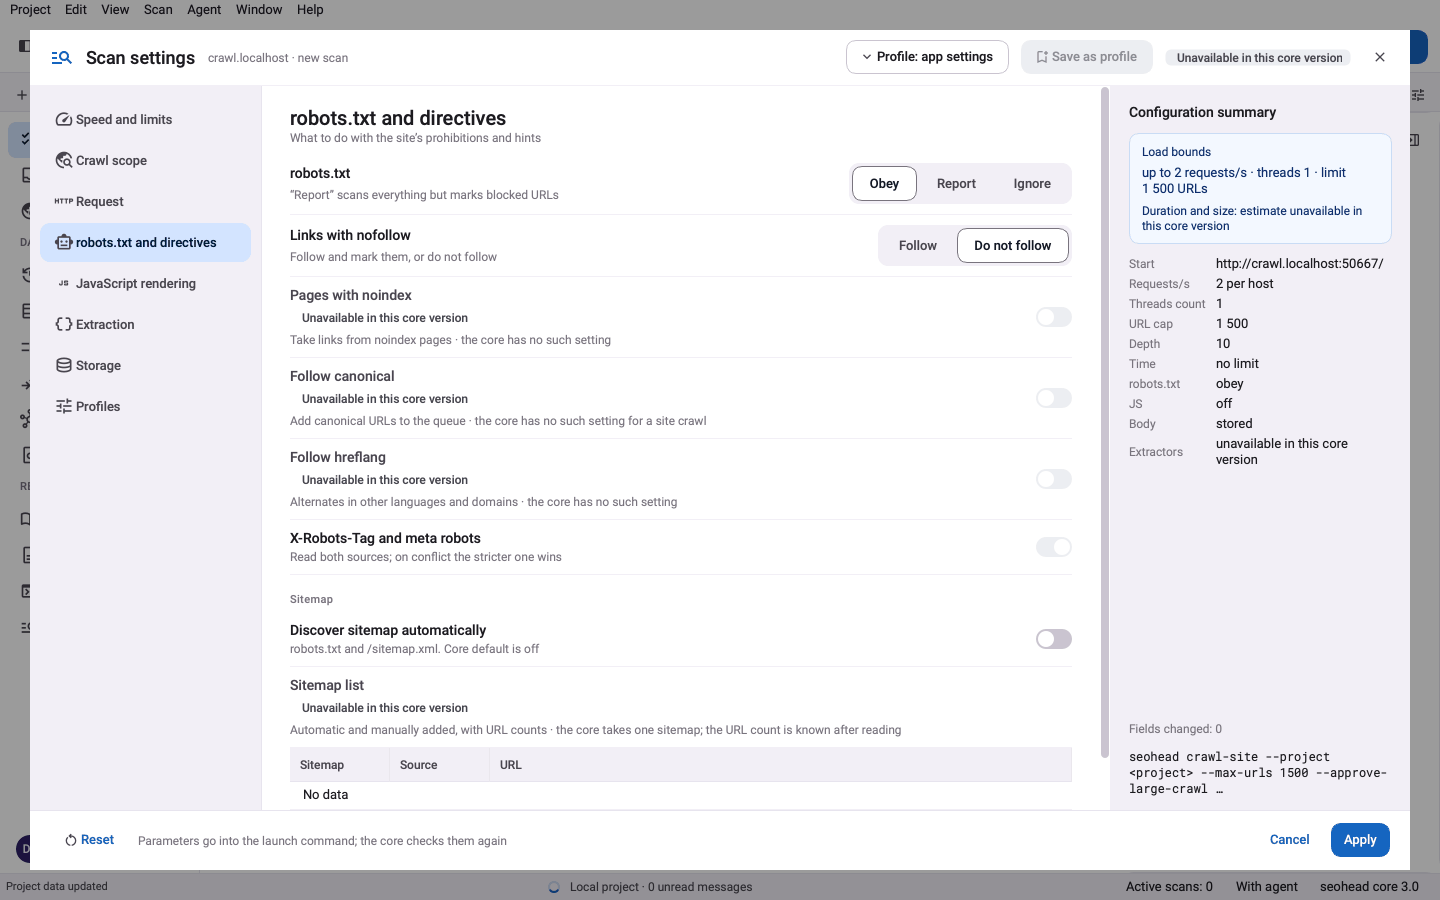
Ambito della scansione, robots.txt e direttive

Decidi cosa può toccare una scansione: regole di ambito, policy di robots e un controllo robots.txt che spiega quale regola blocca quale URL.

Cosa fa

Controllo robots.txt

robots-check scarica robots.txt e riporta i gruppi di user agent, i sitemap dichiarati e se i percorsi che gli dai sono scansionabili. Una risposta 4xx come 404 viene letta come assenza di robots.txt, quindi la scansione è permessa. Una risposta 429 o 5xx è un errore: lo strumento non dichiara mai un accesso che non ha potuto verificare.

  • JS o CSS bloccati che servono al rendering vengono segnalati dall'audit (ROBOTS_BLOCKS_RESOURCES)
  • Direttiva Sitemap presente o assente (SITEMAP_NOT_IN_ROBOTS)

Direttive

L'audit legge i noindex, nofollow, nosnippet e unavailable_after a livello di pagina, insieme all'header X-Robots-Tag. Segnala anche una direttiva meta robots piazzata fuori dall'elemento head, dove non ha effetto. robots.txt controlla la scansione, non l'indicizzazione, quindi queste direttive sono verificate separatamente.

Tre passaggi, una scansione salvata

  1. Imposta l'ambito della scansione

    Pattern di inclusione ed esclusione, segmenti indicati per nome, filtri per estensione, un limite di profondità e un tetto di URL decidono quali pagine scarica una scansione.

  2. Scegli la policy robots

    Ogni scansione può obbedire a robots.txt, solo riportare cosa blocca, o ignorarlo. Il flag è --robots respect, report_only o ignore.

  3. Prova un percorso prima di scansionare

    robots-check legge il file per un user agent ed elenca i suoi gruppi e i sitemap. Per verificare percorsi specifici, passali con --input JSON o con lo strumento MCP seo_robots_check.

Controlli di questa funzionalità

ControlloCosa significaGravitàEvidenza
IMPORTANT_URL_BLOCKED_BY_ROBOTSUna pagina attiva che riceve link interni è bloccata da robots.txt. I link non portano valore per la scoperta, quindi la pagina si perde dal percorso di scansione. robots.txt blocca la scansione, non l'indicizzazione.ImportantURL bloccata, i link interni che la puntano e la regola Disallow corrispondente
BLOCKED_BY_ROBOTSUna URL è bloccata da robots.txt. Conferma che il blocco sia intenzionale.ImportantURL bloccata e regola corrispondente
ROBOTS_BLOCKS_RESOURCESrobots.txt blocca JavaScript o CSS serviti al rendering, quindi i motori possono renderizzare la pagina in modo incompleto.TipURL .js o .css bloccata e la regola che la blocca
DIRECTIVES_OUTSIDE_HEADUna direttiva meta robots sta fuori dall'elemento head, quindi non viene applicata. Un noindex o nofollow in quella posizione non ha effetto.CriticalL'elemento che precede la direttiva nel documento
UNAVAILABLE_AFTERLa pagina porta una direttiva unavailable_after, che la rimuove dall'indice a una data fissata.ImportantValore e data della direttiva
NOINDEXLa pagina contiene una direttiva noindex. Conferma che uscire dall'indice sia intenzionale.TipOrigine della direttiva: meta robots o X-Robots-Tag
SITEMAP_NOT_IN_ROBOTSrobots.txt non contiene la direttiva Sitemap. Aggiungerne una con la URL assoluta del sitemap aiuta i crawler a trovarlo.TipDirettive Sitemap trovate in robots.txt
Anche nel registro dei controlli
NOSNIPPET

Un solo comando

bash
seohead robots-check --url https://example.com/

Prima installa SpiderHead: guida all'installazione. Ogni comando funziona anche come strumento MCP per agenti AI.

Cosa ti serve

  • Una URL di sito o di pagina per robots-check
  • Per percorsi e user agent: lo strumento MCP seo_robots_check oppure l'opzione --input JSON
  • Per una scansione: una policy --robots e regole di ambito facoltative in un file di configurazione

Limiti

  • robots-check da riga di comando prende solo una URL; percorsi e user agent passano da --input o da MCP
  • Le regole di robots.txt sono verificate per un user agent alla volta
  • ignore non scarica affatto robots.txt
  • Le regole di ambito decidono cosa viene scaricato; le esclusioni dei controlli nascondono solo le segnalazioni dopo la scansione

Domande

robots.txt tiene una pagina fuori da Google?
No. Blocca la scansione. Una pagina bloccata può comunque essere indicizzata dai link, e un noindex su quella pagina non viene mai letto finché la pagina è bloccata. Per tenere una pagina fuori dall'indice, permetti la scansione e usa noindex.
Cosa fa robots-check quando manca robots.txt?
Una risposta 4xx come 404 significa che robots.txt non esiste, quindi il rapporto dice che la scansione è permessa. Una risposta 429 o 5xx restituisce un errore, e lo strumento non dichiara mai che la scansione sia permessa.
Posso scansionare solo una sezione di un sito?
Sì. Usa pattern di inclusione o esclusione in scope, scope segments_only per scaricare segmenti indicati per nome, e filtri per estensione o tipo di media. Profondità e tetti di URL tengono la scansione dentro i limiti che imposti.
La scansione segue robots.txt per impostazione predefinita?
Sì. La policy predefinita è respect. report_only registra cosa bloccherebbe robots.txt senza obbedirgli, e ignore salta robots.txt. L'impostazione robots.user_agent_token sceglie quali regole di user agent vengono fatte corrispondere.