
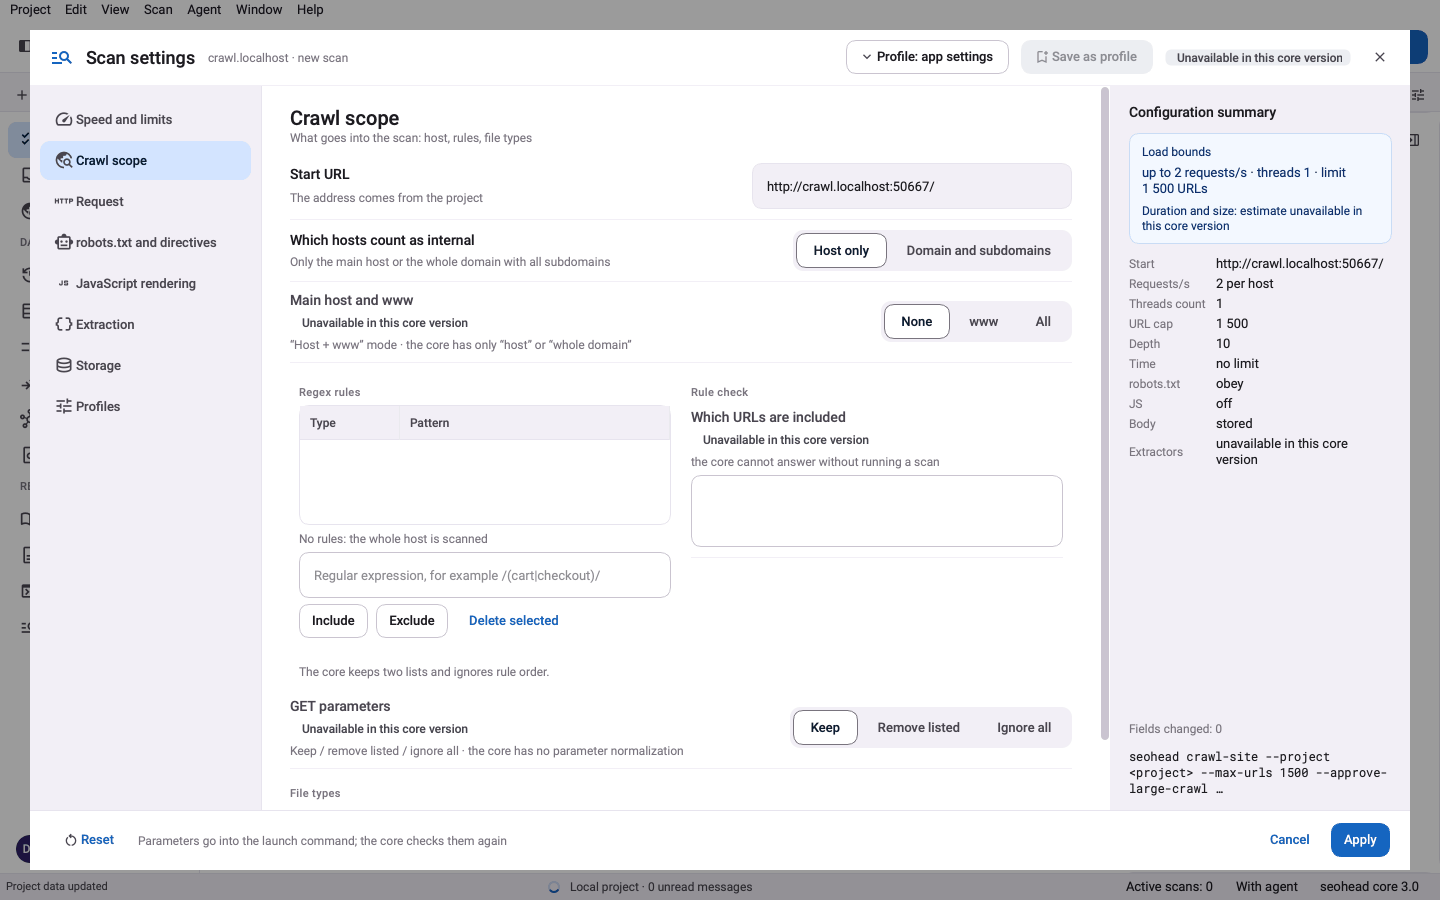
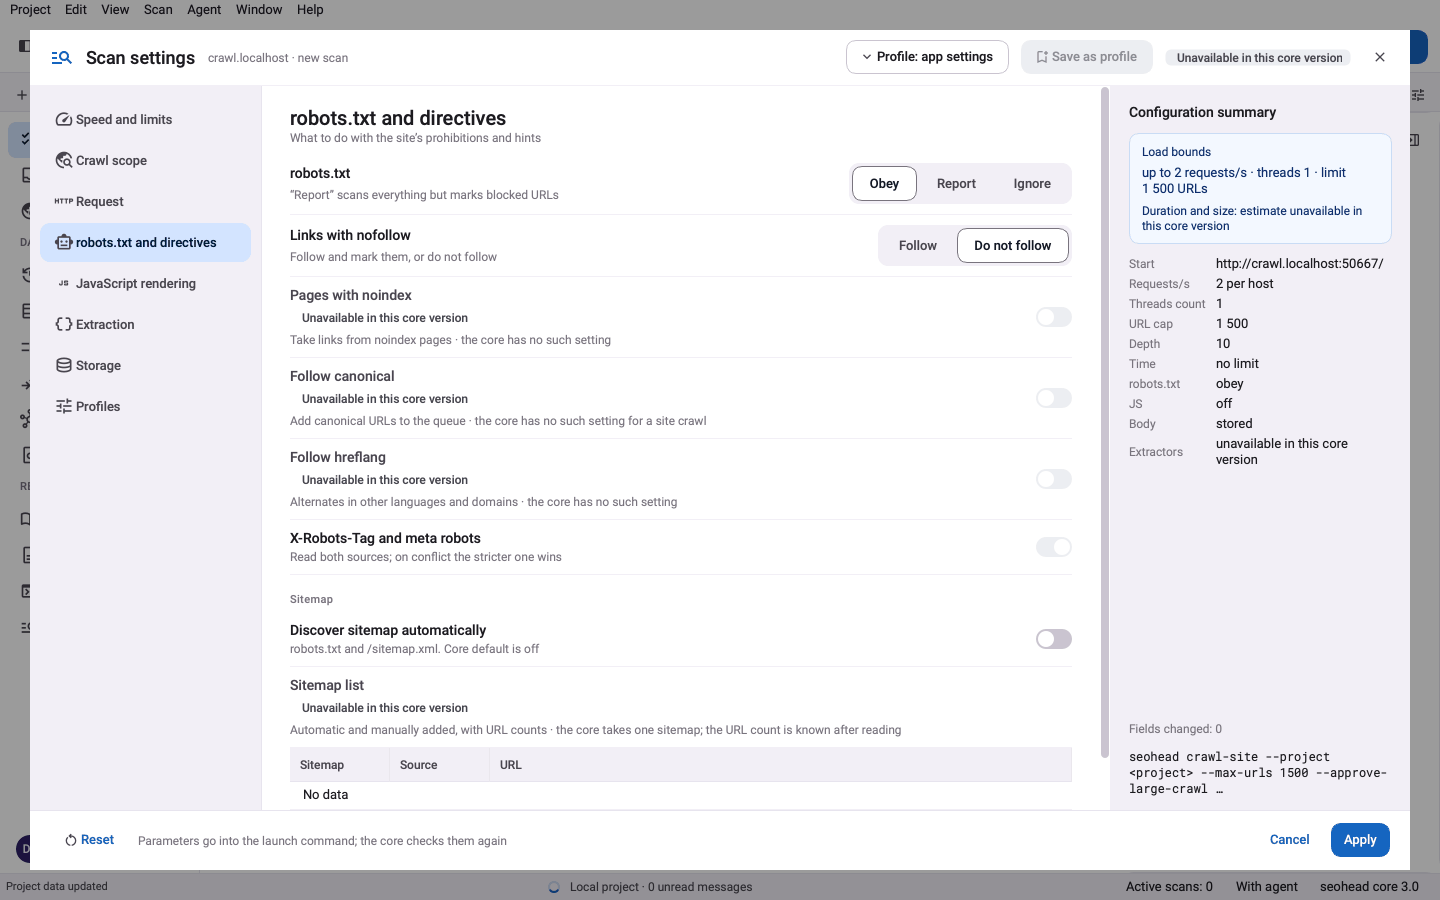
Alcance del rastreo, robots.txt y directivas

Decide qué puede tocar un rastreo: reglas de alcance, política de robots y una comprobación de robots.txt que explica qué regla bloquea cada URL.

Qué hace

Comprobación de robots.txt

robots-check descarga robots.txt y muestra los grupos por user-agent, los sitemap declarados y si las rutas que le indicas se pueden rastrear. Una respuesta 4xx, como 404, se toma como ausencia de robots.txt, así que el rastreo está permitido. Una respuesta 429 o 5xx es un error: la herramienta nunca afirma tener un acceso que no pudo verificar.

  • JS o CSS bloqueados que necesita el renderizado; la auditoría los marca (ROBOTS_BLOCKS_RESOURCES)
  • Sitemap en robots.txt: presente o ausente (SITEMAP_NOT_IN_ROBOTS)

Directivas

La auditoría lee noindex, nofollow, nosnippet y unavailable_after a nivel de página, junto con la cabecera HTTP X-Robots-Tag. También marca una directiva meta robots colocada fuera del elemento head, donde no tiene efecto. robots.txt controla el rastreo, no la indexación, así que estas directivas se comprueban por separado.

Tres pasos, un análisis guardado

  1. Define el alcance del rastreo

    Los patrones de inclusión y exclusión, los segmentos con nombre, los filtros de extensión, un límite de profundidad y un tope de URL deciden qué páginas descarga un rastreo.

  2. Elige la política de robots

    Cada rastreo puede respetar robots.txt, solo informar de lo que bloquea o ignorarlo. El flag es --robots respect, report_only o ignore.

  3. Prueba una ruta antes de rastrear

    robots-check lee el archivo para un user-agent y muestra sus grupos y sitemap. Para probar rutas concretas, pásalas con --input JSON o con la herramienta MCP seo_robots_check.

Comprobaciones de esta función

ComprobaciónQué significaGravedadEvidencia
IMPORTANT_URL_BLOCKED_BY_ROBOTSUna página activa que recibe enlaces internos está bloqueada por robots.txt. Esos enlaces no aportan valor para el descubrimiento, y la página queda fuera de la ruta de rastreo. robots.txt bloquea el rastreo, no la indexación.ImportantURL bloqueada, los enlaces internos que apuntan a ella y la regla Disallow que coincide
BLOCKED_BY_ROBOTSrobots.txt bloquea la URL. Confirma que el bloqueo es intencionado.ImportantURL bloqueada y la regla que coincide
ROBOTS_BLOCKS_RESOURCESrobots.txt bloquea JavaScript o CSS que necesita el renderizado, así que los buscadores pueden renderizar la página de forma incompleta.TipURL .js o .css bloqueada y la regla que la bloquea
DIRECTIVES_OUTSIDE_HEADUna directiva meta robots está fuera del elemento head, así que no se aplica. Un noindex o nofollow en esa posición no tiene efecto.CriticalEl elemento que precede a la directiva en el documento
UNAVAILABLE_AFTERLa página lleva la directiva unavailable_after, que la retira del índice en una fecha determinada.ImportantValor de la directiva y fecha
NOINDEXLa página contiene una directiva noindex. Confirma que salir del índice es intencionado.TipOrigen de la directiva: meta robots o cabecera X-Robots-Tag
SITEMAP_NOT_IN_ROBOTSrobots.txt no tiene directiva Sitemap. Añadir una con la URL absoluta del sitemap ayuda a los rastreadores a encontrarlo.TipDirectivas Sitemap encontradas en robots.txt
También en el registro de comprobaciones
NOSNIPPET

Un solo comando

bash
seohead robots-check --url https://example.com/

Primero, instala SpiderHead: guía de instalación. Cada comando también funciona como herramienta MCP para agentes de IA.

Qué necesitas

  • Una URL de sitio o de página para robots-check
  • Para rutas y user-agent: la herramienta MCP seo_robots_check o la opción --input con JSON
  • Para un rastreo: una política --robots y, si quieres, reglas de alcance en un archivo de configuración

Límites

  • robots-check en la línea de comandos solo acepta una URL; las rutas y el user-agent van por --input o por MCP
  • Las reglas de robots.txt se prueban para un user-agent cada vez
  • ignore no descarga robots.txt en absoluto
  • Las reglas de alcance determinan qué se descarga; las exclusiones de incidencias solo ocultan incidencias después del rastreo

Preguntas

¿robots.txt saca una página de Google?
No. Detiene el rastreo. Una página bloqueada puede seguir indexándose por enlaces, y un noindex en esa página nunca se lee mientras está bloqueada. Para sacar una página del índice, permite el rastreo y usa noindex.
¿Qué hace robots-check si falta robots.txt?
Una respuesta 4xx, como 404, significa que robots.txt no existe, y el informe dice que el rastreo está permitido. Una respuesta 429 o 5xx devuelve un error, y la herramienta nunca afirma que el rastreo está permitido.
¿Puedo rastrear solo una sección del sitio?
Sí. Usa patrones de inclusión o exclusión del alcance, el scope segments_only para descargar segmentos con nombre, y filtros de extensión o de tipo de medio. Los límites de profundidad y de URL mantienen el rastreo dentro de los márgenes que fijes.
¿Un rastreo sigue robots.txt por defecto?
Sí. La política por defecto es respect. report_only registra lo que robots.txt bloquearía sin obedecerlo, e ignore omite robots.txt. El ajuste robots.user_agent_token elige qué reglas de user-agent se aplican.

Pruébalo en tu propio sitio