
Escopo do rastreamento, robots.txt e diretivas

Decida o que um rastreamento pode acessar: regras de escopo, política de robots e uma verificação de robots.txt que explica qual regra bloqueia cada URL.

O que faz

Verificação de robots.txt

O robots-check busca o robots.txt e informa os grupos de user-agent, os sitemaps declarados e se os caminhos que você informou podem ser rastreados. Uma resposta 4xx, como 404, é lida como ausência de robots.txt, então o rastreamento é permitido. Uma resposta 429 ou 5xx é erro: a ferramenta nunca afirma um acesso que não conseguiu verificar.

  • A auditoria sinaliza JS ou CSS bloqueados que a renderização precisa (ROBOTS_BLOCKS_RESOURCES)
  • Diretiva Sitemap presente ou ausente no robots.txt (verificação SITEMAP_NOT_IN_ROBOTS)

Diretivas

A auditoria lê noindex, nofollow, nosnippet e unavailable_after no nível da página, junto com o cabeçalho X-Robots-Tag. Ela também sinaliza uma diretiva meta robots colocada fora do elemento head, onde não tem efeito. O robots.txt controla o rastreamento, não a indexação, por isso essas diretivas são verificadas separadamente.

Três passos, um rastreamento salvo

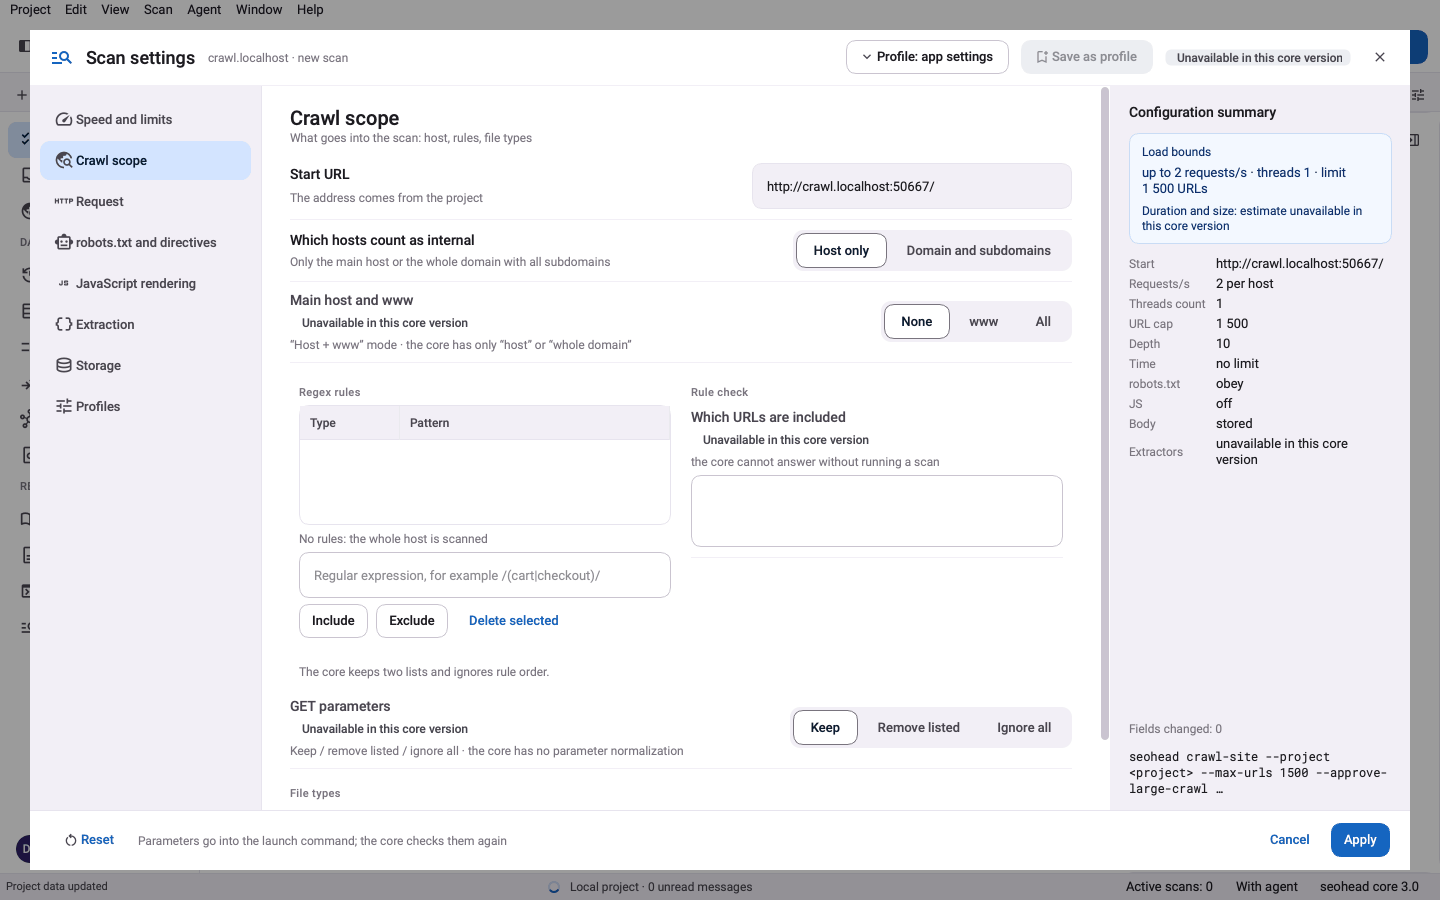
  1. Defina o escopo do rastreamento

    Padrões de inclusão e exclusão, segmentos nomeados, filtros de extensão, um limite de profundidade e um teto de URLs decidem quais páginas um rastreamento busca.

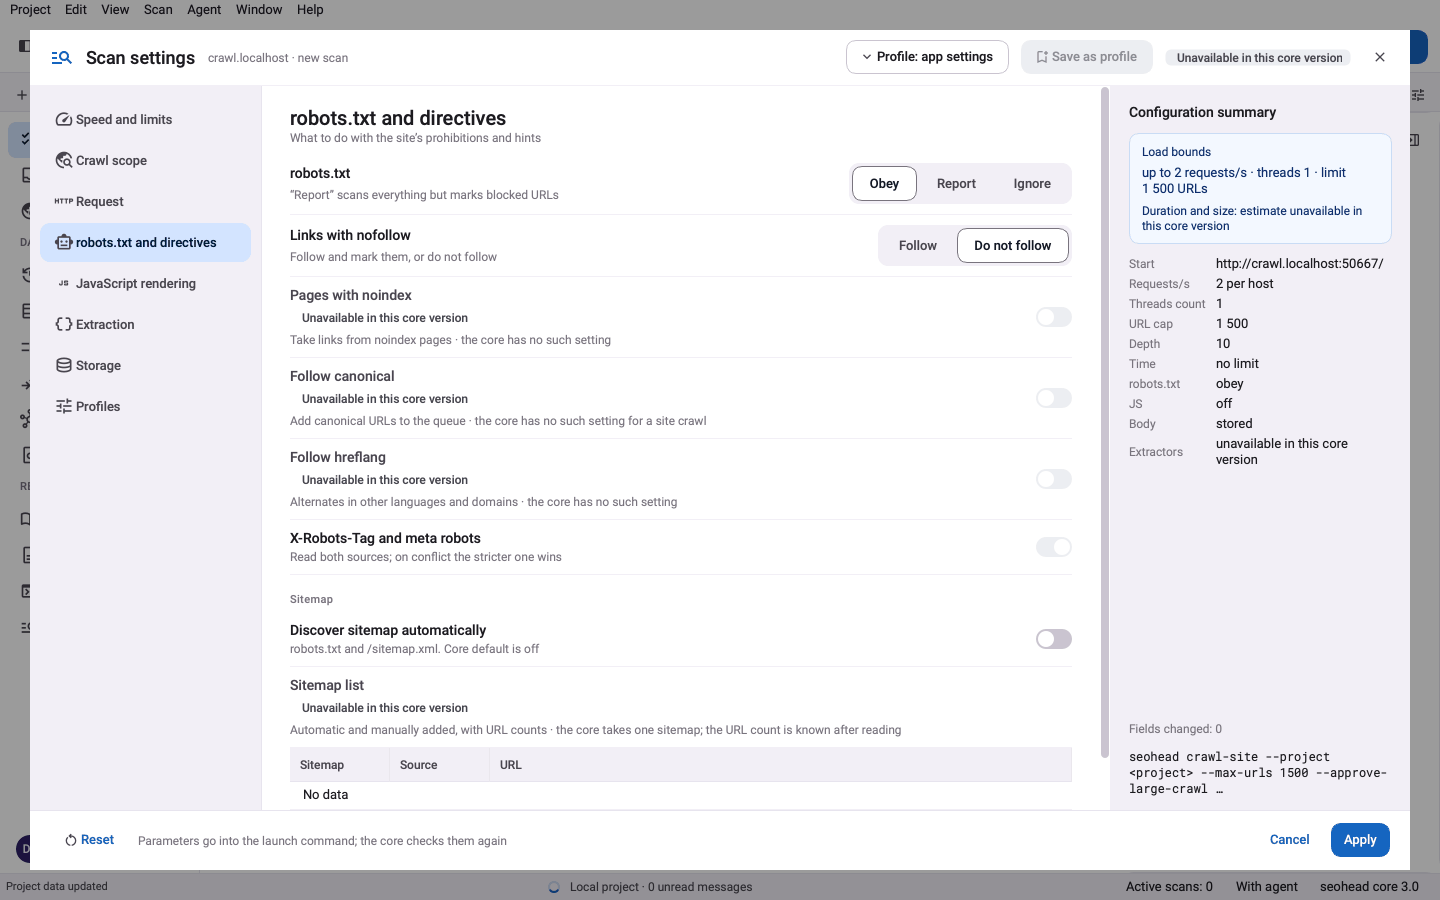
  2. Escolha a política de robots

    Cada rastreamento pode obedecer ao robots.txt, apenas registrar o que ele bloqueia ou ignorá-lo. A flag é --robots respect, report_only ou ignore.

  3. Teste um caminho antes de rastrear

    O robots-check lê o arquivo para um user-agent e lista seus grupos e sitemaps. Para testar caminhos específicos, passe-os por --input JSON ou pela ferramenta MCP seo_robots_check.

Verificações deste recurso

VerificaçãoO que significaGravidadeEvidência
IMPORTANT_URL_BLOCKED_BY_ROBOTSUma página ativa que recebe links internos está bloqueada pelo robots.txt. Os links não têm valor para descoberta, então a página sai do caminho do rastreamento. O robots.txt bloqueia o rastreamento, não a indexação.ImportantURL bloqueada, os links internos que apontam para ela e a regra Disallow correspondente
BLOCKED_BY_ROBOTSUma URL está bloqueada pelo robots.txt. Confirme se o bloqueio é intencional.ImportantURL bloqueada e a regra correspondente
ROBOTS_BLOCKS_RESOURCESO robots.txt bloqueia JavaScript ou CSS necessários para a renderização, então os buscadores podem renderizar a página de forma incompleta.TipURL .js ou .css bloqueada e a regra que a bloqueia
DIRECTIVES_OUTSIDE_HEADUma diretiva meta robots está fora do elemento head, então não é aplicada. Um noindex ou nofollow nessa posição não tem efeito.CriticalO elemento que vem antes da diretiva no documento
UNAVAILABLE_AFTERA página tem a diretiva unavailable_after, que a remove do índice em uma data definida.ImportantValor da diretiva e data
NOINDEXA página contém uma diretiva noindex. Confirme que sair do índice é intencional.TipOrigem da diretiva: meta robots ou X-Robots-Tag
SITEMAP_NOT_IN_ROBOTSO robots.txt não tem diretiva Sitemap. Adicionar uma com a URL absoluta do sitemap ajuda os rastreadores a encontrá-lo.TipDiretivas Sitemap encontradas no robots.txt
Também no registro de verificações
NOSNIPPET

Um comando

bash
seohead robots-check --url https://example.com/

Instale primeiro: guia de instalação. Todo comando também funciona como ferramenta MCP para agentes de IA.

O que você precisa

  • Uma URL do site ou da página para o robots-check
  • Para caminhos e user-agent: a ferramenta MCP seo_robots_check ou a opção --input com JSON
  • Para um rastreamento: uma política --robots e, se quiser, regras de escopo em um arquivo de configuração

Limites

  • O robots-check na linha de comando aceita só uma URL; caminhos e user-agent passam por --input ou MCP
  • As regras do robots.txt são testadas para um user-agent por vez
  • ignore não busca o robots.txt de jeito nenhum
  • Regras de escopo definem o que é buscado; exclusões de problemas apenas escondem problemas depois do rastreamento

Perguntas

O robots.txt tira uma página do Google?
Não. Ele impede o rastreamento. Uma página bloqueada ainda pode ser indexada a partir de links, e um noindex nela nunca é lido enquanto a página estiver bloqueada. Para tirar uma página do índice, libere o rastreamento e use noindex.
O que o robots-check faz quando não há robots.txt?
Uma resposta 4xx, como 404, significa que o robots.txt não existe, então o relatório diz que o rastreamento é permitido. Uma resposta 429 ou 5xx retorna erro, e a ferramenta nunca afirma que o rastreamento é permitido.
Posso rastrear só uma seção do site?
Sim. Use os padrões de inclusão ou exclusão do escopo, scope segments_only para buscar segmentos nomeados e filtros de extensão ou tipo de mídia. Os limites de profundidade e de URLs mantêm o rastreamento dentro dos limites que você definir.
Um rastreamento segue o robots.txt por padrão?
Sim. A política padrão é respect. report_only registra o que o robots.txt bloquearia sem obedecer a ele, e ignore pula o robots.txt. A configuração robots.user_agent_token escolhe quais regras de user-agent são aplicadas.

Teste no seu próprio site