
Audit SEO technique

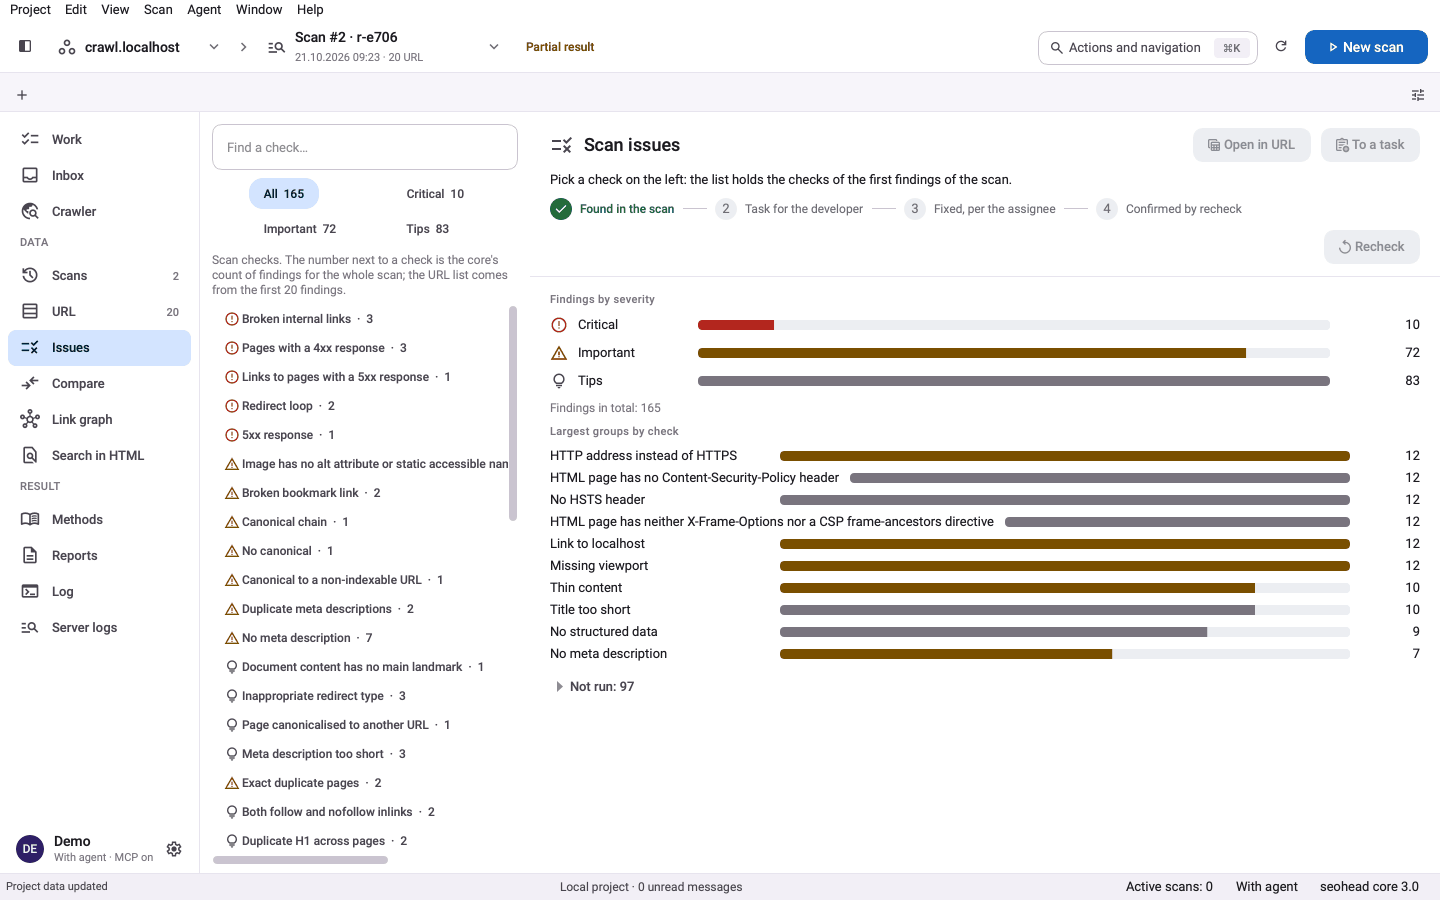
Un même registre de contrôles pilote chaque audit, que les preuves viennent des exports Screaming Frog ou d'un crawl SpiderHead. La gravité, la source de preuve et le correctif proviennent du registre que lit le moteur de règles : un constat ne dit jamais plus que ce que le moteur peut prouver.

Ce qu'elle fait

Des preuves, pas des suppositions

Chaque constat indique l'URL, ce qui a été observé et un correctif. Pour les constats sur les liens, il indique aussi où le lien se trouve dans la page. Un contrôle qui n'a pas de données pour s'exécuter est signalé comme ignoré, avec la raison, et jamais comme réussi.

  • Niveaux de gravité : critique, avertissement et information
  • Position du lien et XPath pour les constats sur les liens (à partir des exports Inlinks de Screaming Frog)
  • Chaque constat est accompagné d'un texte de correctif issu du registre

Une couverture transparente

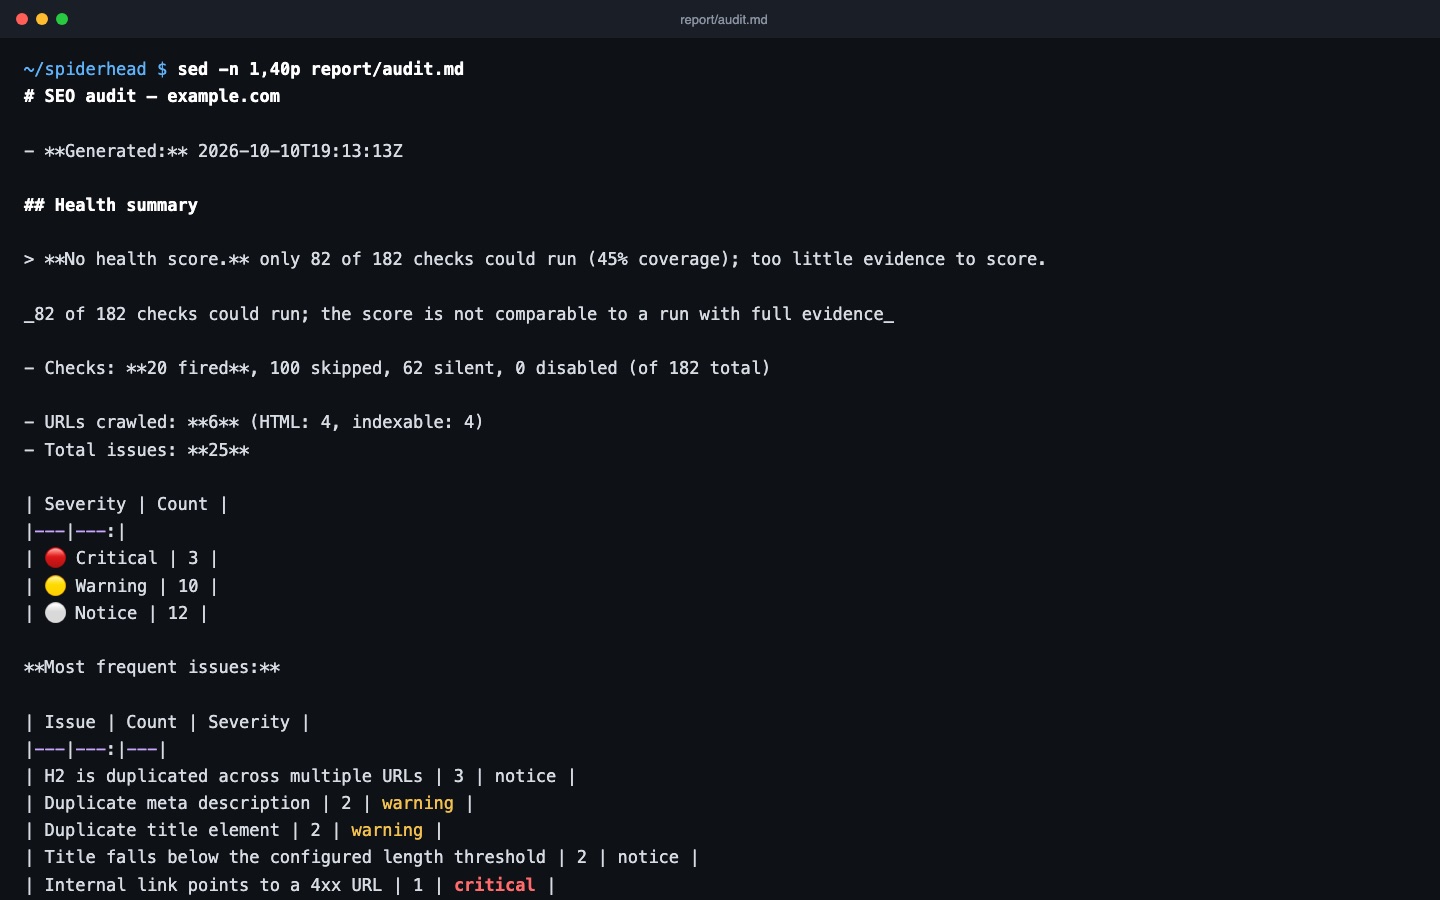
Le rapport compte le nombre de contrôles qui ont pu s'exécuter avec les preuves fournies. Quand la couverture est inférieure à la moitié, le score de santé est retenu. Une couverture plus faible marque aussi le score comme non comparable avec un audit disposant de preuves complètes.

  • Les contrôles ignorés sont listés avec l'élément manquant
  • Pas de score à partir de trop peu de preuves
  • Relancez l'audit avec davantage d'exports pour augmenter la couverture

Des constats à une liste de tâches

Avec l'option --tasks, l'audit écrit aussi tasks.json et tasks.md : une liste priorisée pour les développeurs, avec le correctif à côté de chaque constat. Le même audit peut faire échouer un build CI lorsque des constats d'une gravité choisie sont présents.

  • Liste de tâches au format JSON et Markdown
  • Échec sur les constats critiques ou d'avertissement, avec un code de sortie non nul
  • Formats de rapport : json et md

Trois étapes, un seul scan enregistré

  1. Indiquez-lui vos exports

    Donnez-lui un dossier d'exports CSV ou XLSX de Screaming Frog. Chaque contrôle lit le même registre, quelle que soit la manière dont les preuves ont été collectées.

  2. Exécutez chaque contrôle que les preuves permettent

    Chaque contrôle renvoie des constats, ne signale rien, ou est ignoré avec une raison lorsque les données dont il a besoin manquent.

  3. Récupérez les correctifs sous forme de liste de tâches

    Ajoutez --tasks pour obtenir tasks.json et tasks.md : un backlog priorisé pour les développeurs, avec le correctif à côté de chaque constat.

Contrôles de cette fonctionnalité

ContrôleSignificationGravitéPreuve
BROKEN_PAGE_4XXLa page répond avec un statut 4xxCriticalExport Response Codes 4xx, URL et statut
SERVER_ERROR_5XXLa page répond avec un statut 5xxCriticalExport Response Codes 5xx, URL et statut
TITLE_MISSINGLa page n'a pas d'élément titleCriticalURL de la page
BROKEN_INTERNAL_LINKUn lien interne pointe vers une URL 4xxCriticalPage source et position du lien, à partir de l'export inlinks
H1_MISSINGLa page n'a pas de titre H1ImportantURL de la page
CANONICAL_MISSINGUne page indexable n'a pas d'URL canoniqueImportantURL de la page
THIN_CONTENTLa page a un nombre de mots faibleImportantURL et nombre de mots
HEADING_BEFORE_H1Des titres apparaissent avant le premier H1 de la pageTipPlan des titres de la page

Une seule commande

bash
seohead sf run --exports-dir ./exports --out ./report --tasks

Commencez par installer : guide d'installation. Chaque commande fonctionne aussi comme outil MCP pour les agents IA.

Ce qu'il vous faut

  • Un dossier d'exports CSV ou XLSX de Screaming Frog, ou une URL de départ pour un crawl
  • Le CLI Screaming Frog sous licence, uniquement pour les modes crawl de sf run
  • Aucune clé API pour l'audit hors ligne des exports

Limites

  • Les contrôles sans les preuves nécessaires sont ignorés, jamais devinés
  • Si peu de contrôles peuvent s'exécuter, le score est retenu ou marqué comme non comparable
  • Le crawl via Screaming Frog nécessite votre propre installation sous licence
  • Les contrôles sur les pages rendues demandent un crawl avec rendu, pas des exports statiques

Questions

Ai-je besoin d'une licence Screaming Frog ?
Non, pour lire des exports. sf run --exports-dir analyse hors ligne des fichiers CSV ou XLSX de Screaming Frog déjà existants. Le crawl via le CLI Screaming Frog (--crawl) nécessite une installation de Screaming Frog sous licence. crawl-site est le crawler propre à SpiderHead : il audite son résultat avec les mêmes contrôles.
Que se passe-t-il quand un contrôle n'a pas de données pour s'exécuter ?
Il est signalé comme ignoré, avec la raison. Il n'est jamais affiché comme réussi.
L'audit modifie-t-il mon site ?
Non. Il lit des exports ou des analyses enregistrées. Un crawl envoie des requêtes en lecture seule, au rythme que vous définissez : pour les crawls Screaming Frog, c'est --max-urls-per-second, et 1 à 2 requêtes par seconde constituent un démarrage prudent.
Un agent IA peut-il lancer l'audit ?
Oui. Le même audit est disponible sous forme d'outils MCP : sf_audit_run, sf_audit_issues, sf_audit_summary et sf_audit_tasks.
Puis-je faire échouer un build CI sur des constats ?
Oui. --fail-on critical ou --fail-on warning renvoie un code de sortie non nul lorsque des constats de cette gravité sont présents. La valeur par défaut est --fail-on none : un lancement simple n'échoue donc pas à cause des constats.
Où vont les résultats ?
Dans le dossier passé avec --out, sous forme de rapport local (json et md). Rien n'est envoyé en ligne.