
Budget de crawl respectueux et limites de débit

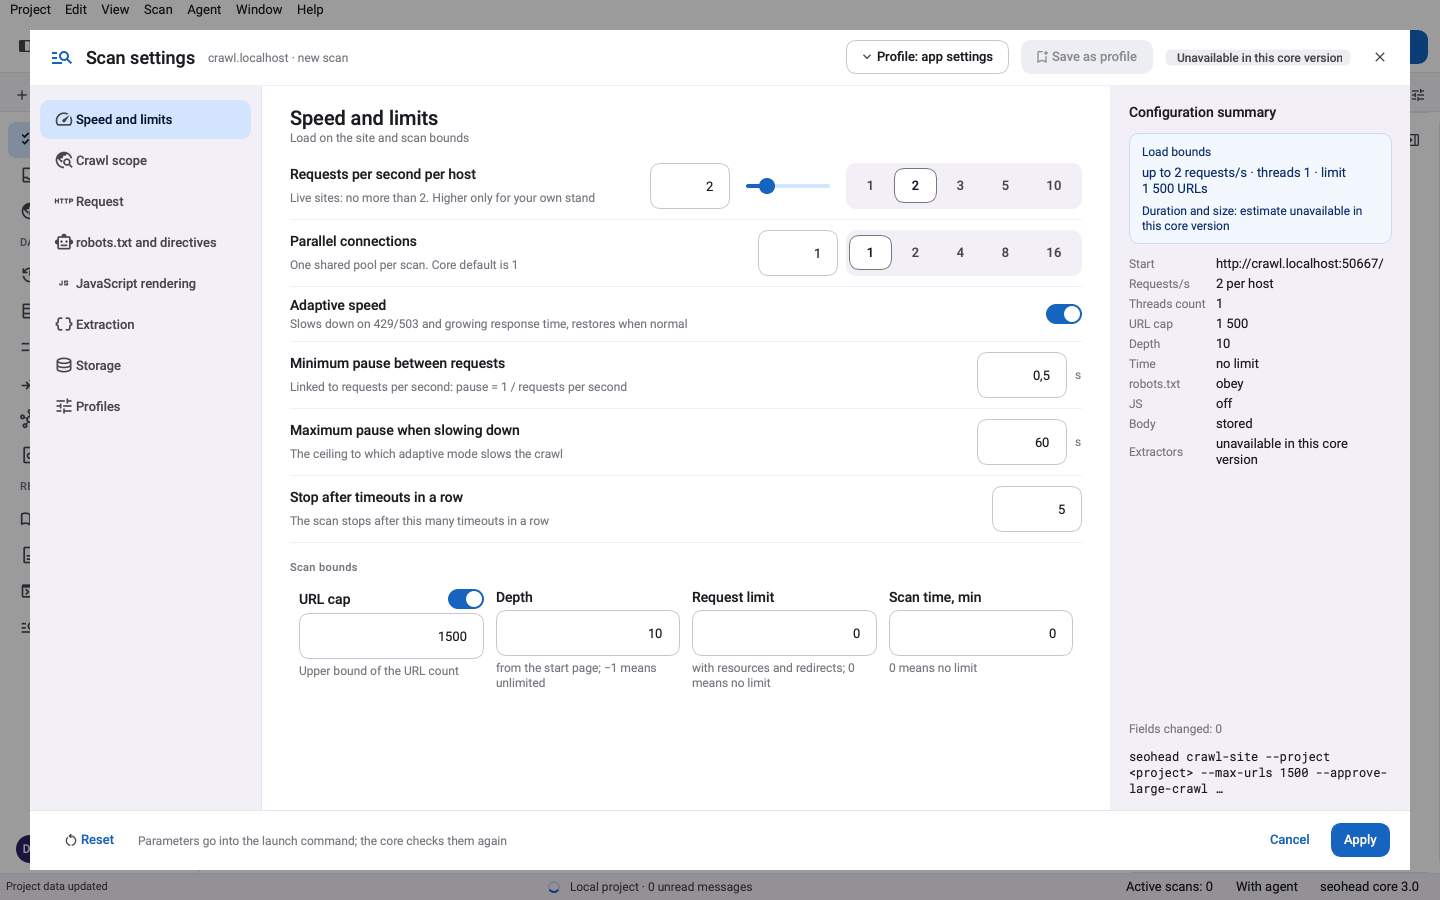
SpiderHead est respectueux par défaut : environ deux requêtes par seconde et par hôte, des requêtes bornées en lecture seule, et une limite explicite d'URL qui constitue un budget et non une supposition sur la taille du site.

Ce qu'elle fait

Budgets que vous définissez

Un crawl s'arrête aux limites que vous lui donnez : nombre d'URL (200 par défaut), profondeur des liens (5 par défaut), nombre total de tentatives HTTP et, en option, une durée maximale. Vous pouvez le restreindre avec des règles d'inclusion et d'exclusion par motif d'URL, extension de fichier ou type de média. Dépasser le budget d'un projet nécessite --approve-large-crawl.

  • --max-urls est un budget explicite, et non une supposition sur la taille du site
  • Le délai s'adapte à l'origine : il augmente quand le serveur ralentit ou dépasse le délai d'attente

Sûr par conception

Les outils réseau bloquent les cibles privées et locales, sauf si vous les autorisez par leur nom. Le crawler n'envoie que des requêtes bornées, en lecture seule, vers le site que vous indiquez, et il s'identifie par un User-Agent. Il s'arrête également de lui-même après 5 délais d'attente consécutifs.

Trois étapes, un seul scan enregistré

  1. Fixer un budget d'URL

    --max-urls limite le nombre de pages récupérées par un crawl (200 par défaut) ; dépasser le budget d'un projet nécessite --approve-large-crawl.

  2. Cadencer chaque hôte

    Le délai par défaut est de 0,5 seconde entre deux requêtes, soit environ deux par seconde et par hôte. --max-urls-per-second fixe le débit, et le ralentissement adaptatif réduit la cadence quand le serveur peine.

  3. Respecter robots.txt et les cibles privées

    robots.txt est respecté par défaut, et les adresses privées ou locales restent bloquées tant que vous ne les autorisez pas par leur nom.

Contrôles de cette fonctionnalité

ContrôleSignificationGravitéPreuve
SLOW_RESPONSELe serveur a mis plus de 1,5 seconde à répondreImportantTemps de réponse par page, comparé au seuil de 1,5 s
BLOCKED_BY_ROBOTSL'URL est bloquée par robots.txtImportantURL bloquée issue du crawl ou de l'export SF
IMPORTANT_URL_BLOCKED_BY_ROBOTSUne page qui reçoit des liens internes est bloquée par robots.txt, si bien que la découverte des liens s'arrêteImportantURL bloquée et ses liens entrants internes
ROBOTS_BLOCKS_RESOURCESrobots.txt bloque du JavaScript ou du CSS nécessaires au rendu de la pageTipURL de la ressource bloquée
SITEMAP_NOT_IN_ROBOTSrobots.txt ne contient aucune directive SitemapTipContenu de robots.txt

Une seule commande

bash
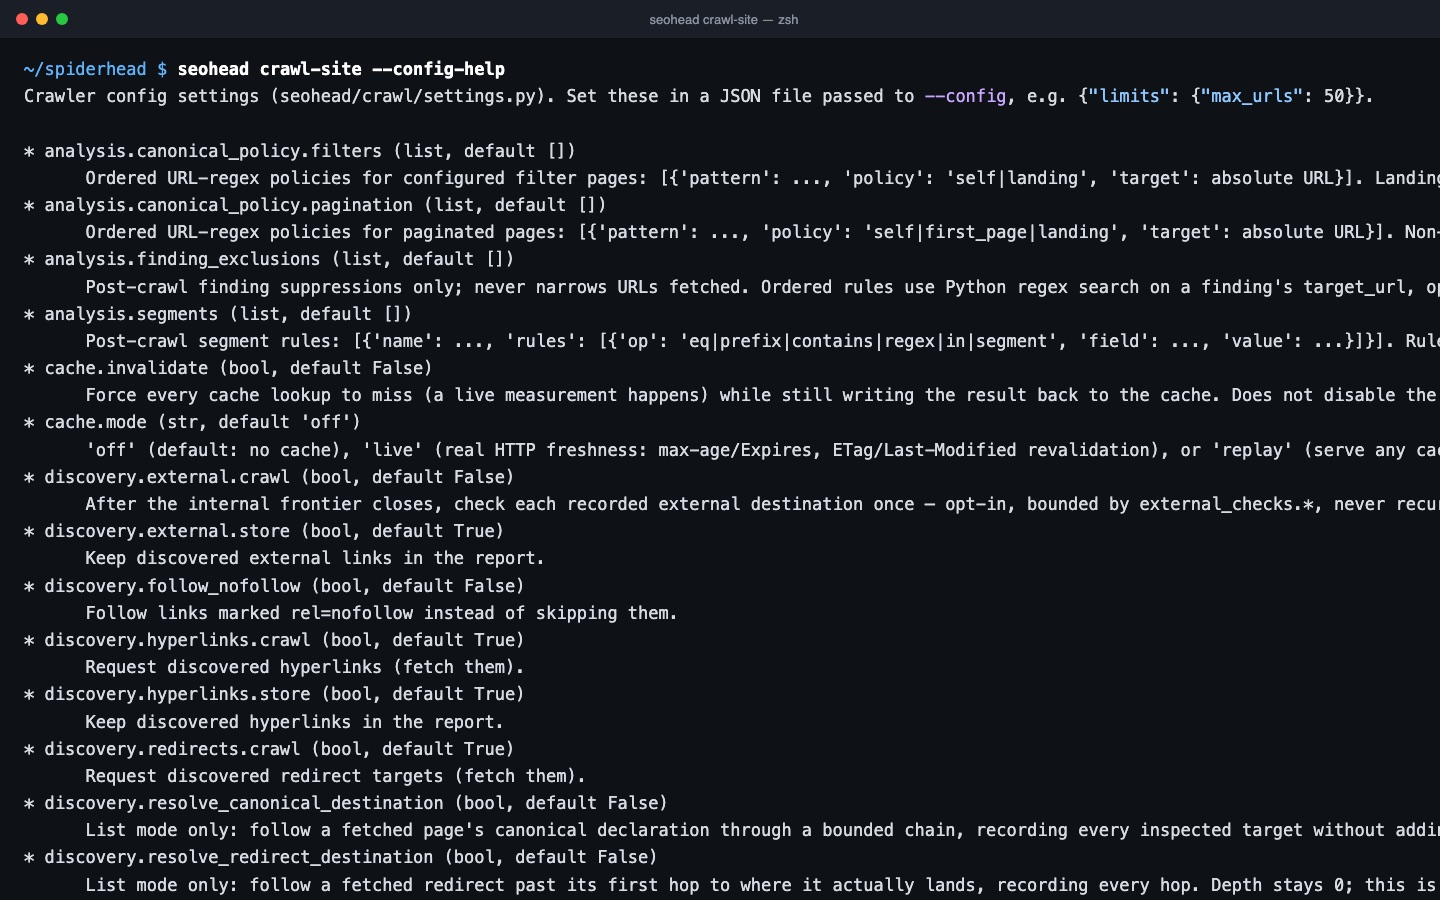
seohead crawl-site --config-help

Commencez par installer : guide d'installation. Chaque commande fonctionne aussi comme outil MCP pour les agents IA.

Ce qu'il vous faut

  • Une URL de départ
  • Facultatif : --max-urls et --max-urls-per-second
  • Facultatif : un fichier de configuration du crawl pour les délais, la profondeur et le périmètre

Limites

  • La limite de débit s'applique par hôte ; elle ne connaît pas la capacité de votre serveur
  • Le ralentissement adaptatif réagit aux réponses lentes, il ne peut pas anticiper la charge
  • --robots ignore désactive robots.txt : à réserver à vos propres sites

Questions

Le crawler va-t-il ralentir mon site ?
Par défaut, il attend 0,5 seconde entre deux requêtes et ralentit de lui-même quand le serveur répond plus lentement ou expire. Un crawl s'arrête après 5 délais d'attente consécutifs.
Respecte-t-il robots.txt ?
Oui, par défaut. --robots report_only télécharge robots.txt, indique ce qui serait bloqué, puis crawle quand même. --robots ignore ignore robots.txt entièrement : à réserver à vos propres sites.
Peut-il crawler un site de préproduction sur une adresse privée ?
Uniquement après l'avoir autorisé explicitement. SEOHEAD_ALLOW_PRIVATE_HOSTS autorise des noms d'hôte précis, et SEOHEAD_ALLOW_PRIVATE_NETWORKS=1 ouvre toutes les plages privées.
Peut-on crawler plus vite ?
Oui. --max-urls-per-second fixe le débit maximal par hôte, et speed.concurrency augmente le nombre de requêtes en cours (1 par défaut). Le ralentissement adaptatif peut toujours réduire la cadence si le serveur peine. N'augmentez ces valeurs que sur des serveurs que vous contrôlez.