
SpiderHead : crawler SEO et boîte à outils d'audit
Crawlez un site, conservez chaque scan, repérez et priorisez les problèmes, confiez des tâches aux développeurs, revérifiez les corrections et faites le rapport. Sur votre machine : dans une application de bureau, en ligne de commande ou via un agent IA par MCP.
Touchez pour agrandir
Un seul cœur, trois interfaces
L'application de bureau, la CLI et le serveur MCP appellent les mêmes fonctions : un crawl lancé par un agent apparaît dans la fenêtre, et inversement.
Application de bureau
Une fenêtre native pour macOS, Windows et Linux : problèmes, tableau des URL, graphe des liens, projets et outils avec des formulaires prêts à l'emploi.macOS, Windows et Linux.
Application de bureauCLI
Scripts, CI et travail dans le terminal. Chaque commande enregistre des preuves que vous pouvez rouvrir, exporter et réanalyser.
seohead crawl-site --url ...Serveur MCP
Un serveur local en stdio pour Claude et d'autres clients d'agents. L'agent crawle, audite et transmet les tâches avec les mêmes preuves.Pour Claude et d'autres clients d'agents.
Serveur MCP pour le SEODu premier crawl à la revérification
De vraies captures de l'application. Cliquez sur une image pour l'agrandir.
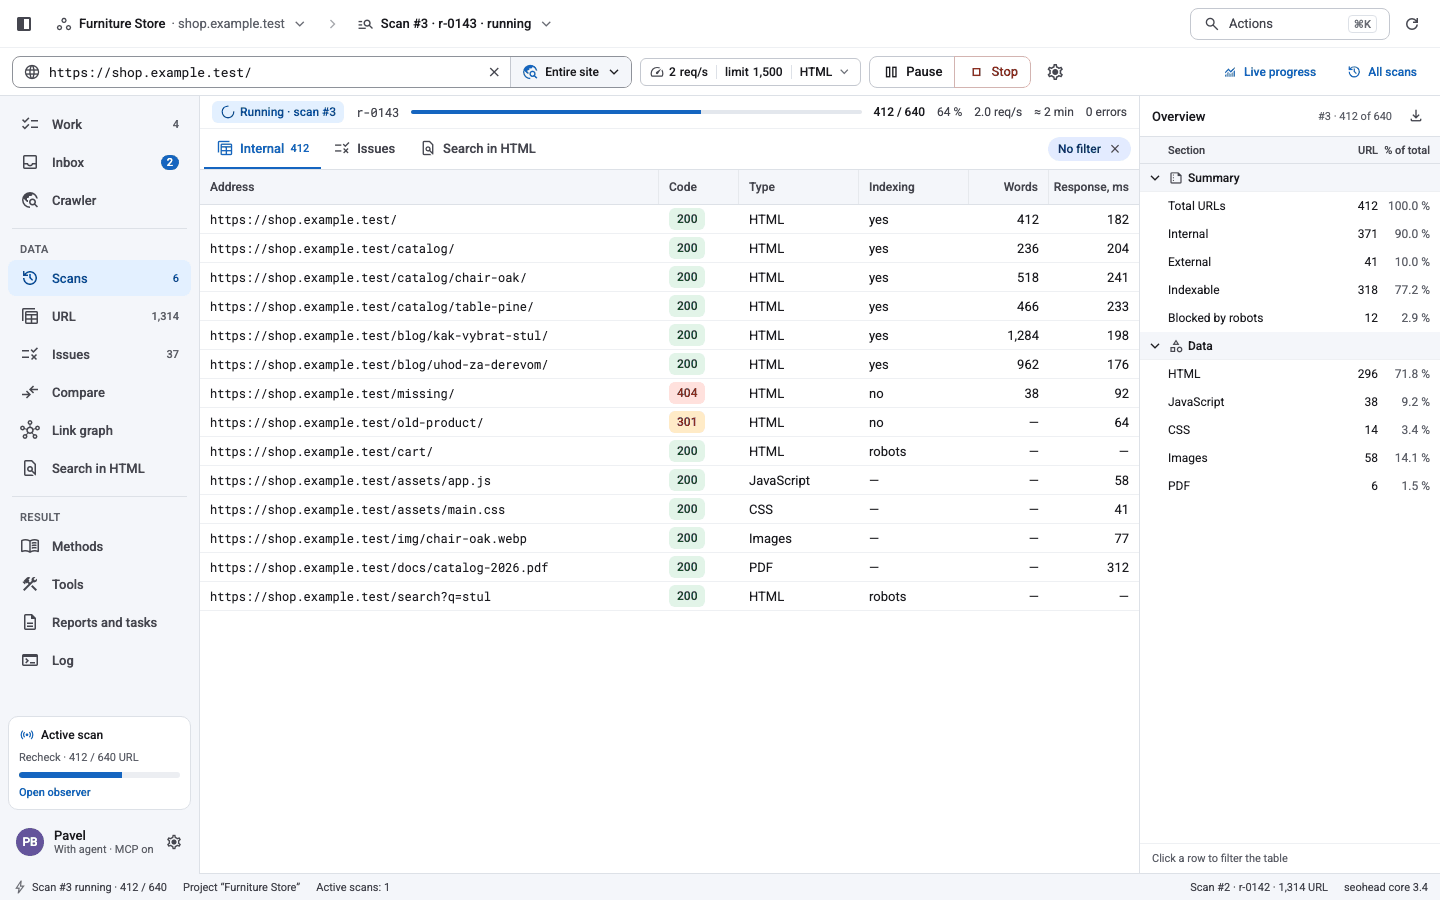
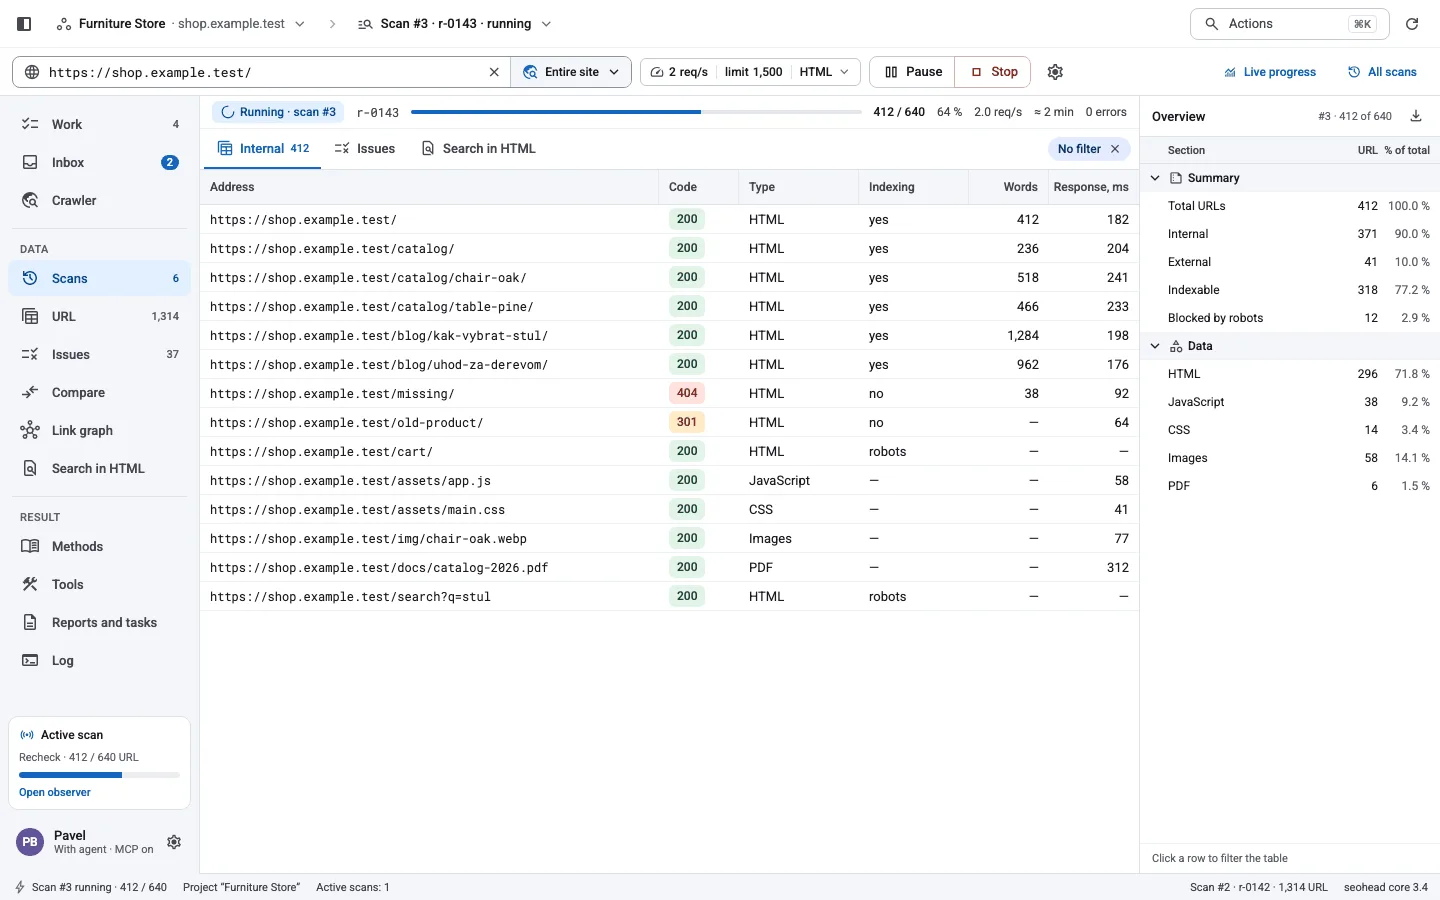
Partez d'une URL, suivez le crawl
Saisissez une URL et cliquez sur Démarrer. Progression en direct, tableau des URL qui se remplit et vue d'ensemble du scan, sans projet tant que vous ne voulez pas conserver les résultats.
- Respectueux par défautEnviron deux requêtes par seconde et par hôte, en lecture seule.
- Reprise possibleUn crawl interrompu repart là où il s'est arrêté.
- HTTP ou renduChromium uniquement quand une page exige du JavaScript.
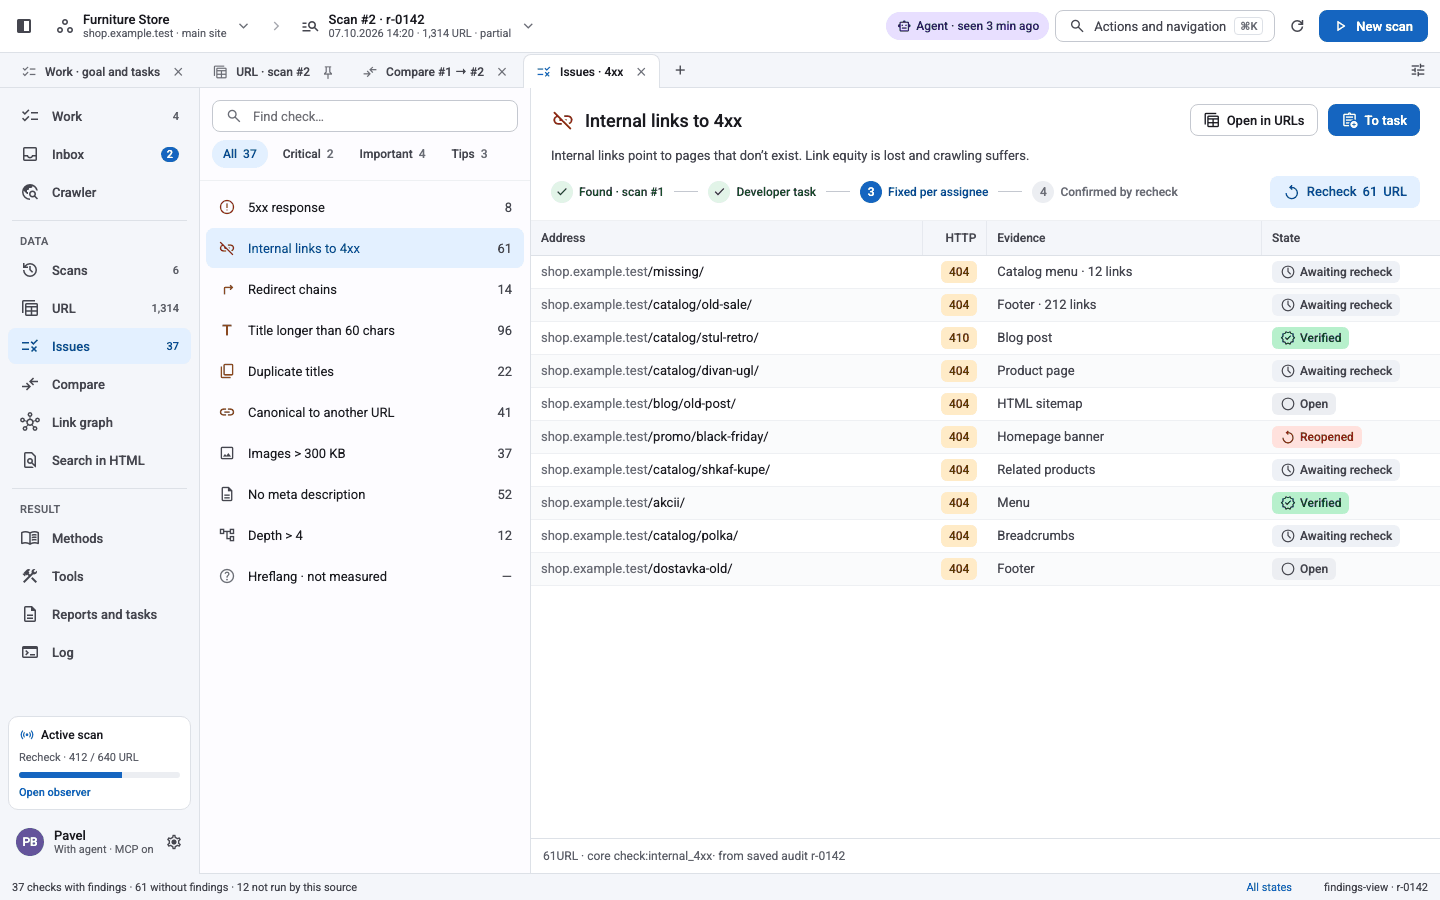
Des problèmes prouvés, pas supposés
280 contrôles sur les mêmes preuves. Chaque constat indique les URL concernées, l'endroit du problème dans la page et son statut de revérification.
- PrioriséCritique, important et conseils, avec le nombre par contrôle.
- Jamais de faux « tout est bon »Constat, exécuté sans problème, ignoré ou en échec : toujours indiqué.
- Une tâche en un clicEnvoyez un constat dans le backlog des développeurs.
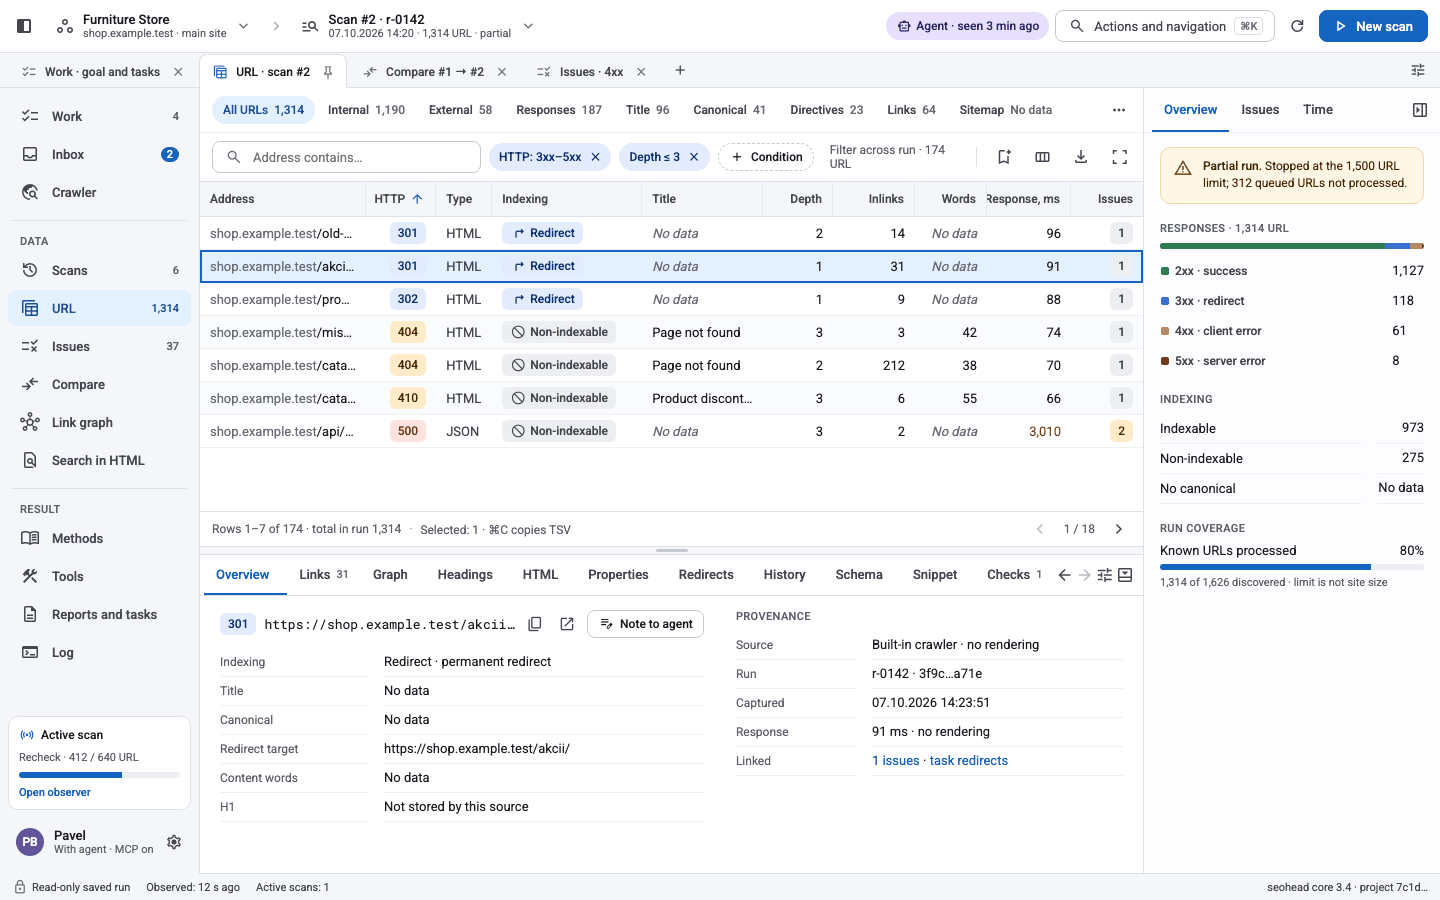
Chaque URL, chaque détail
Un tableau d'URL filtrable avec statut, indexabilité, profondeur et liens. Ouvrez une URL pour voir ses en-têtes, ses redirections, ses données structurées et son historique.
- Filtres cumulablesClasse HTTP, type, profondeur, conditions personnalisées.
- Origine des donnéesQuel scan et quelle source ont dit quoi.
- Historique de l'URLLa même URL dans tous les scans conservés.
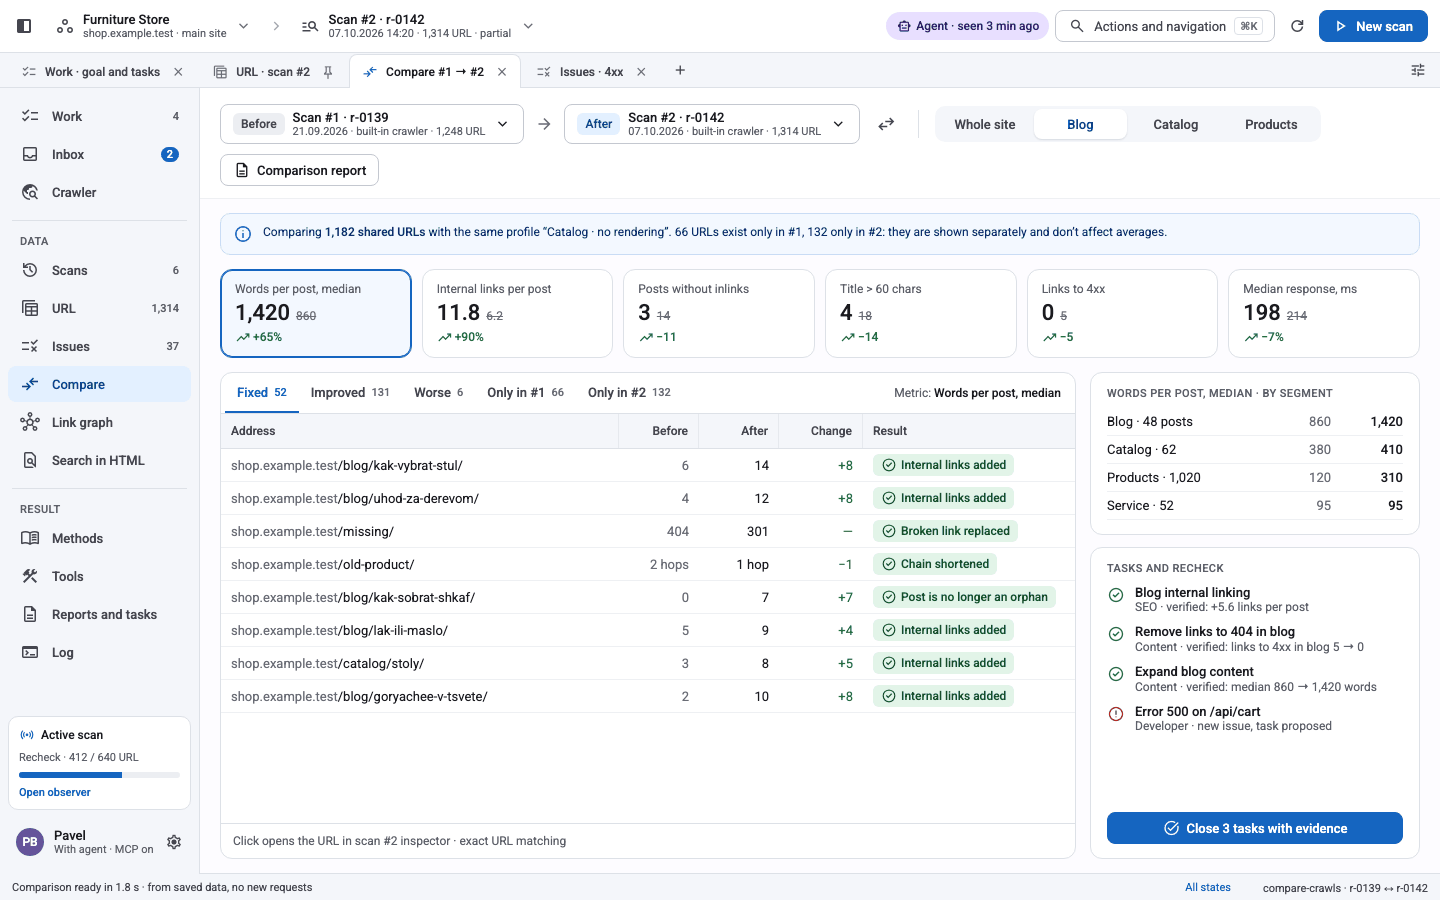
Avant et après, côte à côte
Comparez deux scans : ce qui est corrigé, ce qui s'est dégradé, ce qui est nouveau. Les tâches se ferment d'elles-mêmes quand les preuves le confirment.
- Écarts par métrique et par segmentMots, liens, statut, par section du site.
- Vérifier les correctionsRevérifications ciblées avec un registre des corrections.
- MigrationsAnciennes et nouvelles URL mises en correspondance et vérifiées.
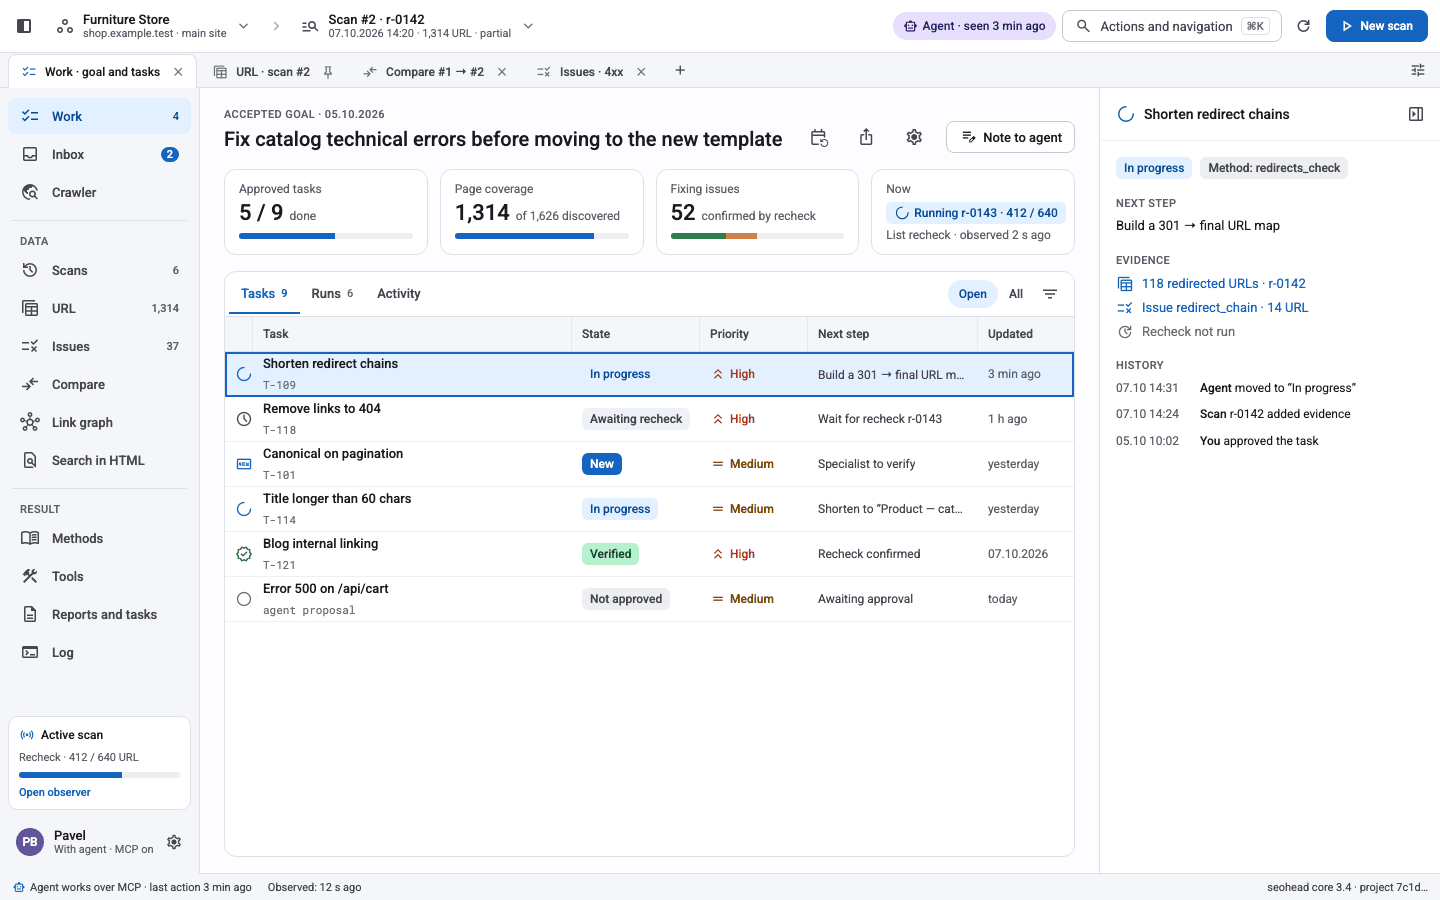
Des tâches que les développeurs peuvent appliquer
Un projet conserve l'objectif, les tâches validées, les prochaines étapes et l'historique. Équipe et agents travaillent à partir de la même liste.
- Objectif et avancementTâches validées, couverture des pages, corrections confirmées.
- Passation à l'agentUn agent reprend l'étape suivante avec les preuves.
- Historique completQui a déplacé une tâche, et pourquoi.
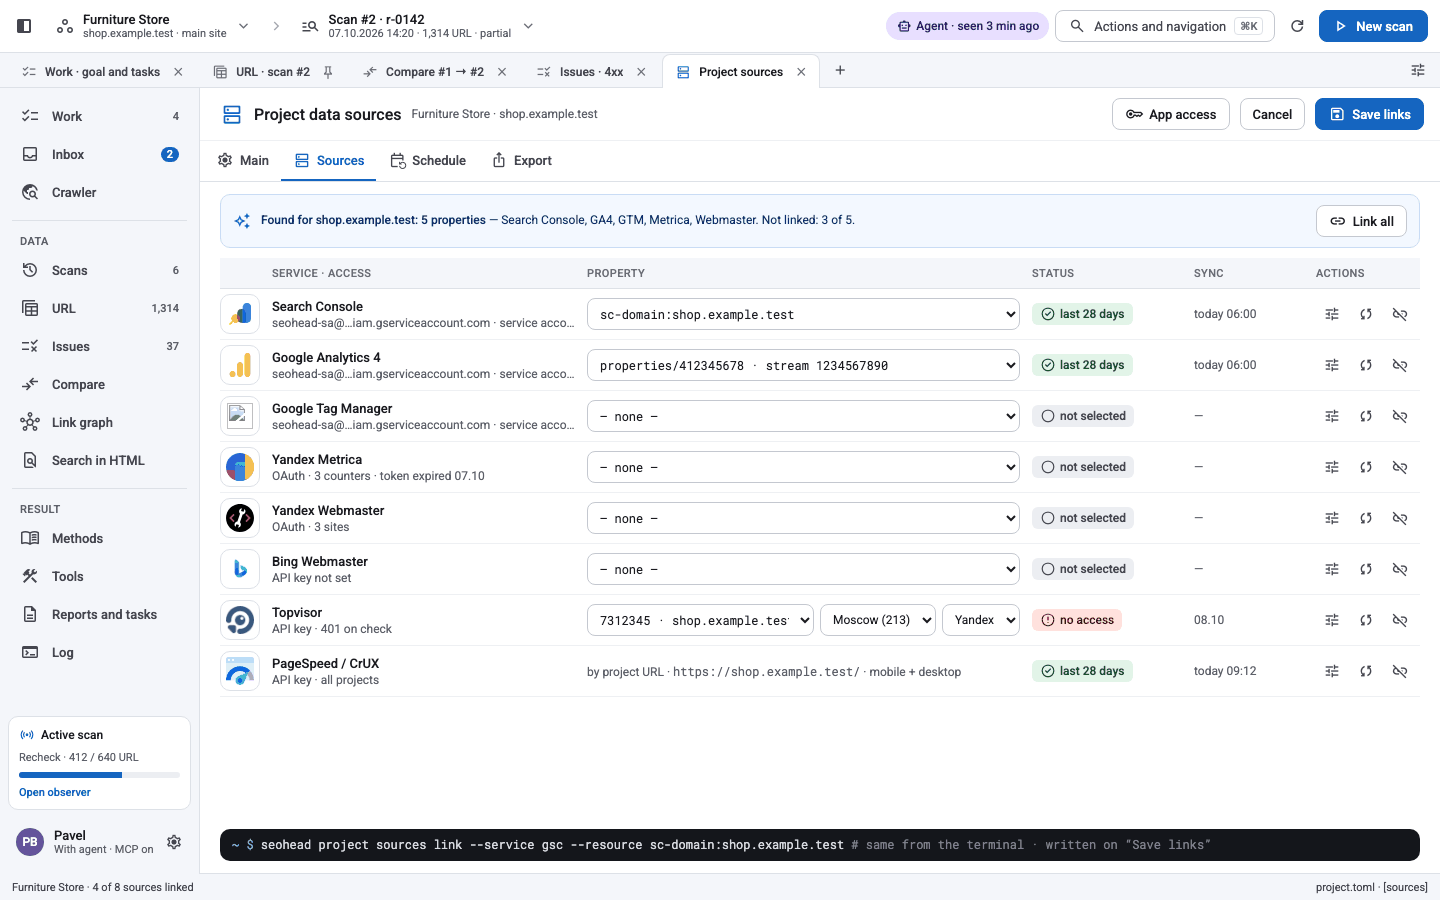
Recherche et analytics à côté du crawl
Search Console, GA4, Yandex Metrika et Webmaster, CrUX : en lecture seule, avec historique local et journal des dépenses pour les fournisseurs payants.
- Vos identifiantsLes fournisseurs payants ne tournent qu'avec votre clé et votre confirmation.
- Reliées aux URLClics et impressions à côté de chaque constat.
- Logs serveurCe que les robots crawlent vraiment.
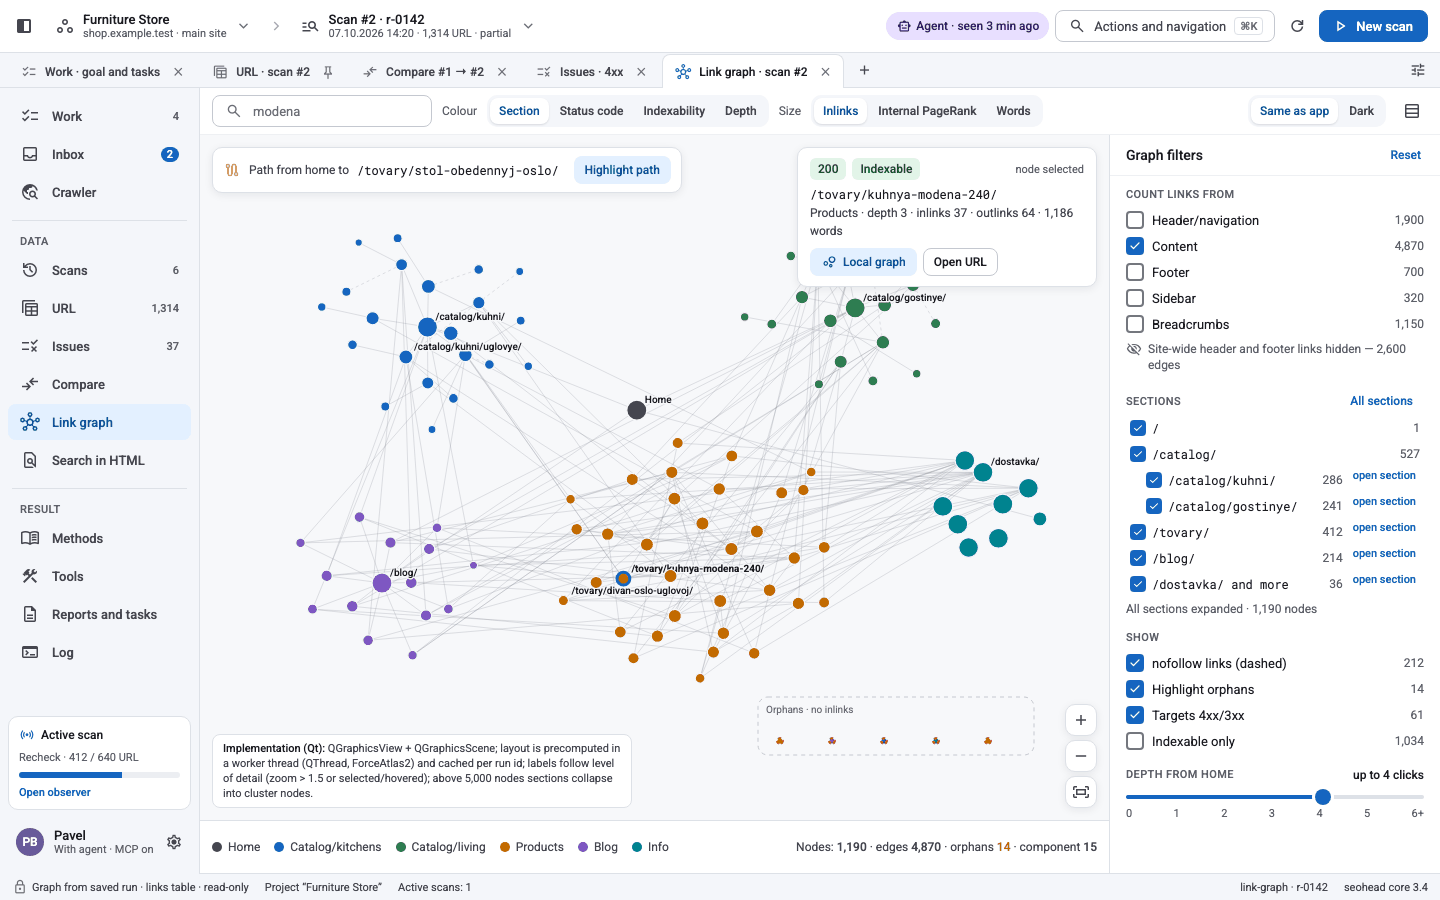
Voyez comment le site est relié
Liens internes regroupés par section, pages orphelines et chemins, à partir du même scan enregistré que celui de l'audit.
- Sections et profondeurClics depuis l'accueil, couleur par section.
- Pages orphelinesPages qu'aucun lien interne n'atteint.
- CheminsComment un robot va de A à B.
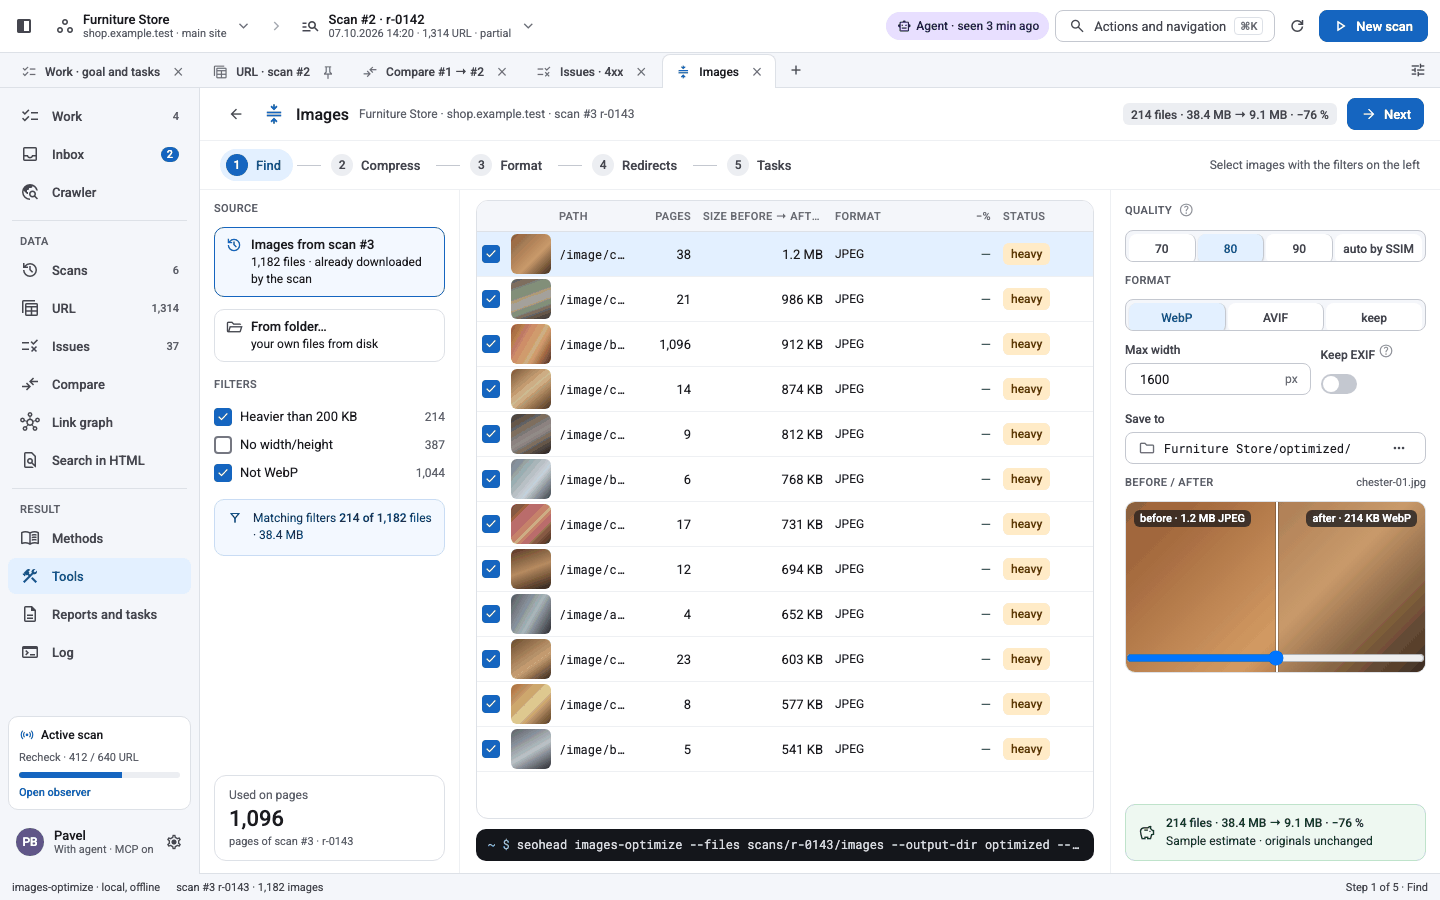
Corriger, exporter, rapporter
Chaque outil du cœur a son formulaire prêt à l'emploi. Compressez les images lourdes, générez des 301, puis exportez en XLSX, DOCX, CSV ou PDF pour vos interlocuteurs.
- Chaîne d'imagesWebP/AVIF, tailles, redirections et une tâche.
- Rapports clientsMet en forme les preuves existantes, sans jamais en inventer.
- Catalogue d'outilsRecherchez un outil et lancez-le sur le scan.
230 commandes, une seule boîte à outils
Au-delà du crawl et de l'audit : recherche de mots-clés, optimisation d'images, reconnaissance de domaine, vos propres fournisseurs de données, monitoring et export BI.
Mots-clés et noyau sémantique
Collectez, nettoyez, regroupez et enrichissez un lot de mots-clés par projet.
Optimisation d'images
Repérez les images lourdes, compressez, WebP/AVIF, 301.
Reconnaissance de domaine
Stack, CDN, miroirs, sous-domaines, historique Wayback.
Fournisseurs de données perso
Ajoutez vos CSV, XLSX ou JSON comme preuves à côté du crawl.
Monitoring
Contrôles ponctuels planifiés avec livraison en local.
Export BI
Partitions CSV typées pour Sheets et BigQuery.
Registre des corrections
Dossiers, revérifications et historique de vérification.
Voir toutes les fonctionnalités
230 commandes · 246 outils MCP · 280 contrôles
Donnez un crawler à votre agent
Connectez une fois le serveur MCP local. Claude, ou tout autre client MCP, dispose de 246 outils pour crawler, auditer et rapporter avec les mêmes preuves que l'application.
seo_crawl_siteCrawler depuis une URL de départseo_site_auditLancer les contrôles d'auditseo_compare_crawlsComparer deux scansseo_gsc_queryDonnées Search Consoleseo_report_buildXLSX, DOCX, PDFCinq corrections, par impact
- Raccourcir les chaînes de redirections sur les URL du catalogue
- Corriger les liens internes vers des pages 404
- Ajouter des balises canonical aux pages paginées
- Raccourcir les balises title de plus de 60 caractères
- Compresser les images de plus de 300 Ko
Exemple de résultat. Les tâches sont enregistrées dans le projet avec leurs preuves.
Trois commandes jusqu'au rapport
Python 3.10 ou plus récent. Clonez le dépôt, installez-le dans un environnement virtuel et lancez :
seohead crawl-site --url https://example.com \
    --max-urls 500 --scan-out ./scans/audit.sqlite
Gratuit, local et respectueux : environ deux requêtes par seconde et par hôte. La limite d'URL est un budget explicite.
seohead sf run --exports-dir ./sf-exports \
    --out ./report --tasks
Vous avez déjà des exports Screaming Frog ? Analysez-les hors ligne, sans licence et sans requête vers le site.
seohead report-build --audit ./scans/audit.sqlite \
    --format xlsx --out report.xlsx
Un tableur de travail ou un document client. Il met en forme les preuves et n'invente jamais de constat.


Obtenir SpiderHead
Lancez votre prochain audit en local
Code source, installateurs et documentation complète sont sur GitHub. Cœur sous licence MIT, application de bureau sous GPL.