
Intégration de Yandex Webmaster

Lisez les requêtes de recherche Yandex Webmaster par URL pour un hôte que vous avez vérifié, et gardez les lignes à côté de votre crawl. En lecture seule, avec un jeton OAuth, gratuit dans la limite du quota de l'API Webmaster.

Ce qu'elle fait

Requêtes par URL

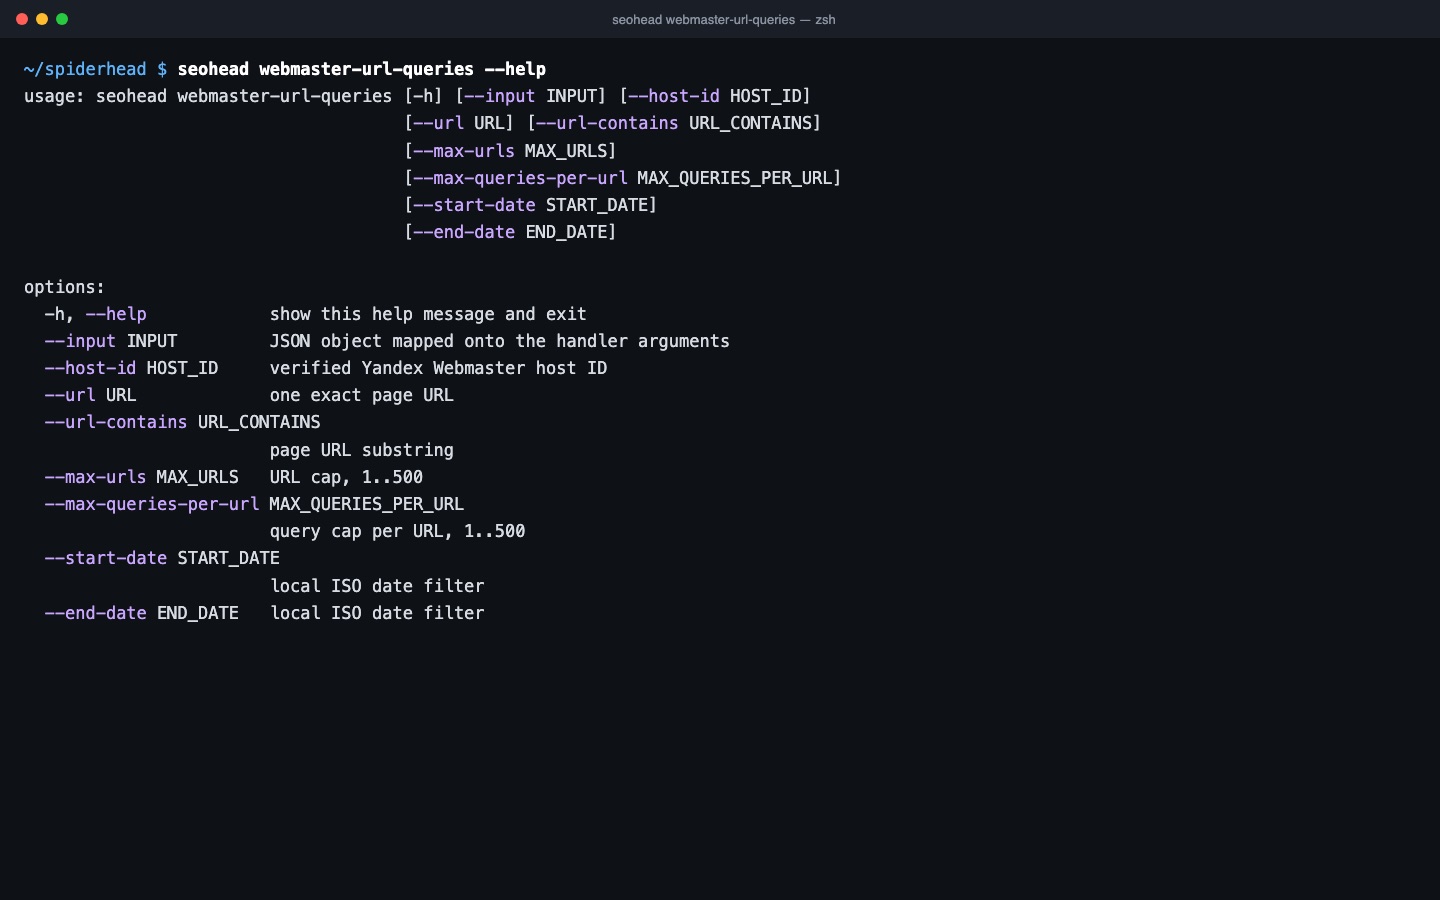
webmaster-url-queries renvoie les requêtes de recherche pour une page exacte (--url) ou pour un groupe de pages (--url-contains). Les lignes d'URL et de requêtes restent séparées. Le CTR et la position moyenne ne sont pas additionnés entre les pages.

  • --max-urls et --max-queries-per-url fixent des plafonds explicites, et la réponse indique quand elle a été tronquée.
  • --start-date et --end-date filtrent les lignes quotidiennes.
  • Yandex conserve sa propre fenêtre glissante : une plage ancienne est refusée comme indisponible.

Accès

Il vous faut l'identifiant d'un hôte vérifié dans votre compte Yandex Webmaster, ainsi qu'un jeton OAuth pour ce compte. Le jeton se place dans YANDEX_WEBMASTER_TOKEN ou dans son fichier de jeton. SpiderHead ne crée pas de comptes et ne vous connecte pas à votre place. provider-discover peut lister les hôtes visibles par le jeton.

  • La requête est en lecture seule et n'écrit rien chez Yandex.
  • Sans identifiant d'hôte, la commande ne s'exécute pas.
  • SpiderHead vérifie l'hôte dans votre compte avant de demander les requêtes.

À conserver avec le crawl

sources-sync peut stocker les données quotidiennes de Webmaster dans un historique SQLite local, afin de constituer des données au-delà de ce que l'API renvoie à un moment donné. evidence-join rattache les lignes indexées par URL à un crawl et liste les candidats orphelins à examiner. Aucune des deux étapes ne modifie le crawl.

  • Utilisez --source webmaster ou webmaster_history avec sources-sync.
  • Les URL présentes uniquement dans le crawl, uniquement en externe ou sans clé exploitable restent nommées et séparées.
  • Les lignes stockées peuvent contenir des requêtes et des URL  : gardez ces fichiers hors de Git.

Trois étapes, un seul scan enregistré

  1. Pointer l'outil vers un hôte vérifié

    La commande demande un identifiant d'hôte Yandex Webmaster pour un site que vous avez vérifié, ainsi que le jeton OAuth configuré localement. Sans identifiant d'hôte, elle ne s'exécute pas.

  2. Récupérer les requêtes d'une URL

    Demandez une page exacte avec --url, ou un groupe avec --url-contains. Les plafonds sont explicites  : --max-urls et --max-queries-per-url, avec --start-date et --end-date facultatifs.

  3. Joindre les lignes à votre crawl

    Gardez séparées les lignes d'URL et celles de requêtes. L'étape evidence-join rattache les lignes indexées par URL à un crawl et liste les candidats orphelins à examiner, sans modifier le crawl.

Une seule commande

bash
seohead webmaster-url-queries --url https://example.com/

Commencez par installer : guide d'installation. Chaque commande fonctionne aussi comme outil MCP pour les agents IA.

Ce qu'il vous faut

  • Un identifiant d'hôte vérifié dans Yandex Webmaster (--host-id)
  • Un jeton OAuth Yandex donnant accès à cet hôte
  • Une URL exacte ou une partie d'URL

Limites

  • Seuls les hôtes vérifiés dans votre propre compte peuvent être lus.
  • Yandex conserve les données de requêtes sur une fenêtre glissante limitée. Une plage de dates qui se termine il y a plus de 14 jours est refusée.
  • Les résultats sont plafonnés, et un résultat tronqué est signalé comme tel.
  • Les autres opérations Webmaster, comme l'indexation et les diagnostics, passent par provider-collect et non par cette commande.

Questions

Faut-il un hôte vérifié dans Yandex Webmaster ?
Oui. La commande prend un identifiant d'hôte vérifié (--host-id) et un jeton OAuth configuré sur votre machine. SpiderHead ne crée pas de comptes et ne vous connecte pas à votre place.
Cela modifie-t-il quelque chose chez Yandex ou sur mon site ?
Non. C'est une requête en lecture seule. Elle renvoie les statistiques de requêtes pour les URL que vous indiquez et n'écrit rien ni chez Yandex ni sur le site.
Les clics et les positions sont-ils additionnés entre les pages ?
Non. Chaque URL conserve ses propres lignes de requêtes. Le CTR et la position moyenne ne sont pas additionnés entre les pages, et la réponse indique les plafonds appliqués.
Combien cela coûte-t-il ?
Rien au-delà du quota de l'API Yandex Webmaster. L'outil indique que le fournisseur est gratuit dans cette limite.
Puis-je conserver un historique au-delà de la fenêtre de l'API ?
Oui, avec sources-sync. Il stocke les données quotidiennes de Webmaster dans un historique SQLite local, pour constituer des données au fil du temps. Il ne peut pas récupérer les jours que Yandex ne renvoie plus.
Puis-je l'utiliser depuis un assistant IA ?
Oui. Le serveur MCP local expose la même opération sous le nom seo_webmaster_url_queries.