
Application SEO de bureau

Une application de bureau native écrite en Python avec PyQt5, qui s’appuie sur le même cœur que la CLI et le serveur MCP. Elle ouvre les mêmes projets locaux et les mêmes scans conservés, sans vue web ni compte hébergé.

Ce qu'elle fait

Tout dans une seule fenêtre

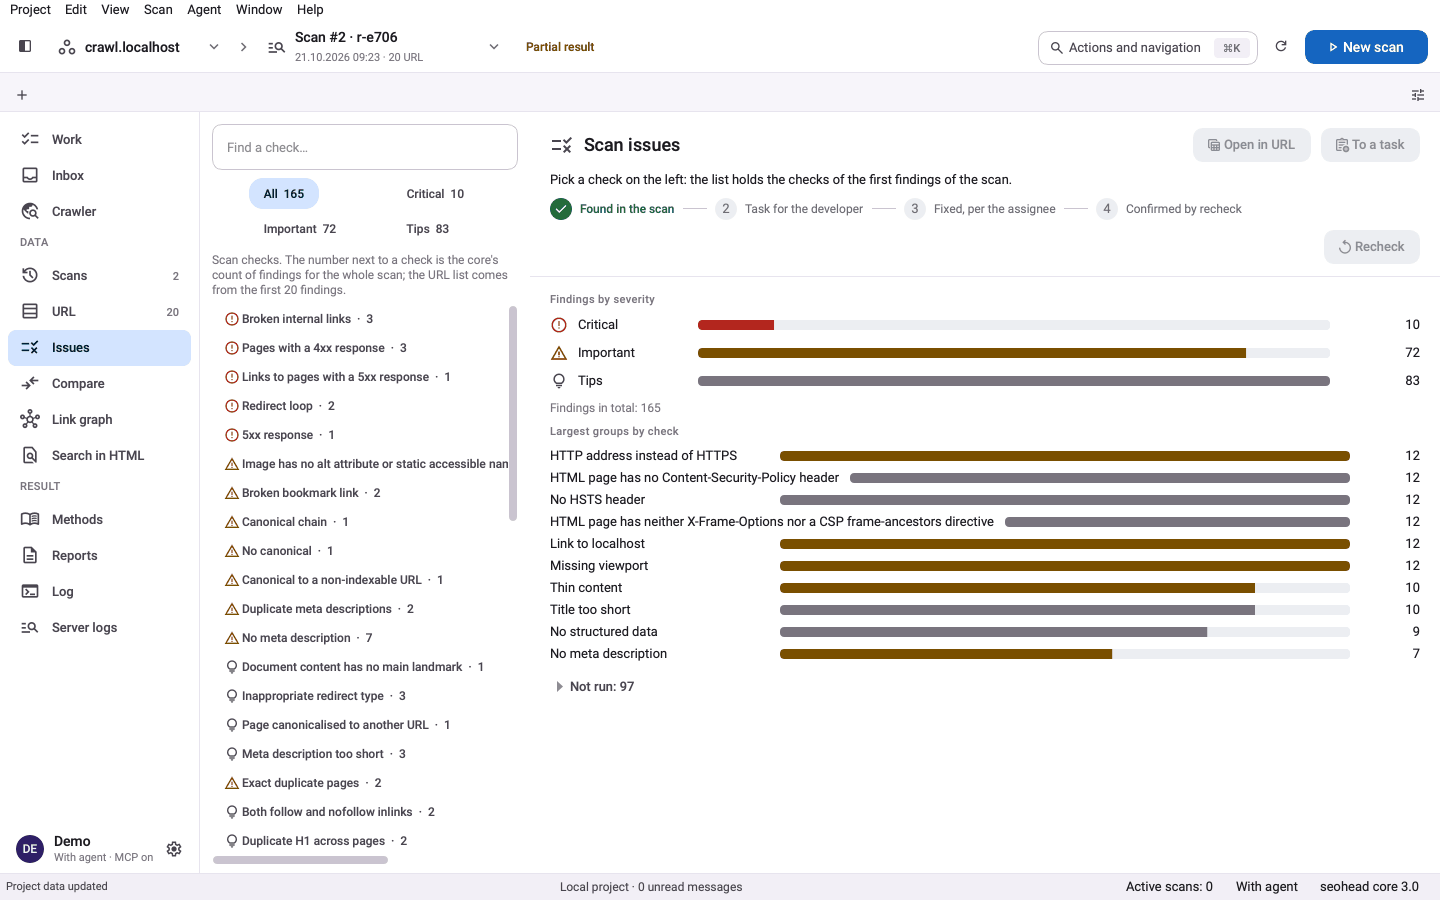
L’application a deux modes. Projets sert au travail avec un agent IA : objectifs, tâches, boîte de réception, scans, comparaisons avant/après et rapports. Crawler sert aux vérifications rapides : saisissez une URL et cliquez sur Start, sans projet. Les deux modes lisent le registre d’audit, si bien qu’un constat a la même signification que dans la CLI.

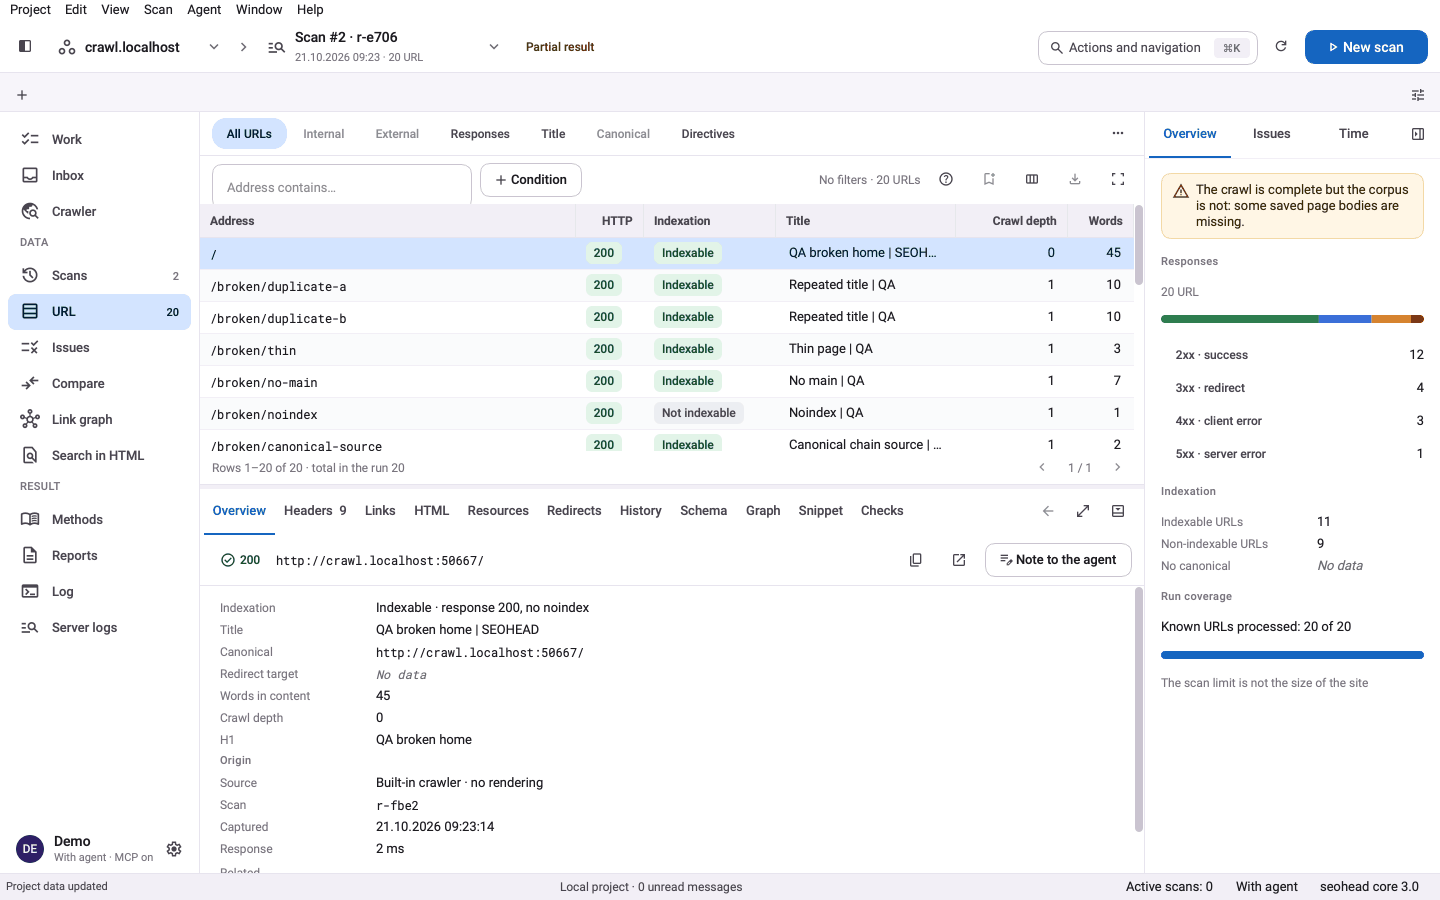
  • Tableau des URL avec filtres, détails par URL, graphe de liens et comparaison de scans
  • Import de journaux de serveur, procédures pas à pas par méthode, générateur de redirections et éditeur de tâches de snippets
  • Thèmes clair, sombre et à contraste élevé
  • Interface en anglais et en russe

Installation et plateformes

Aujourd’hui, l’application se lance depuis les sources sur tout système doté de Python 3.11 ou plus récent, et elle est livrée avec le cœur compatible. Un paquet d’installation macOS peut être créé : il place SpiderHead.app dans Applications et un script d’enveloppe seohead dans /usr/local/bin. Les paquets Windows et Linux sont préparés dans les scripts de compilation, mais n’ont pas encore fait l’objet d’une validation sur une machine vierge.

  • Sources : installez dans un environnement virtuel, puis lancez seohead-desktop
  • macOS : un paquet PyInstaller et un .pkg, signés localement, non notariés
  • Windows et Linux : les scripts de compilation existent, mais l’exécution du paquet n’est pas encore vérifiée
  • L’application ne revient jamais à un seohead global sur votre machine

Même cœur, mêmes fichiers

L’application n’embarque pas son propre crawler. Elle appelle le cœur par les mêmes contrats CLI et MCP local qu’utilisent les agents : un scan lancé dans le terminal apparaît dans l’application, et inversement. Un agent peut aussi piloter la fenêtre, mais seulement après que vous l’avez autorisé au contrôle local.

  • Les scans lancés par l’application s’exécutent comme des processus séparés, avec une file d’attente
  • Le commutateur du serveur MCP dans l’application est partagé avec seohead mcp
  • Le contrôle local via seohead-desktop-agent reste désactivé tant que vous ne l’activez pas

Trois étapes, un seul scan enregistré

  1. Ouvrez un projet local

    Indiquez à l’application un dossier de projet. Elle ouvre les mêmes projets locaux et les mêmes scans conservés que la CLI.

  2. Crawlez ou ouvrez un scan enregistré

    Lancez un crawl depuis l’application ou ouvrez un scan existant, puis lisez les résultats dans une seule fenêtre.

  3. Traitez les problèmes

    Chaque constat provient du registre d’audit. Filtrez le tableau des URL, ouvrez une URL et consultez ses détails.

Contrôles de cette fonctionnalité

ContrôleSignificationGravitéPreuve
REDIRECT_LOOPLa chaîne de redirections revient à une URL déjà visitéeCriticalParcours de redirection
TITLE_MISSINGLa page n’a pas d’élément titleCriticalURL de la page
REDIRECT_CHAINPlus d’un saut de redirection avant l’URL finaleImportantChaque saut avec son statut
CANONICAL_MISSINGUne page indexable n’a pas d’URL canoniqueImportantURL de la page
ORPHAN_PAGEAucun lien interne ne pointe vers la pageImportantURL de la page
HREFLANG_MISSING_RETURN_LINKL’hreflang d’une autre page pointe ici, mais cette page ne renvoie pas le lienImportantURL de la page et ensemble hreflang

Une seule commande

bash
seohead-desktop --project ./shop

Commencez par installer : guide d'installation. Chaque commande fonctionne aussi comme outil MCP pour les agents IA.

Ce qu'il vous faut

  • Un dossier de projet local existant, ouvert en lecture seule, ou simplement une URL en mode Crawler
  • Python 3.11 ou plus récent, pour un lancement depuis les sources
  • Le cœur compatible, installé avec l’application ou inclus dans le paquet macOS
  • Une licence Screaming Frog CLI n’est pas nécessaire pour le crawl natif

Limites

  • macOS est la seule plateforme avec un test de fumée sur paquet compilé. La validation à l’exécution sous Windows et Linux reste ouverte.
  • Les programmes d’installation précompilés ne sont pas encore publiés. Vous les compilez depuis le dépôt.
  • La performance de la fenêtre sur un million d’URL n’est pas garantie, et les très petites tailles de fenêtre sont encore en cours de vérification.
  • Le guide d’aide intégré utilise actuellement des libellés en russe.

Questions

Faut-il la ligne de commande pour l’utiliser ?
Pour l’installer depuis les sources, oui : quelques commandes dans un terminal. Ensuite, l’application se pilote à la souris. Le paquet macOS propose aussi, au premier lancement, un bouton Installer l’outil en ligne de commande, qui ne demande les droits administrateur qu’après votre clic.
Faut-il un compte, ou mes données sont-elles envoyées à un serveur ?
Aucun compte hébergé n’existe. Projets et scans restent sur votre machine, dans le même stockage local qu’utilisent la CLI et le serveur MCP.
L’application affiche-t-elle les mêmes résultats que la CLI ?
Oui. L’application s’appuie sur le même cœur et ouvre les mêmes scans conservés : un scan réalisé dans le terminal apparaît donc dans l’application.
Un crawl modifie-t-il mon site ?
Non. Les crawls sont des requêtes en lecture seule. Les règles de redirection générées sont des fichiers que vous relisez et déployez vous-même.
Sur quels systèmes fonctionne-t-elle ?
Elle est écrite avec Qt, et l’installation depuis les sources est prévue pour macOS, Windows et Linux. Seul macOS dispose pour l’instant d’un paquet compilé ayant passé un test de fumée. Sous Linux, Qt peut nécessiter des bibliothèques d’affichage système supplémentaires.
Quelle est la licence ?
L’application de bureau est sous GPL-3.0-or-later, car PyQt5 l’impose. La boîte à outils cœur du même dépôt est sous licence MIT.