
Intégration de Google Search Console

Interrogez Search Console, archivez ses données dans un fichier SQLite local et rattachez-les aux preuves du crawl, URL par URL. L’accès est en lecture seule et utilise vos propres identifiants Google.

Ce qu'elle fait

Connexion en lecture seule

SpiderHead n’utilise que le périmètre en lecture seule de Search Console. Il existe trois façons de fournir l’accès, à vous de choisir. provider-verify vérifie ensuite séparément l’accès à la propriété, car une connexion valide ne prouve pas que vous pouvez lire un site donné.

  • Consentement via le navigateur, avec votre propre client OAuth de bureau, par le script scripts/gsc_oauth_login.py. Le refresh token est stocké dans votre dossier de configuration local.
  • Un compte de service Google que vous ajoutez comme utilisateur de la propriété.
  • Un jeton d’accès prêt à l’emploi, dans le réglage GSC_ACCESS_TOKEN.

Historique local

gsc-archive met en file d’attente une plage de dates et la récupère par petits lots reprenables, dans un fichier SQLite que vous nommez. sources-sync conserve l’historique quotidien par projet et ne récupère que les jours manquants. Rien ne part vers un service hébergé, et les fichiers sont créés avec des droits réservés au seul propriétaire.

  • Les dates sont incluses et utilisent l’heure du Pacifique.
  • Les différentes granularités (totaux, pages, requêtes) forment des jeux de données distincts, et ne sont jamais additionnées.
  • Les archives peuvent contenir des requêtes et des URL  : gardez-les hors des rapports publics et de Git.

Inspection d’URL

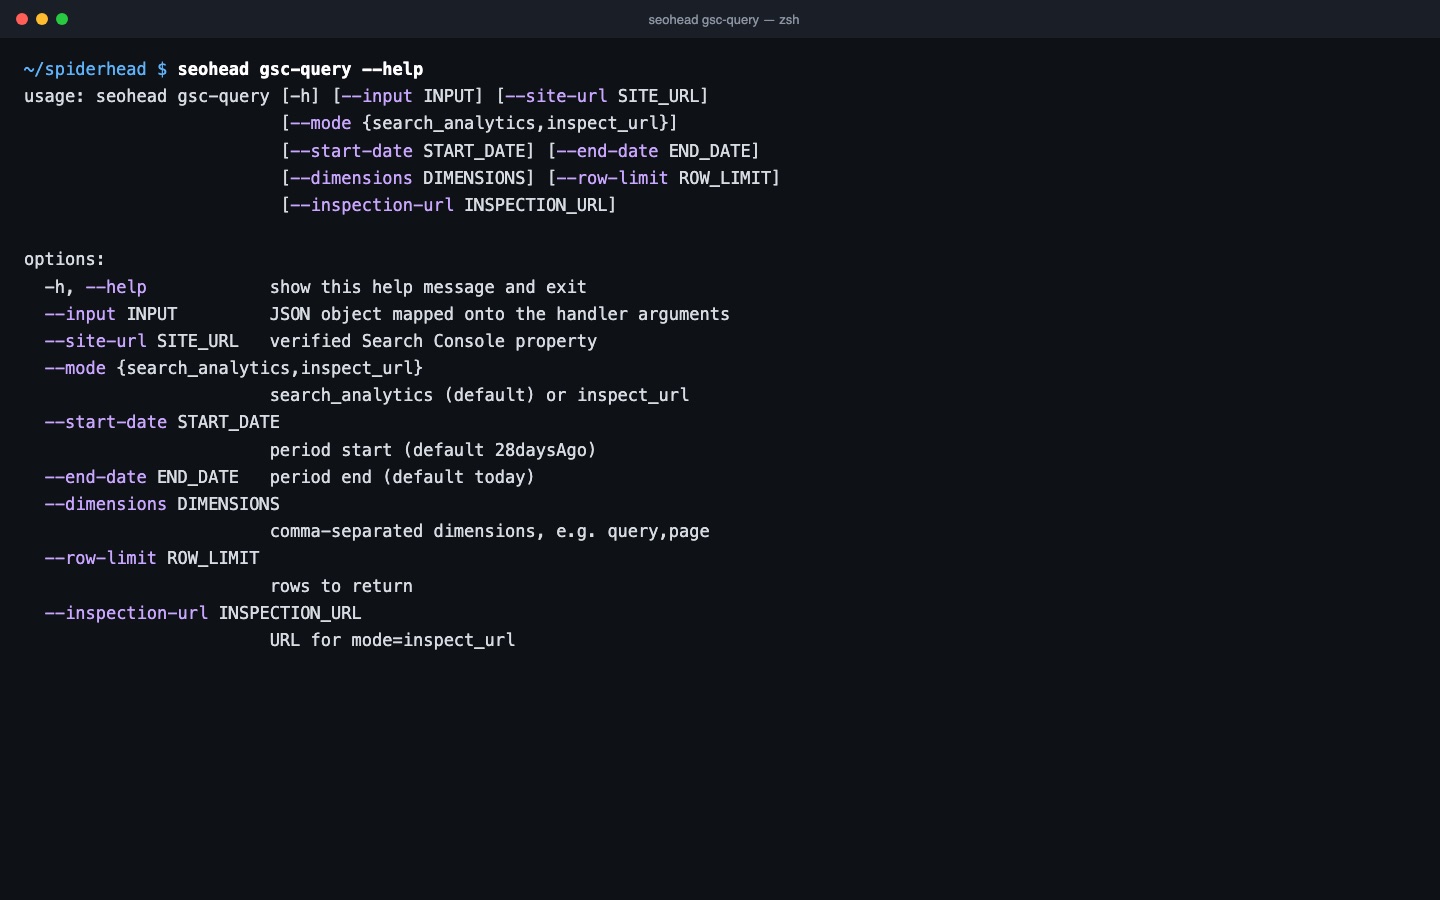
gsc-query avec le mode inspect_url renvoie le verdict d’indexation de Google lui-même, pour une seule URL. Ce verdict reste sur sa propre ligne, à l’écart des contrôles du crawler. Dans sf run, --gsc-inspect inspecte un échantillon déterministe d’au plus 50 URL, avec des limites de débit locales de 600 par minute et de 2 000 par période de 24 heures.

  • Seule la version indexée d’une page peut être inspectée.
  • Les quotas de Google par site s’appliquent en plus des limites locales.
  • Les URL non inspectées restent inconnues.

Trois étapes, un seul scan enregistré

  1. Connectez un seul accès en lecture seule

    Connectez un accès Google en lecture seule pour une propriété dont vous êtes propriétaire. Vous pouvez vérifier son statut à tout moment.

  2. Archivez-la localement

    Mettez une plage de dates en file d’attente et exécutez-la par lots bornés et de petite taille, dans un fichier SQLite sur votre machine. Les relances ne récupèrent que les jours manquants.

  3. Rattachez-la à chaque URL

    Les clics, impressions, positions et CTR se rattachent aux pages du crawl par URL. Le verdict d’indexation de Google pour une URL reste sur sa propre ligne.

Une seule commande

bash
seohead gsc-query --site-url sc-domain:example.com --start-date 2026-09-01 --end-date 2026-09-30

Commencez par installer : guide d'installation. Chaque commande fonctionne aussi comme outil MCP pour les agents IA.

Ce qu'il vous faut

  • Une propriété Search Console dont vous êtes propriétaire ou que vous pouvez lire (propriété de domaine ou préfixe d’URL)
  • Un seul identifiant : consentement OAuth, compte de service ou jeton d’accès (tous en lecture seule)
  • Une plage de dates, dans les 16 derniers mois environ
  • Facultatif : un crawl ou un scan auquel rattacher les lignes

Limites

  • Google conserve environ 16 mois de données.
  • Les requêtes anonymisées sont omises, et les lignes peuvent être plafonnées. Un job plafonné est signalé et n’est pas un export complet.
  • Les clics, impressions, CTR et positions ne sont pas additionnés d’un niveau de granularité à l’autre.
  • Le verdict d’indexation ne couvre que les URL que vous inspectez.

Questions

Mes données partent-elles vers un service hébergé ?
Non. Les requêtes partent directement de votre machine vers l’API Google Search Console, avec votre propre accès. Les résultats sont stockés dans des fichiers SQLite locaux, avec des droits réservés au seul propriétaire. Gardez ces fichiers hors des rapports publics et de Git, car ils peuvent contenir des requêtes et des URL.
L’outil peut-il modifier ma propriété Search Console ?
Non. L’accès est en lecture seule. L’outil ne lit que les données d’analyse de la recherche et les résultats de l’inspection d’URL.
Jusqu’où remontent les données ?
Environ 16 mois, soit l’historique disponible chez Google. Les dates sont incluses et utilisent l’heure du Pacifique.
Pourquoi certaines requêtes semblent-elles manquer ?
Google omet les requêtes anonymisées et peut plafonner le nombre de lignes renvoyées. Un job plafonné n’est pas un export complet, et l’outil le signale comme tel.
Le verdict d’indexation de Google remplace-t-il les contrôles du crawl ?
Non. Le verdict de Google pour une URL provient de gsc-query en mode inspect_url. Les contrôles propres au crawler (métadonnées, en-têtes, robots, redirections, données structurées, rendu) s’exécutent avec inspect-url. Les deux résultats restent séparés.
Combien cela coûte-t-il, et que stocke-t-on en local ?
L’API est gratuite dans les quotas de Google. SpiderHead stocke votre refresh token, ou le chemin de votre compte de service, dans votre dossier de configuration local, ainsi que les fichiers d’archive et d’historique à l’emplacement que vous indiquez. Aucun jeton n’est écrit dans les fichiers d’historique.