Yandex Wordstat
collect · synonymsFréquence de base, affinages et requêtes similaires via l'API Yandex Cloud. Clé d'API et ID de dossier ; quota horaire.
Collectez, nettoyez, clusterisez et enrichissez le pool de mots-clés d'un projet : Wordstat, clusters de SERP, fréquence exacte, plan hors ligne avant tout appel payant.
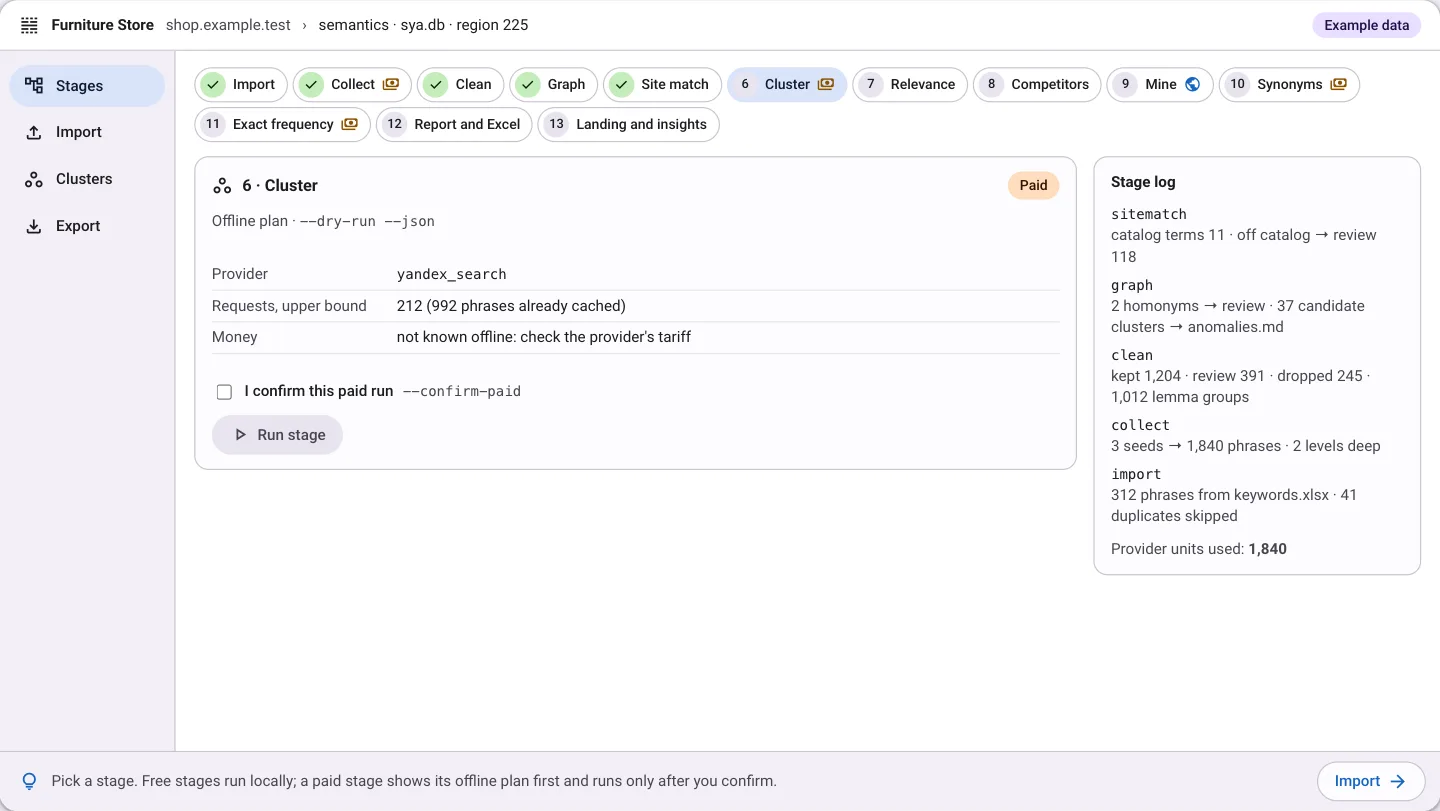
Chaque étape modifie un statut et en consigne la raison : une requête n'est jamais supprimée et chaque décision reste explicable. Les étapes gratuites s'intercalent entre les étapes payantes, ce qui vous laisse vérifier le pool avant d'acheter la réponse suivante.
Apportez ce que vous avez déjà : un CSV ou une feuille d'un XLSX. Associez query, frequency, group, subgroup, URL et comment, puis choisissez add, update ou replace. L'aperçu montre les lignes nouvelles, existantes et en doublon avant toute écriture.
phrasesDéveloppe vos requêtes de départ par région et redéveloppe les requêtes fortes jusqu'à la profondeur définie. La file est dédupliquée, et --resume reprend une exécution interrompue sans redemander la même requête.
phrases, expansions, provenanceApplique les filtres du projet (intention, mots vides, motifs informationnels), signale les valeurs aberrantes de fréquence et regroupe les requêtes par lemme. Une requête avec des impressions ou des positions observées n'est jamais écartée par les règles de fréquence.
status, route, lemma groupConstruit un graphe de mots du pool. Les candidats homonymes vont en revue et les clusters candidats arrivent dans anomalies.md, avant que vous payiez quoi que ce soit d'autre.
anomalies.mdUne requête n'a sa place dans le noyau que si le site la propose. Les requêtes sans aucun terme de catalog.txt partent en revue comme hors catalogue.
review listRécupère un top 10 par requête et le met en cache : une nouvelle exécution ne paie que les nouvelles requêtes. Les requêtes qui partagent des pages forment un cluster ; --method louvain regroupe les résultats en cache pour casser les longues chaînes.
SERP cache, clusters, landing candidatesSi aucun site de votre type listé dans vendors.txt n'apparaît dans le top 10 d'une requête, le sujet est probablement hors périmètre. La requête part en revue ; rien n'est supprimé.
review listLit les résultats en cache : quels domaines tiennent vos clusters et quels mots ils emploient dans les titres. Les candidats vont dans synonyms.txt.
competitors.md, synonyms.txtOuvre les pages de concurrents les plus fréquentes dans les résultats collectés et lit leur title, leur description, leur H1 et leurs premiers titres H2. Les expressions thématiques de deux ou trois mots vont dans synonyms.txt.
competitor_mining.md, synonyms.txtVérifie les candidats de synonyms.txt. Seules les requêtes qui ont de la demande rejoignent le noyau ; ensuite, collect --resume fait grandir le pool à partir d'elles.
checked phrasesAchète la fréquence exacte !W une seule fois par groupe de lemmes, à la fin, quand le pool a cessé de bouger. Au-delà du seuil de budget du projet, --yes est nécessaire.
exact frequency, task receiptsreport.md et clusters.csv pour la lecture, un classeur XLSX (Summary, Core, Info, Clusters, Rejected) pour le client, pool.csv et pool.json pour d'autres outils.
report.md, XLSX, CSV, JSONAprès le lancement, choisissez la page cible de chaque cluster parmi des candidates mesurées, puis lisez les signaux hebdomadaires par cluster à partir de vos données locales Search Console, Webmaster et Metrika et transformez ceux que vous retenez en tâches de checklist.
landing, weekly signals, tasksLe noyau ne se collecte pas en une fois. Les concurrents et l'analyse des pages alimentent de nouveaux candidats, les synonymes les vérifient, la collecte reprend et le clustering repasse. La fréquence exacte s'achète en dernier.
collectclean · graph · site matchclustercompetitors · minesynonymscollect --resumeexact, oncereportLe pipeline de collecte s'appuie sur les données Yandex. La demande Google, le suivi de positions et les analyses de recherche sont des commandes distinctes du toolkit, qui fonctionnent à côté du noyau.
collect · synonymsFréquence de base, affinages et requêtes similaires via l'API Yandex Cloud. Clé d'API et ID de dossier ; quota horaire.
clusterUn top 10 par requête et par région, mis en cache avec son heure de récupération et sa région. Uniquement le point d'accès asynchrone.
exactLa fréquence exacte !W que l'API Wordstat ne fournit pas. Facturée à la création de la tâche ; le task_id est conservé, donc un résultat en timeout est récupéré de nouveau, pas racheté.
google-keywordsVolume de recherche Google, concurrence et expansion de requêtes de départ. Sandbox par défaut.
keywords-expand · keywords-seasonality · regions-treeDéveloppez une requête, lisez sa demande mois par mois, parcourez l'arbre des régions (l'arbre est gratuit).
topvisor-readLit les projets, les mots-clés et l'historique de positions enregistré depuis votre compte existant. Les vérifications payantes ne peuvent pas être lancées depuis le toolkit.
semantics insightsSignaux hebdomadaires par cluster à partir de données que le toolkit a déjà synchronisées en local. L'étape insights elle-même n'effectue aucun appel à un fournisseur.
Chaque étape payante a un plan hors ligne : la région, le moteur, la source des requêtes et un plafond de requêtes ou de tâches. Un plan ne crée aucun client de fournisseur.
--dry-run --json affiche le plan. L'exécution elle-même exige --confirm-paid, même si l'estimation est nulle.
Les tentatives Wordstat, les récupérations de SERP et les tâches Arsenkin sont réservées avant l'appel. Une requête ambiguë n'est jamais renvoyée automatiquement.
Les SERP en cache et les reçus payants survivent à un remplacement du pool : relancer le clustering ne paie donc que les nouvelles requêtes.
Chaque débit arrive dans spend-report avec le projet sémantique et l'étape auxquels il se rattache.
Quand le prix d'un fournisseur ne peut pas être établi hors ligne, le plan le dit au lieu d'inventer un chiffre.
Capturée depuis le projet d'exemple synthétique livré avec le toolkit. Ses requêtes sont en russe, comme la demande sur Yandex, et ses fréquences sont inventées. Aucun appel payant n'a été effectué.
$ seohead semantics clean --project ./core
$ seohead semantics graph --project ./core
$ seohead semantics sitematch --project ./core
clean: kept=34 review=4 dropped=3 | lemma groups=41 (median base=720, outlier>36000)
graph: homonyms=0, to review=0, candidate clusters=7 -> anomalies.md
sitematch: catalog terms=11 | off-catalog->review=8 | kept and matching the site=26$ seohead semantics cluster --project ./core --dry-run
"mode": "estimate", "stage": "cluster", "paid": true,
"provider": "yandex_search",
"request_estimate": {"unit": "requests", "count": 26, "kind": "upper_bound"},
"money_estimate": null,
"money_unavailable_reason": "provider pricing is not available from this offline preflight",
"paid_calls_made": 0$ seohead semantics status --project ./core
dropped=3 | kept=26 | review=12 | _total=41 | _exact=0 | _expanded=0 | _clusters=0
provider units: {'yandex_requests': 0, 'arsenkin': 0}
next: seohead semantics exact --project ./core$ seohead semantics export --project ./core --scope no-landing --dry-run
"mode": "preview", "scope": "no-landing", "rows": 41,
"planned_files": ["core/semantics/pool.csv", "core/semantics/pool.json"]seohead semantics status --project ./my-coreCommencez par installer : guide d'installation. Chaque commande fonctionne aussi comme outil MCP pour les agents IA.
Dix outils MCP exposent les mêmes étapes et les mêmes lectures. Un appel payant renvoie le plan et exige confirm_paid=true pour lancer le travail.
seo_semantics_statusCompteurs, unités du fournisseur et étape suivanteseo_semantics_runÉtapes gratuitesseo_semantics_minePages de concurrents, sans quota fournisseurseo_semantics_paidÉtapes payantes : le plan d'abord, puis confirm_paid=trueseo_semantics_clustersListe paginée des clustersseo_semantics_cluster_showUn cluster avec ses preuves de page cibleseo_semantics_cluster_queriesRequêtes d'un cluster avec le top 10 conservéseo_semantics_set_landingAttribuer ou retirer une page cibleseo_semantics_insightsSignaux hebdomadaires par cluster et par sourceseo_semantics_insights_tasksSignaux retenus transformés en tâches de checklist