
Crawler avec rendu JavaScript

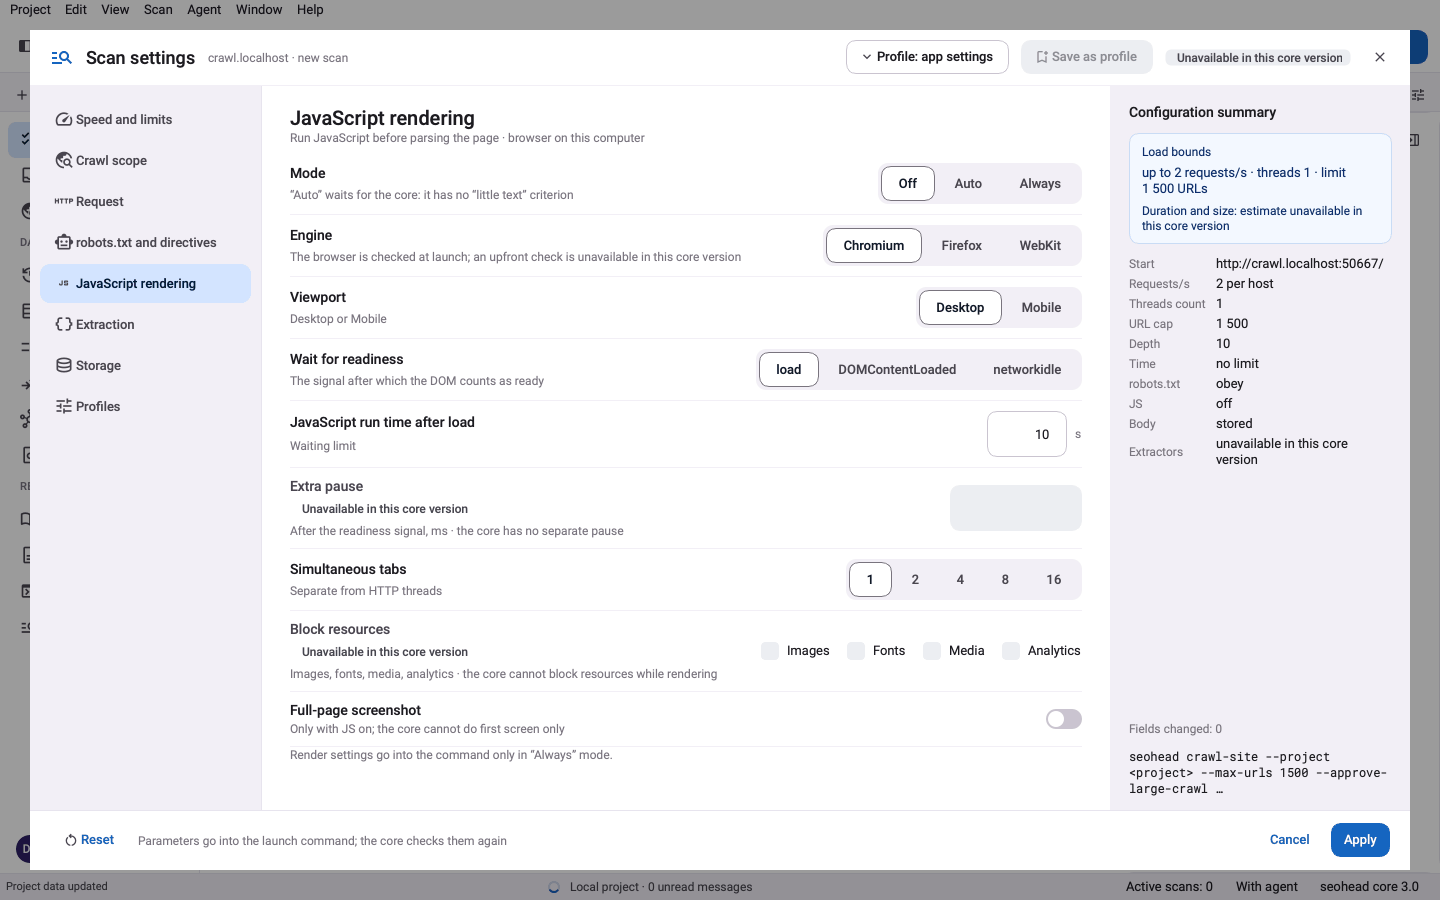
SpiderHead peut afficher les pages dans un navigateur sans interface (headless) via Playwright et conserver côte à côte le HTML brut et le DOM rendu, pour voir ce qui n’existe qu’après l’exécution des scripts. Le rendu est facultatif et désactivé par défaut.

Ce qu'elle fait

HTML brut et HTML rendu

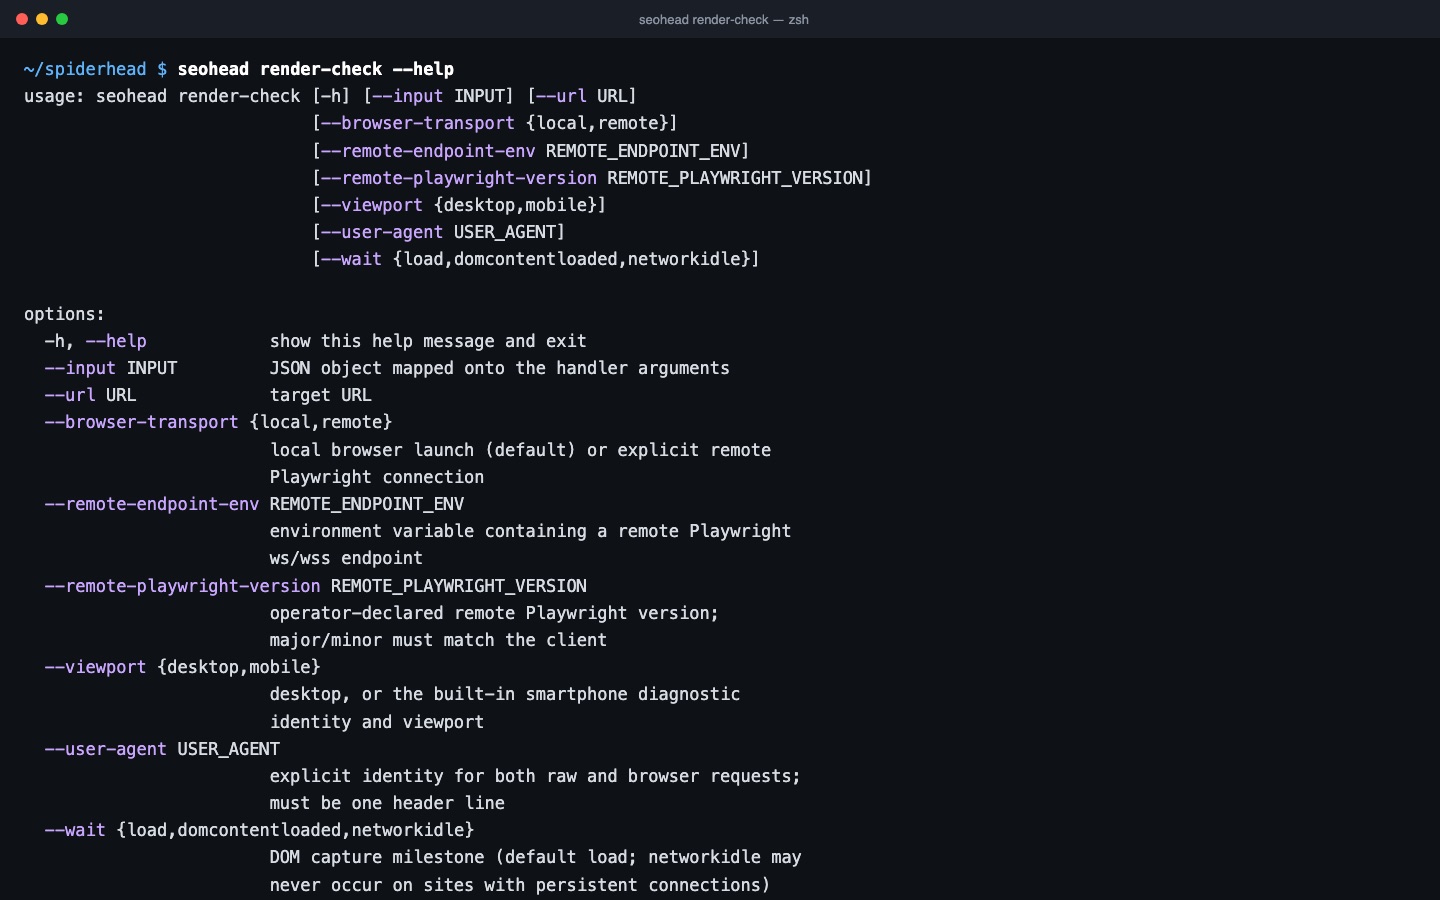
render-check charge une URL deux fois : telle que le serveur l’envoie, puis dans un navigateur après exécution des scripts. Il compare les titres, les balises canonical, les liens et les contenus qui apparaissent ou disparaissent. Dans un crawl, réglez rendering.mode sur js : SpiderHead effectue alors un rendu sélectif. Par défaut, il teste quelques URL par motif de gabarit et rend les motifs qui diffèrent, jusqu’à 30 pages.

  • Les routes rendues sont enregistrées comme preuves ; leur crawl est une option distincte à activer (rendering.rendered_links.crawl)
  • Temps de chargement issus d’une seule exécution, et non Core Web Vitals terrain

Seulement si vous en avez besoin

Le navigateur est une extension facultative : le crawl de base n’en a pas besoin. Installez le groupe render et un navigateur, et prévoyez environ 150 Mo pour Chromium. Lancez d’abord render-check sur une page par gabarit, et ne rendez tout le site que si les pages brutes et rendues diffèrent.

  • pip install -e ".[render]"
  • python -m playwright install chromium

Trois étapes, un seul scan enregistré

  1. Récupérer le HTML brut et le DOM rendu

    render-check charge l’URL deux fois : une fois telle que le serveur l’envoie, et une fois dans Chromium via Playwright après exécution des scripts.

  2. Comparer ce qui n’apparaît qu’après les scripts

    La comparaison compte les mots et les liens qui n’existent qu’après le rendu, et signale une coquille d’application vide, comme un simple point de montage #root ou #app.

  3. Lire les erreurs de console et les temps de chargement

    Lorsque rendering.artifacts.console_errors est activé (il est désactivé par défaut), les erreurs de script consignées pendant le rendu sont signalées sous JS_CONSOLE_ERRORS. Les temps de chargement proviennent d’une seule exécution locale : ce sont des données de laboratoire, et non des Core Web Vitals terrain.

Contrôles de cette fonctionnalité

ContrôleSignificationGravitéPreuve
JS_CONSOLE_ERRORSLa page a consigné des erreurs JavaScript dans la console du navigateur pendant le renduImportantTexte de l’erreur de console issu de l’exécution rendue
ROBOTS_BLOCKS_RESOURCESrobots.txt bloque des fichiers .js, .css ou _next/static nécessaires au renduTipRègle de robots.txt qui correspond au chemin de la ressource (issue de robots-check)
AJAX_CRAWLING_SCHEME_URLUne page, ou un lien qu’elle contient, utilise le schéma AJAX obsolète #! ou _escaped_fragment_TipL’URL qui utilise ce schéma
Aussi dans le registre des contrôles
RENDER_RESOURCE_BLOCKEDNOINDEX_ONLY_IN_RAW_HTMLCANONICAL_ONLY_IN_RENDERED_HTMLPAGE_TITLE_ONLY_IN_RENDERED_HTML

Une seule commande

bash
seohead render-check --url https://example.com/

Commencez par installer : guide d'installation. Chaque commande fonctionne aussi comme outil MCP pour les agents IA.

Ce qu'il vous faut

  • Une URL de page pour render-check
  • L’extra render et un navigateur Playwright installé
  • Pour un crawl avec rendu : une configuration de crawl avec rendering.mode réglé sur js

Limites

  • Les temps de chargement proviennent d’une seule exécution locale et ne sont pas des données terrain
  • Le navigateur refuse de s’exécuter en root
  • Les actions sur la page sont déclaratives (clic, défilement, attente, extraction) : vous ne pouvez pas fournir votre propre JavaScript
  • networkidle peut ne jamais se produire sur les sites à connexions persistantes

Questions

Ai-je besoin d’un navigateur pour chaque crawl ?
Non. Le crawl de base fonctionne sans navigateur. Chromium est une extension facultative pour render-check et les crawls avec rendu : pip install -e ".[render]", puis python -m playwright install chromium (environ 150 Mo).
Un contrôle de rendu modifie-t-il quelque chose sur mon site ?
Non. Il charge l’URL et ses ressources comme le ferait un navigateur, sans rien modifier. Les actions sur la page, comme les clics, ne s’exécutent que si vous les configurez dans un crawl.
Les mesures de vitesse sont-elles des Core Web Vitals ?
Non. Les LCP, CLS et temps de chargement proviennent d’une seule exécution sur une seule machine. Ce sont des mesures de laboratoire, et non des données terrain issues du Chrome UX Report.
Puis-je faire le rendu en mode smartphone ?
Oui. Ajoutez --viewport mobile pour utiliser l’identité smartphone et la fenêtre d’affichage intégrées. Utilisez --user-agent pour une identité personnalisée.
Que faire si la page ne finit jamais de charger ?
Utilisez --wait domcontentloaded. La valeur par défaut est load. networkidle ne peut jamais se produire sur les sites à connexions persistantes : évitez-la sur ces sites.