
Analyseur d’exports Screaming Frog

Indiquez à SpiderHead un dossier d’exports CSV ou XLSX de Screaming Frog, et obtenez un audit et une liste de tâches priorisée. L’analyse par défaut se fait hors ligne : ni installation de Screaming Frog, ni licence, ni requête vers le site ne sont nécessaires.

Ce qu'elle fait

Deux modes

Le mode B analyse les exports que vous avez déjà faits dans Screaming Frog. Il lit les fichiers sur votre disque et ne nécessite aucune licence. Le mode A pilote une CLI Screaming Frog installée séparément et sous licence, la laisse crawler, puis analyse le résultat.

  • Mode B : sf run avec --exports-dir, entièrement hors ligne.
  • Mode A : --crawl URL, --crawl-list FILE ou --load-crawl FILE.seospider, avec votre propre licence Screaming Frog.
  • sf doctor vérifie la configuration locale avant de commencer.

Ce que vous obtenez

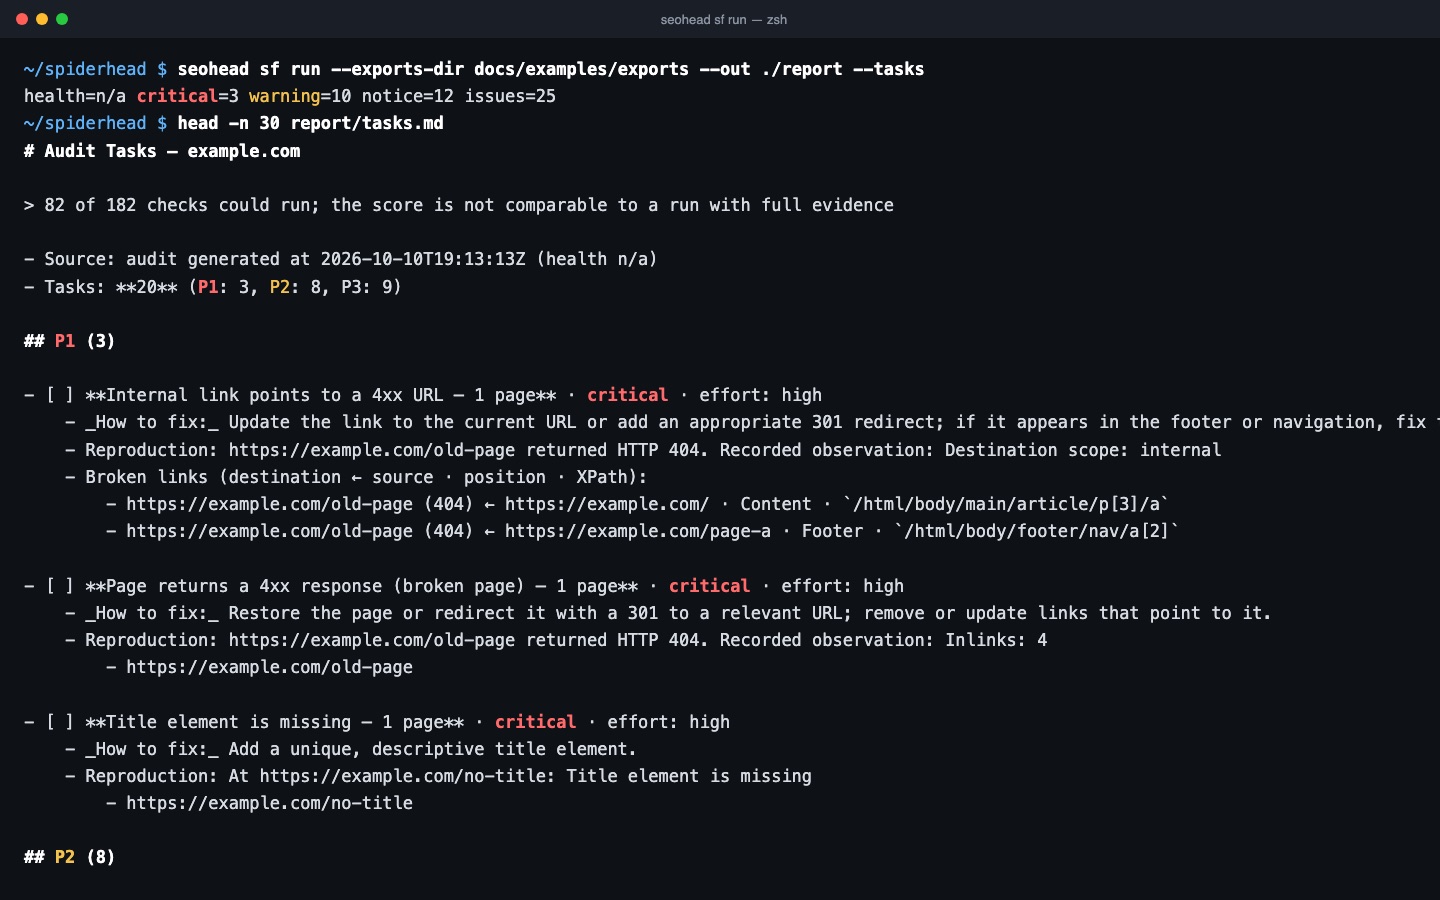
Le dossier de rapport contient audit.json et audit.md. Avec --tasks, il contient aussi tasks.json et tasks.md, un backlog priorisé. Chaque tâche indique les étapes de reproduction, la position du lien dans la page et la correction proposée.

  • --format json,md choisit les formats du rapport.
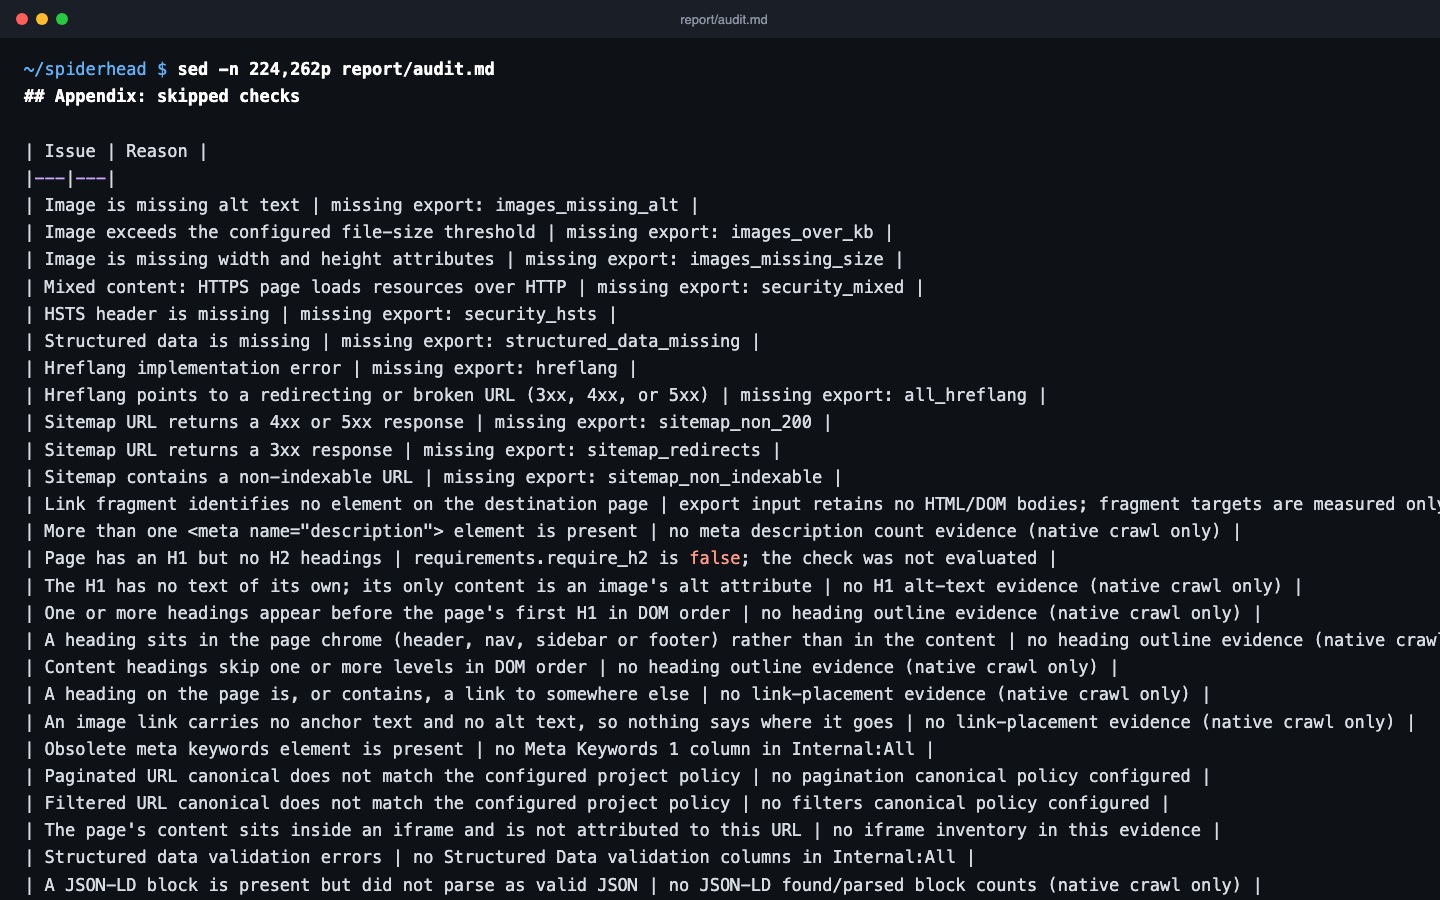
  • Un contrôle dont l’export est absent est marqué comme ignoré, avec une raison, et n’est jamais compté comme réussi.
  • --fail-on critical ou warning définit un code de sortie non nul pour la CI.

Ajouter les données de recherche et de trafic

Avec --project DIR, sf run rattache aux pages auditées le dernier historique complet de 28 jours de Search Console, GA4 et Metrika conservé dans ce projet. Pendant cette opération, aucun fournisseur n’est contacté. Une option distincte, activée sur demande, --gsc-inspect, lit le statut d’indexation donné par Google pour un échantillon d’au plus 50 URL.

  • Les constats des fournisseurs gardent leur source dans audit.json et audit.md.
  • Les liaisons manquantes et les lectures plafonnées restent indisponibles ou partielles.
  • Les constats négatifs, comme les pages orphelines, exigent une couverture complète des fournisseurs et un crawl complet.

Trois étapes, un seul scan enregistré

  1. Indiquez-lui vos exports

    Donnez-lui un dossier d’exports CSV ou XLSX de Screaming Frog. L’analyse se fait hors ligne et n’envoie aucune requête au site.

  2. Lancez le registre des contrôles

    Le même registre évalue chaque export. Un contrôle sans donnée est marqué comme ignoré, avec une raison, et n’est jamais compté comme réussi.

  3. Obtenez un backlog priorisé

    audit.json, audit.md et tasks.md/tasks.json listent chaque problème avec les étapes de reproduction, la position du lien et la correction.

Contrôles de cette fonctionnalité

ContrôleSignificationGravitéPreuve
BROKEN_PAGE_4XXLa page renvoie une réponse 4xxCriticalExport Response Codes 4xx
BROKEN_INTERNAL_LINKUn lien interne pointe vers une URL en 4xxCriticalExport Inlinks : page source et position du lien
REDIRECT_LOOPLa chaîne de redirections revient vers une URL déjà visitéeCriticalRapport Redirect Chains
TITLE_MISSINGLa page n’a pas de balise titleCriticalDéduit des données de titres de page
REDIRECT_CHAINDeux redirections ou plus avant l’URL finaleImportantRapport Redirect Chains
DESC_DUPLICATELa même meta description sur plusieurs pagesImportantDéduit des données de meta description
TITLE_TOO_LONGLa balise title dépasse le seuil de longueur configuréTipDéduit des données de titres de page

Une seule commande

bash
seohead sf run --exports-dir ./exports --out ./report --tasks

Commencez par installer : guide d'installation. Chaque commande fonctionne aussi comme outil MCP pour les agents IA.

Ce qu'il vous faut

  • Un dossier d’exports CSV ou XLSX de Screaming Frog (--exports-dir)
  • Facultatif : un config.json pour les seuils (--config)
  • Mode A uniquement : une CLI Screaming Frog sous licence, et une URL de départ, une liste d’URL ou un fichier .seospider enregistré

Limites

  • L’audit ne voit que ce que contiennent les exports. Un contrôle sans son export est ignoré.
  • Le mode A exige une licence Screaming Frog que SpiderHead ne fournit pas et n’inclut pas.
  • Les vérifications réseau des données sitemap et robots n’ont lieu que si vous passez --live-recheck.
  • Les corrections proposées ne sont pas appliquées à votre site.

Questions

Faut-il installer Screaming Frog pour l’utiliser ?
Pas pour l’analyse. Le mode B lit les exports que vous avez déjà faits dans Screaming Frog et n’envoie aucune requête au site. Screaming Frog et une licence ne sont nécessaires que pour le mode A, dans lequel SpiderHead pilote la CLI de Screaming Frog pour crawler. SpiderHead lui-même n’a besoin ni de clé ni de compte.
Que se passe-t-il pour un contrôle sans donnée ?
Il est marqué comme ignoré, avec la raison. Il n’est jamais présenté comme un contrôle réussi  : 0 problème signifie donc toujours que le contrôle a bien été exécuté.
Modifie-t-il quelque chose sur mon site ou dans mes fichiers ?
Non. Il lit les exports et écrit les fichiers de rapport dans le dossier de sortie que vous indiquez. Les corrections proposées sont à appliquer par vos soins.
Quelle est la différence entre audit.md et tasks.md ?
audit.md liste les constats. tasks.md est le backlog priorisé, avec les étapes de reproduction, la position des liens et une correction pour chaque problème. Passez --tasks pour l’obtenir.
Puis-je l’utiliser en CI ?
Oui. Passez --fail-on critical (ou warning)  : la commande renvoie un code de sortie non nul lorsque cette gravité est présente.
Puis-je analyser les exports d’un autre crawler ?
Pas avec sf run, qui attend des exports de Screaming Frog. Pour les autres outils, crawl-import lit un lot de fichiers CSV que vous faites correspondre à l’aide d’un manifeste. Il produit un document de crawl tiers distinct, et non un audit.