
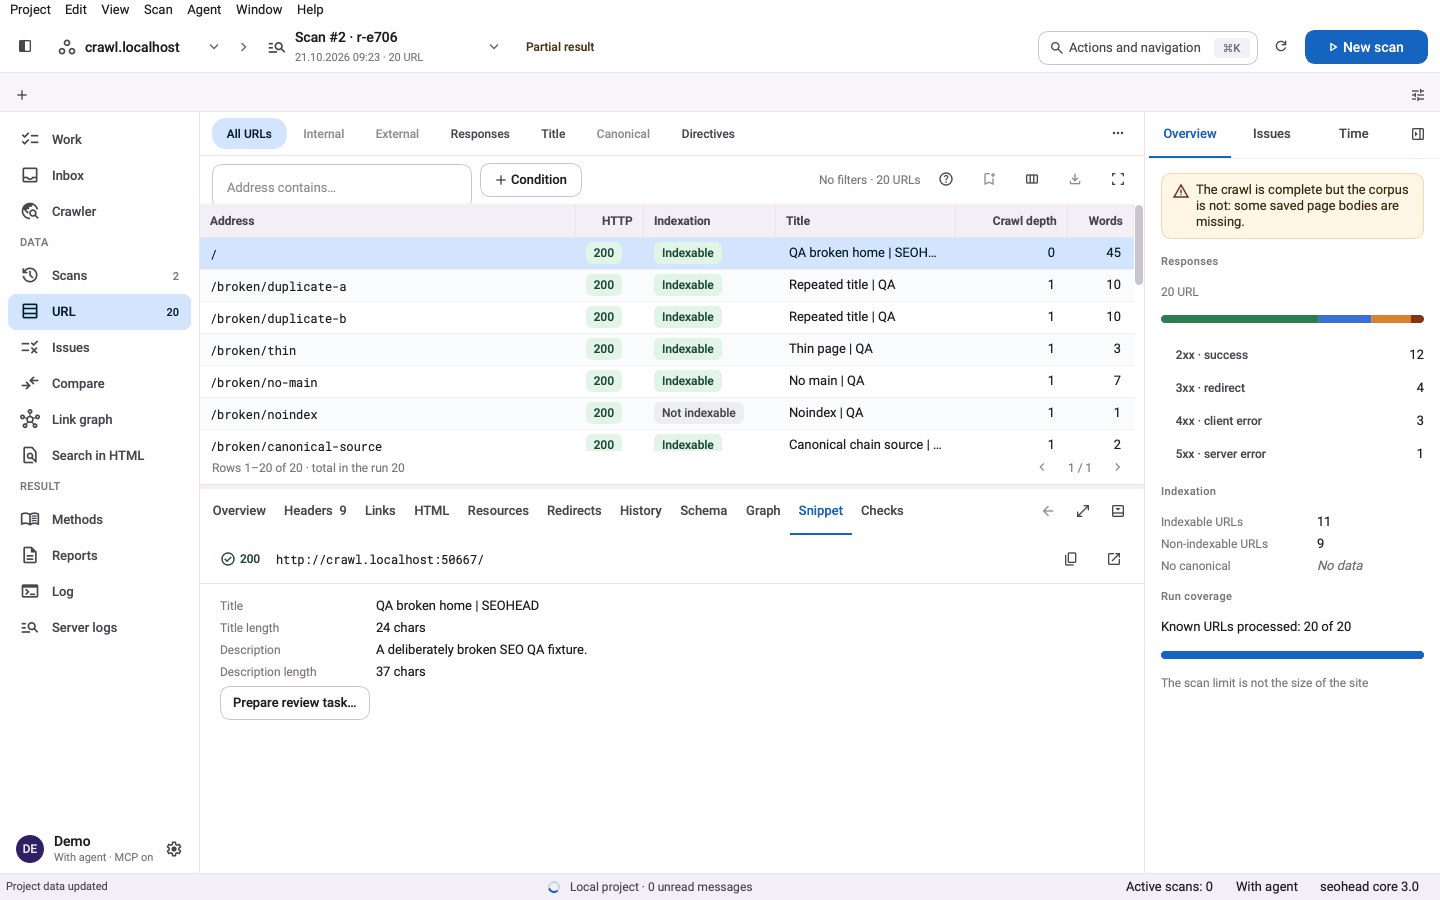
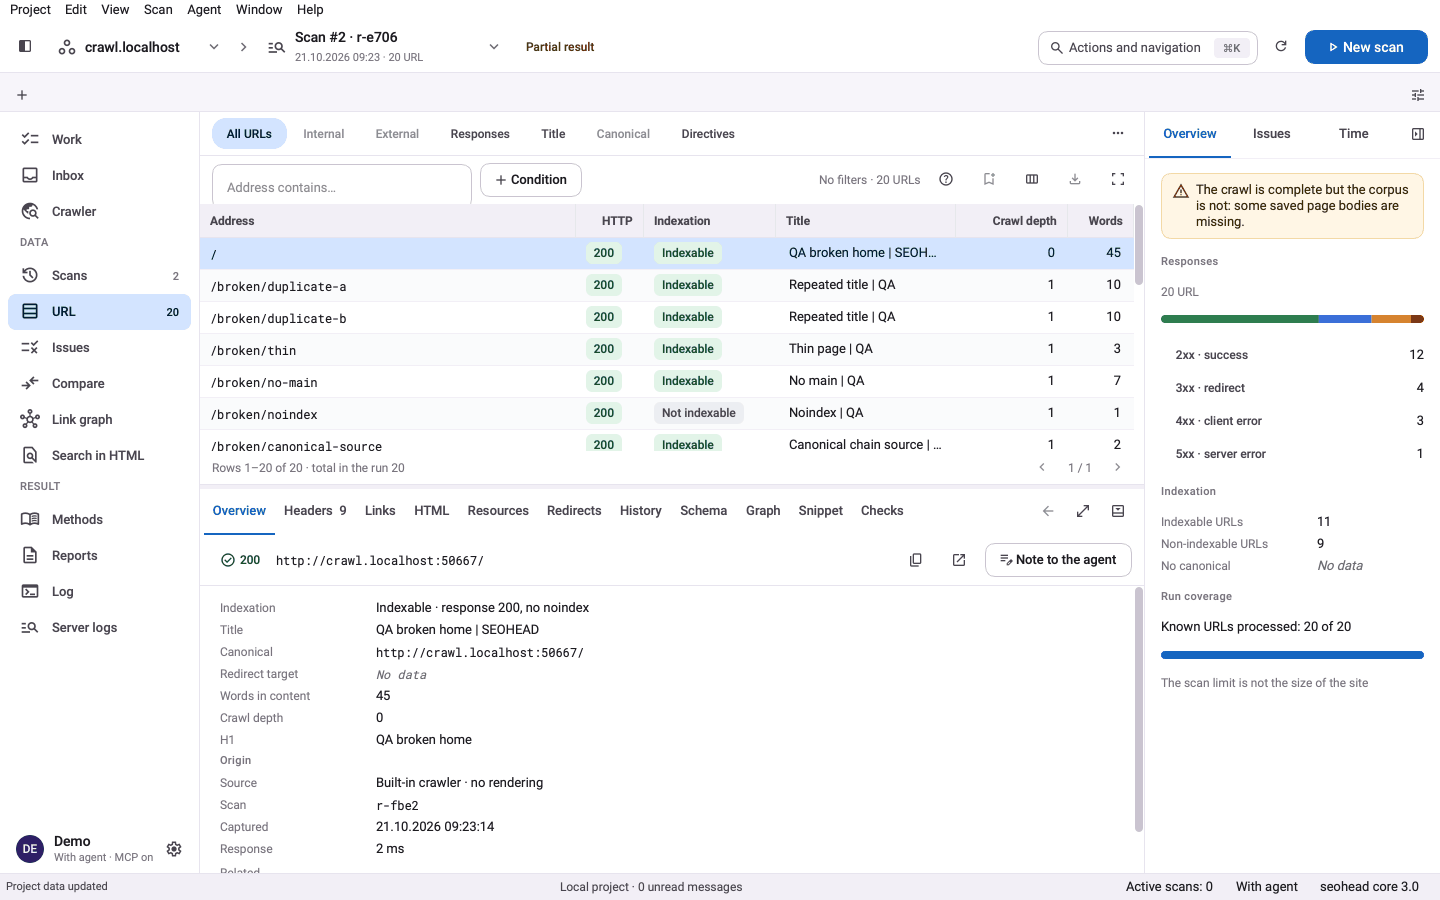
Contrôle des balises title et meta description

Repérez les titles et meta descriptions absents, en double, multiples, trop longs ou trop courts, les titles identiques au H1, les titles templatés, ainsi que les balises title ou description placées hors du head.

Ce qu'elle fait

Page par page et à l'échelle du site

Les contrôles de longueur s'exécutent page par page, selon des seuils que vous pouvez modifier. Les doublons et les titles templatés demandent le crawl complet, car une seule page ne peut pas montrer que son title est partagé. Les éléments title multiples et les descriptions multiples sur une même page sont aussi signalés.

  • Titles absents, multiples, trop longs ou trop courts
  • Descriptions absentes, multiples, en double, trop longues ou trop courtes
  • Title identique au H1
  • Title ou description placé hors du head

Seuils par défaut

Par défaut, un title est signalé au-delà de 60 caractères ou de 561 pixels, et en deçà de 30 caractères. Une description est signalée au-delà de 160 caractères ou de 985 pixels, et en deçà de 70 caractères. Tous les seuils sont modifiables dans la configuration de l'audit.

  • Title : de 30 à 60 caractères, jusqu'à 561 px
  • Description : de 70 à 160 caractères, jusqu'à 985 px
  • Seuils configurables

Brouillons

meta-description-drafts prépare ou valide un lot de descriptions pour les pages qui n'en ont pas. Les brouillons viennent d'un agent IA que vous lancez, et non de SpiderHead. L'outil les confronte à la page, signale les problèmes à relire et conserve des points de contrôle en local. Il peut exporter le résultat en JSON ou en CSV.

  • N'appelle jamais de modèle lui-même
  • N'écrit jamais dans un CMS
  • Export local en JSON et CSV

Trois étapes, un seul scan enregistré

  1. Lire le title et la description d'une page

    parse renvoie, en une seule commande, le title et la meta description d'une URL.

  2. Les comparer à l'échelle du site

    Les titles ou descriptions en double et templatés n'apparaissent que lorsque tout le site est crawlé et comparé.

  3. Vérifier les longueurs par rapport aux seuils

    Les titles de plus de 60 caractères ou 561 px, et les descriptions hors de la plage de 70 à 160 caractères, sont signalés ; les seuils sont configurables.

Contrôles de cette fonctionnalité

ContrôleSignificationGravitéPreuve
TITLE_MISSINGLa page n'a pas d'élément titleCriticalURL de la page sans texte de title
TITLE_DUPLICATEPlusieurs pages partagent le même titleImportantGroupe d'URL au title identique
TITLE_TOO_LONGLe title dépasse la limite de caractères ou de pixelsTipTexte du title avec sa longueur en caractères et en pixels
TITLE_EQUALS_H1Le title est identique au H1 de la pageTipTexte du title et texte du H1
DESC_MISSINGLa page n'a pas de meta descriptionImportantURL de la page sans description
DESC_DUPLICATEPlusieurs pages partagent la même meta descriptionImportantGroupe d'URL à la description identique
TITLE_TEMPLATEDLa plupart des titles partagent un même texte de fond, et pas seulement un suffixe de marqueTipPréfixe ou suffixe commun et les URL concernées
Aussi dans le registre des contrôles
TITLE_MULTIPLETITLE_TOO_SHORTTITLE_OUTSIDE_HEADDESC_MULTIPLEDESC_TOO_LONGDESC_TOO_SHORTDESC_OUTSIDE_HEAD

Une seule commande

bash
seohead parse --url https://example.com/

Commencez par installer : guide d'installation. Chaque commande fonctionne aussi comme outil MCP pour les agents IA.

Ce qu'il vous faut

  • Une URL pour parse, afin de lire le title et la description d'une page
  • Un crawl ou des exports Screaming Frog pour les doublons et les titles templatés
  • Facultatif : des brouillons fournis par un agent IA pour meta-description-drafts

Limites

  • Les titles en double ou templatés ne peuvent pas être repérés à partir d'une seule page
  • Les largeurs en pixels viennent du crawl ou de l'export qui les fournit
  • Les seuils de longueur sont des repères : les moteurs de recherche peuvent afficher un autre extrait
  • SpiderHead n'écrit pas les titles ni les descriptions à votre place

Questions

Ai-je besoin de Screaming Frog pour cela ?
Non, pour une seule page : seohead parse --url lit directement le title et la description. Les doublons et les titles templatés demandent un crawl du site, que SpiderHead obtient avec son propre crawl-site, à partir des exports Screaming Frog (sf run --exports-dir) ou d'un crawl via le CLI Screaming Frog sous licence.
Qu'est-ce qui est considéré comme trop long ou trop court ?
Par défaut, un title est signalé au-delà de 60 caractères ou de 561 px, et en deçà de 30 caractères. Une description est signalée au-delà de 160 caractères ou de 985 px, et en deçà de 70 caractères. Tous les seuils sont modifiables dans la configuration.
Cela modifie-t-il quelque chose sur mon site ?
Non. Les contrôles ne font que lire les pages. Rien n'est écrit dans votre CMS, et les brouillons restent des fichiers locaux que vous relisez vous-même.
Écrit-il à ma place de nouveaux titles et descriptions ?
Non. meta-description-drafts valide les brouillons fournis par un agent IA, signale les problèmes à relire et peut les exporter en JSON ou en CSV locaux. Il n'appelle aucun modèle.
Qu'est-ce qu'un title templaté ?
Un title dont la plupart des pages partagent le même texte de fond, et pas seulement un suffixe de marque. Le contrôle signale l'absence de la partie propre à chaque page, ce qui rend les titles difficiles à distinguer.