
Auditoria técnica de SEO

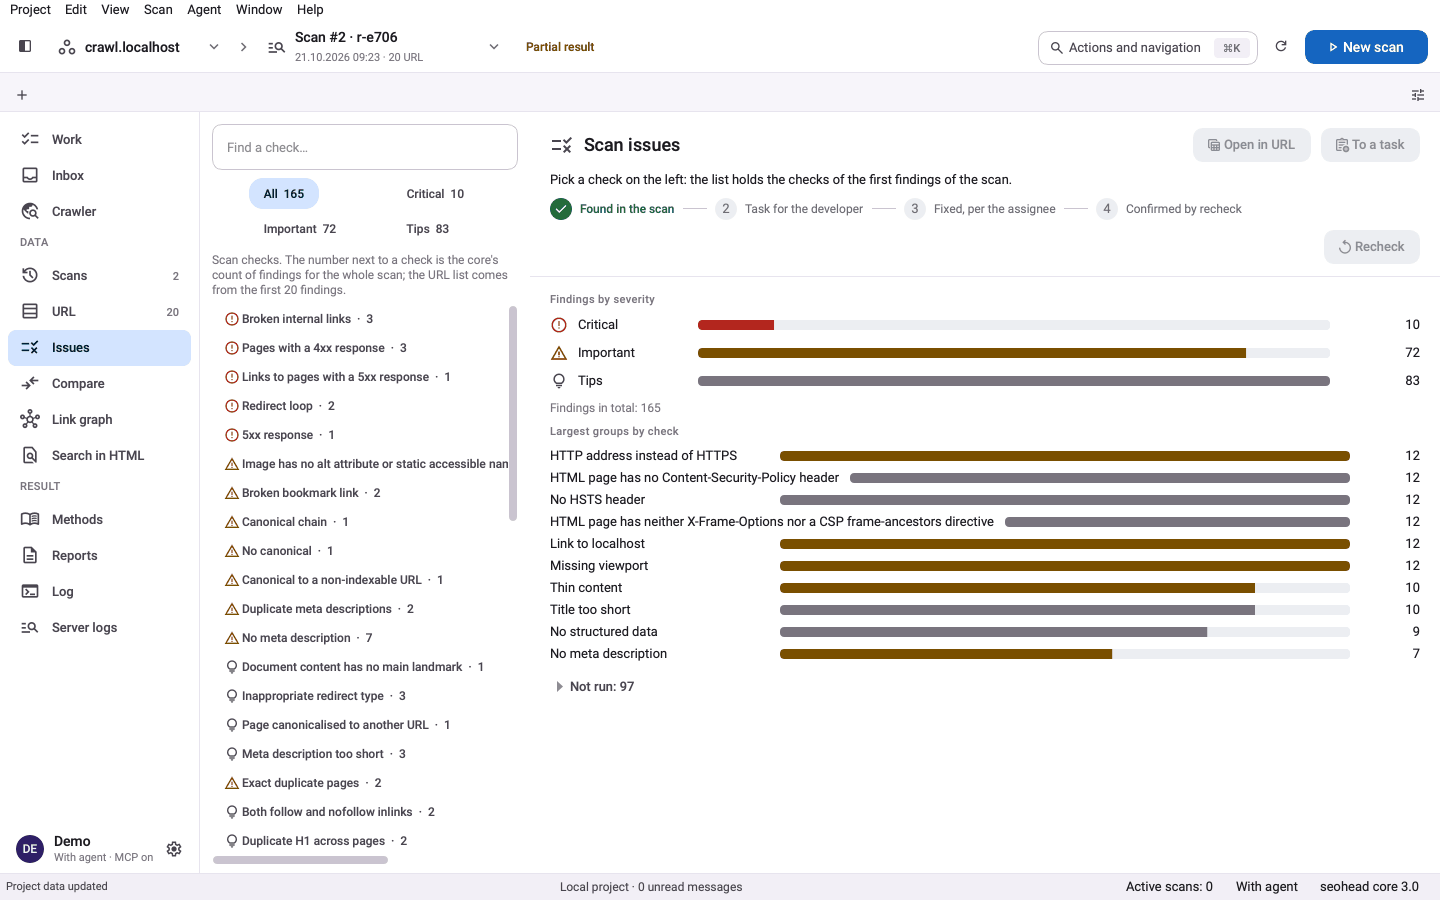
Um único registro de verificações alimenta todas as auditorias, tanto com evidências vindas de exportações do Screaming Frog ou de um rastreamento do SpiderHead. Gravidade, fonte de evidência e correção saem do mesmo registro que o motor de regras lê, então um problema nunca afirma mais do que o motor consegue comprovar.

O que faz

Evidência, não suposição

Cada problema indica a URL, o que foi observado e uma correção. Nos problemas de links, também mostra onde na página o link está. Uma verificação sem dados para rodar aparece como ignorada, com o motivo, nunca como aprovada.

  • Níveis de gravidade: crítico, aviso e observação
  • Posição do link e XPath nos problemas de links (das exportações Inlinks do Screaming Frog)
  • Todo problema traz um texto de correção do registro

Cobertura honesta

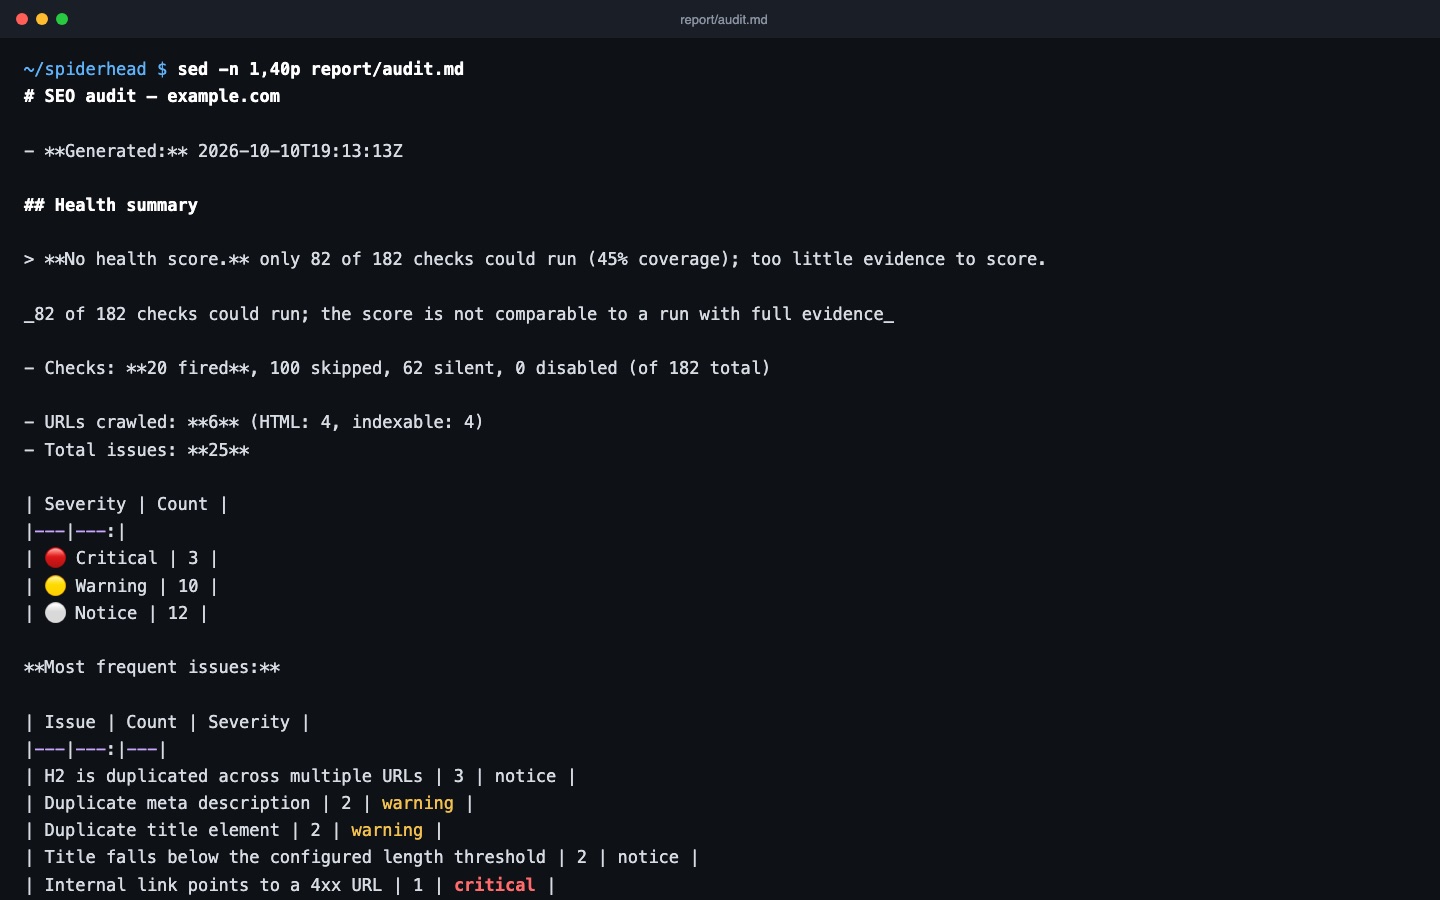
O relatório conta quantas verificações puderam rodar com as evidências recebidas. Quando a cobertura fica abaixo da metade, a pontuação de saúde é omitida. Cobertura menor também marca a pontuação como não comparável com uma execução que teve evidências completas.

  • Verificações ignoradas aparecem listadas com o dado que faltou
  • Nenhuma pontuação com evidências insuficientes
  • Rode de novo com mais exportações para aumentar a cobertura

De problemas a uma lista de tarefas

Com a flag --tasks, a auditoria também grava tasks.json e tasks.md: uma lista priorizada para desenvolvedores, com a correção ao lado de cada problema. A mesma auditoria pode falhar um build de CI quando existem problemas da gravidade escolhida.

  • Lista de tarefas em JSON e Markdown
  • Falhar o build com problemas críticos ou avisos, com código de saída diferente de zero
  • Formatos de relatório: json e md

Três passos, um rastreamento salvo

  1. Aponte para as exportações

    Informe uma pasta com exportações CSV ou XLSX do Screaming Frog. Todas as verificações leem o mesmo registro, independentemente de como a evidência foi coletada.

  2. Rode todas as verificações que a evidência permite

    Cada verificação reporta problemas, passa sem nada a apontar ou é ignorada com o motivo quando faltam os dados de que precisa.

  3. Receba as correções como lista de tarefas

    Adicione --tasks para obter tasks.json e tasks.md, um backlog priorizado para desenvolvedores, com a correção ao lado de cada problema.

Verificações deste recurso

VerificaçãoO que significaGravidadeEvidência
BROKEN_PAGE_4XXA página responde com status 4xxCriticalExportação Response Codes 4xx, URL e status
SERVER_ERROR_5XXA página responde com status 5xxCriticalExportação Response Codes 5xx, URL e status
TITLE_MISSINGA página não tem tag titleCriticalURL da página
BROKEN_INTERNAL_LINKUm link interno aponta para uma URL 4xxCriticalPágina de origem e posição do link na exportação de inlinks
H1_MISSINGA página não tem título H1ImportantURL da página
CANONICAL_MISSINGUma página indexável não tem URL canônicaImportantURL da página
THIN_CONTENTA página tem conteúdo raso, com poucas palavrasImportantURL e contagem de palavras
HEADING_BEFORE_H1Há títulos antes do primeiro H1 da páginaTipHierarquia de títulos da página

Um comando

bash
seohead sf run --exports-dir ./exports --out ./report --tasks

Instale primeiro: guia de instalação. Todo comando também funciona como ferramenta MCP para agentes de IA.

O que você precisa

  • Uma pasta com exportações CSV ou XLSX do Screaming Frog, ou uma URL inicial para um rastreamento
  • A CLI licenciada do Screaming Frog, apenas para os modos de rastreamento do sf run
  • Nenhuma chave de API para a auditoria offline das exportações

Limites

  • Verificações sem as evidências de que precisam são ignoradas, não estimadas
  • Se poucas verificações conseguirem rodar, a pontuação é omitida ou marcada como não comparável
  • Rastrear pelo Screaming Frog exige uma instalação própria com licença
  • Verificações de páginas renderizadas precisam de um rastreamento com renderização, não de exportações estáticas

Perguntas

Preciso de licença do Screaming Frog?
Não para ler exportações. O sf run --exports-dir analisa offline arquivos CSV ou XLSX do Screaming Frog que já existem. Rastrear pela CLI do Screaming Frog (--crawl) exige uma instalação licenciada do Screaming Frog. O crawl-site é o rastreador próprio do SpiderHead e audita o resultado pelas mesmas verificações.
O que acontece quando uma verificação não tem dados para rodar?
Ela aparece como ignorada, com o motivo. Nunca aparece como aprovada.
A auditoria altera meu site?
Não. Ela lê exportações ou rastreamentos salvos. Um rastreamento envia requisições somente leitura na taxa que você definir; nos rastreamentos do Screaming Frog, isso é feito por --max-urls-per-second, e 1 a 2 requisições por segundo é um começo que não sobrecarrega o servidor.
Um agente de IA pode rodar a auditoria?
Sim. A mesma auditoria está disponível como ferramentas MCP: sf_audit_run, sf_audit_issues, sf_audit_summary e sf_audit_tasks.
Posso falhar um build de CI por causa dos problemas?
Sim. --fail-on critical ou --fail-on warning retorna um código de saída diferente de zero quando existem problemas dessa gravidade. O padrão é --fail-on none, então uma execução simples não falha por causa de problemas.
Para onde vão os resultados?
Para o diretório informado em --out, como relatório local (json e md). Nada é enviado para fora.

Teste no seu próprio site