
Estrazione personalizzata dalle pagine scansionate

Selettori di contenuto e regole dichiarative di estrazione girano sui corpi delle pagine conservati, e la ricerca nel sorgente della scansione salvata trova quali pagine portano un marker, come uno snippet GTM.

Cosa fa

Regole di estrazione

Le regole sono dati semplici, non codice: ognuna ha un kind (text, attribute, structured, presence o count), un selettore e un operatore (equals, contains, matches o exists). L'operatore matches è un pattern glob limitato, non un'espressione regolare. scan-extract applica le regole ai corpi conservati senza rete e senza scritture, quindi puoi cambiare una regola e rieseguire senza riscansionare. Per provare estrattori CSS, XPath o regex su HTML che incolli, usa custom-extract-sample.

Cerca nell'HTML salvato

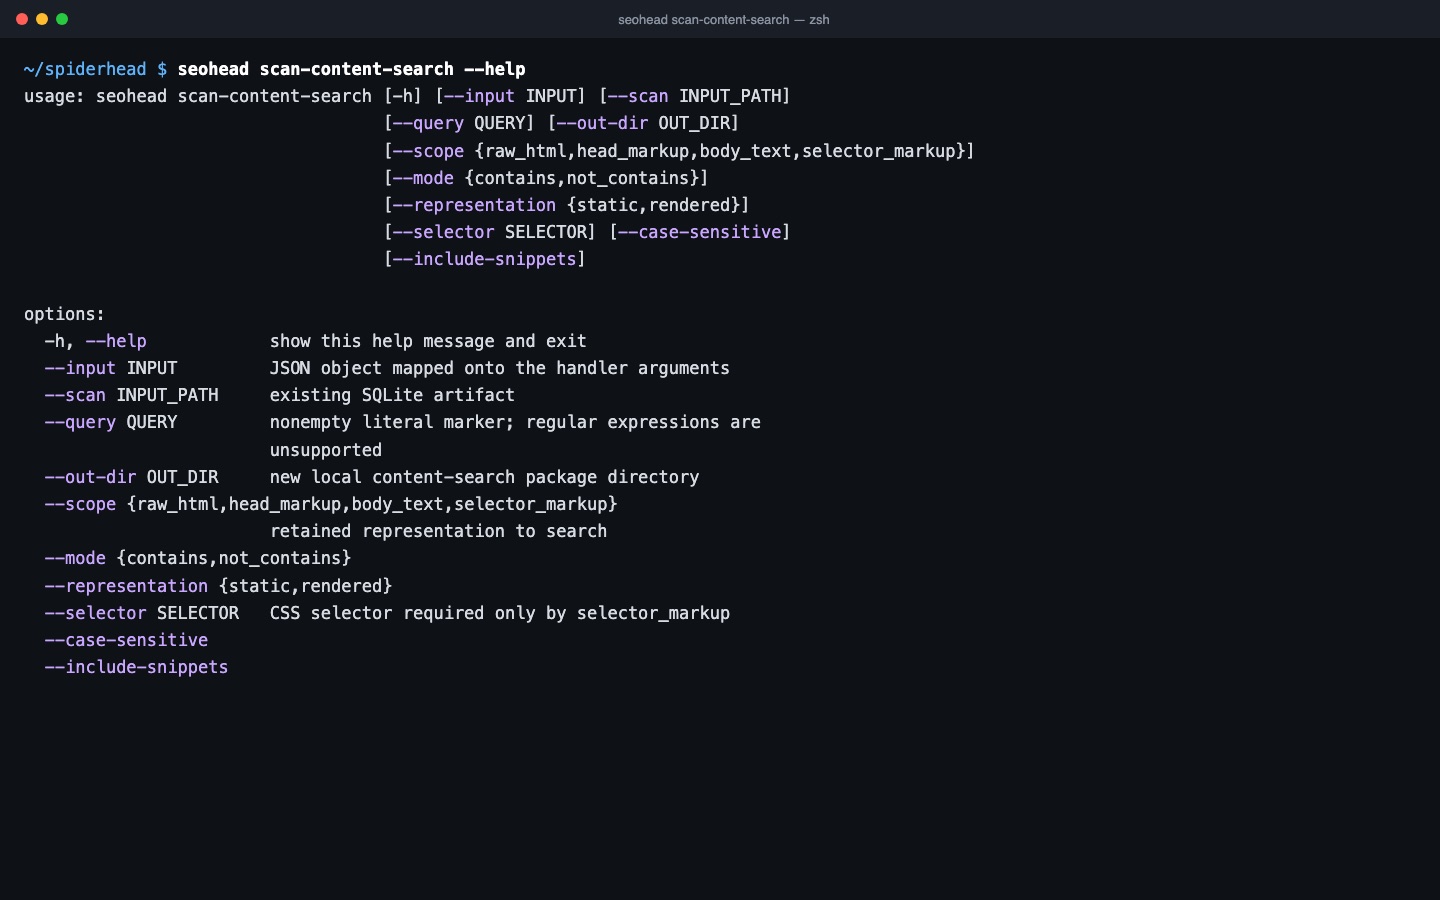
scan-content-search trova una stringa o un'espressione regolare nell'HTML grezzo, nel markup della head, nel testo del corpo o nel markup corrispondente a un selettore CSS. Usalo per trovare quali pagine portano un marker come uno snippet GTM. Scrive le corrispondenze in un nuovo pacchetto locale, quindi il risultato resta tuo.

  • Query letterale o regex, HTML grezzo o DOM renderizzato
  • I risultati si leggono 100 record alla volta con scan-content-search-page

Tre passaggi, una scansione salvata

  1. Scansiona una volta e conserva i corpi

    Una scansione salvata conserva i corpi completi delle pagine entro il limite di conservazione. Regole e ricerche girano poi su quella copia, non sul sito attivo.

  2. Esegui le regole offline

    Scrivi le regole in JSON con kind text, attribute, structured, presence o count, e operatore equals, contains, matches (un glob) o exists. Passale a seohead scan-extract con --input o tramite lo strumento MCP; non si scarica nulla e il risultato non viene salvato.

  3. Cerca un marker nell'HTML salvato

    scan-content-search trova una stringa letterale o una regex nell'HTML grezzo, nel markup della head, nel testo del corpo o in un selettore CSS, e scrive un pacchetto locale. Leggilo 100 righe alla volta con scan-content-search-page.

Controlli di questa funzionalità

ControlloCosa significaGravitàEvidenza
TITLE_MISSINGManca l'elemento title. Una regola con kind text sul selettore del title trova la stessa lacuna su tutta la scansione salvata.CriticalURL della pagina; l'elemento title è assente o vuoto
CANONICAL_MISSINGLa pagina indicizzabile non ha URL canonical. Una regola presence su link[rel=canonical] elenca le pagine che ne sono prive.ImportantURL della pagina; nessun link canonical trovato
SCHEMA_VALIDATION_ERRORErrori di validazione dei dati strutturati. Una regola structured con un JSON pointer permette di leggere i valori JSON-LD dietro l'errore.ImportantURL della pagina e l'elemento di dati strutturati che fallisce
STRUCTURED_DATA_MISSINGMancano i dati strutturati su pagine dove li aspetti. Una regola presence sul blocco JSON-LD mostra le pagine che non ne hanno.TipURL della pagina; nessun dato strutturato trovato
LOREM_IPSUM_PLACEHOLDERTesto segnaposto Lorem Ipsum nell'area contenuti della pagina. Una ricerca nei contenuti della frase segnaposto la trova su tutta la scansione.ImportantURL della pagina e il numero di corrispondenze del segnaposto

Un solo comando

bash
seohead scan-content-search --scan ./scans/audit.sqlite --query gtm.js

Prima installa SpiderHead: guida all'installazione. Ogni comando funziona anche come strumento MCP per agenti AI.

Cosa ti serve

  • Una scansione salvata (SQLite) con i corpi delle pagine conservati
  • Per l'estrazione: una lista JSON di regole, passata con --input o tramite lo strumento MCP
  • Per la ricerca: una stringa di query o una regex, e una nuova cartella di output

Limiti

  • Solo le pagine il cui corpo è stato conservato si possono cercare o estrarre
  • Le regole di estrazione non hanno un campo regex; per le espressioni regolari usa la ricerca nei contenuti
  • Un risultato conferma che il codice è nell'HTML, non che un tag sia scattato per un visitatore
  • Il contenuto renderizzato è ricercabile solo se la scansione ne ha conservato una copia

Domande

L'estrazione scarica di nuovo il sito?
No. scan-extract e scan-content-search leggono i corpi conservati nel file di scansione salvato. Non scaricano mai una URL, quindi puoi cambiare una regola e rieseguire senza una nuova scansione.
Se trova un tag GTM, è scattato?
Non necessariamente. Un risultato della ricerca dice che il tag è nell'HTML. Non prova che il tag sia scattato per un visitatore. La ricerca riporta dove il codice è presente.
Cosa succede se il corpo di una pagina non è stato conservato?
La pagina viene riportata come sconosciuta, non come mancante. Una ricerca non dice mai che un marker è assente quando il corpo non sta nella scansione.
Il risultato dell'estrazione viene salvato?
scan-extract non salva il risultato; lo stampa per quella esecuzione. scan-content-search scrive un nuovo pacchetto locale, quindi le corrispondenze restano tue.
Posso usare espressioni regolari?
Nella ricerca nei contenuti, sì: --kind regex accetta un'espressione regolare Python. Se una pagina supera il budget di tempo della regex, o la piattaforma non può imporlo, viene riportata come non disponibile, non come non corrispondente. Le regole di estrazione non accettano regex.