
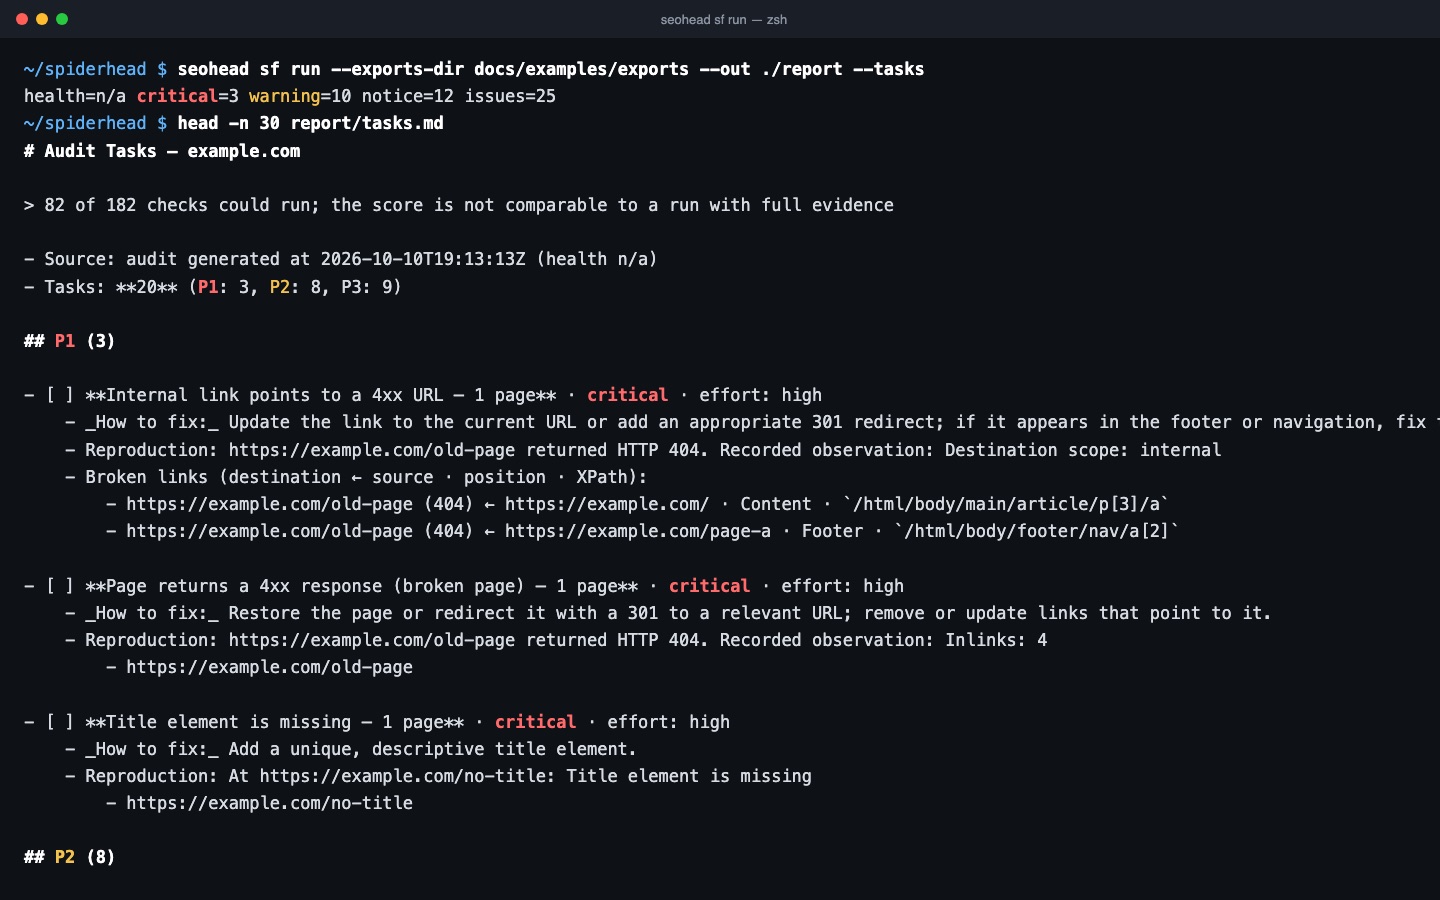
Lista di task SEO per gli sviluppatori

Un audit può produrre un backlog di task prioritizzato: un task per tipo di problema, con priorità, impegno, URL interessate, un suggerimento di correzione e righe di riproduzione. I link rotti elencano anche la pagina di origine, la posizione del link e lo XPath.

Cosa fa

Da P1 a P3

I task sono raggruppati per priorità in tasks.md e salvati anche come tasks.json per script e agent. Per impostazione predefinita le segnalazioni critical diventano P1 con impegno alto, le warning P2 con impegno medio e le notice P3 con impegno basso. La mappatura è una regola, non una stima per sito, e puoi cambiarla.

  • Un task per controllo per impostazione predefinita; group_by può fare anche un task per URL o per template dichiarato
  • Ogni task porta un suggerimento di correzione preso dal controllo
  • Le URL interessate hanno un tetto per task, e il task dice quante ne sono state lasciate fuori
  • Gravità, controlli e occorrenze minime si possono filtrare nella configurazione

Riproduzione ed evidenze

Ogni task elenca righe di riproduzione prese dall'audit salvato: la URL, il codice di stato e, per i link, dove stanno nella pagina. Se l'audit non contiene riproduzioni, tasks.md lo dice e non ne inventa una. I task conservano anche i riferimenti alle osservazioni salvate da cui provengono, quando l'audit li ha.

  • Link rotti: destinazione, pagina di origine, posizione del link e XPath
  • Gli audit parziali o con controlli saltati portano quell'avviso in tasks.md
  • Le URL nascoste da regole di esclusione mancano dalla lista, e il file dichiara quante sono

Ricontrollo

tasks.md è un backlog proposto, non un piano approvato. Dopo un rilascio, non contare un task come corretto perché è sparito dalla lista. Verificalo con un ricontrollo sulle URL interessate, usando gli strumenti di remediation o verify-fixes, e confronta una scansione prima e dopo.

  • verify-fixes ricontrolla segnalazioni della baseline selezionate su un sottoinsieme esplicito di URL
  • remediation-recheck lavora su casi esatti del registro e scrive evidenze di verifica
  • Una segnalazione scomparsa non prova una correzione quando la scansione successiva era parziale

Tre passaggi, una scansione salvata

  1. Esegui l'audit dai tuoi export

    Punta il CLI a una cartella di export CSV o XLSX di Screaming Frog e aggiungi --tasks per avere il backlog nello stesso run.

  2. Ottieni task ordinati da P1 a P3

    Ogni task ha una priorità, una stima di impegno, le URL interessate, la correzione e la riproduzione. I link rotti elencano anche pagina di origine, posizione del link e XPath.

  3. Ricontrolla dopo il rilascio

    Verifica ogni correzione con lo strumento di ricontrollo dei rimedi, non controllando che il task sia sparito dalla lista.

Controlli di questa funzionalità

ControlloCosa significaGravitàEvidenza
BROKEN_PAGE_4XXLa pagina restituisce una risposta 4xxCriticalURL interessata e suo stato di risposta
BROKEN_INTERNAL_LINKUn link interno punta a una URL 4xxCriticalDestinazione, pagina di origine, posizione del link e XPath per ogni link rotto
REDIRECT_LOOPUn ciclo di redirect che non raggiunge mai una destinazione validaCriticalRighe del report delle catene di redirect
TITLE_MISSINGLa pagina non ha l'elemento titleCriticalURL interessate, con tetto per task
REDIRECT_CHAINDue o più hop di redirect prima della URL finaleImportantHop nel report delle catene di redirect
DESC_MISSINGLa pagina non ha meta descriptionImportantURL interessate, con tetto per task
H1_MISSINGLa pagina non ha l'intestazione H1ImportantURL interessate, con tetto per task
BAD_REDIRECT_TYPEUn 302, 303 o 307 è usato dove si attende uno spostamento permanenteTipURL interessate, con tetto per task

Un solo comando

bash
seohead sf run --exports-dir ./exports --out ./report --tasks

Prima installa SpiderHead: guida all'installazione. Ogni comando funziona anche come strumento MCP per agenti AI.

Cosa ti serve

  • Una cartella di export CSV o XLSX di Screaming Frog, oppure un audit.json esistente
  • Oppure una scansione nativa salvata (file SQLite scan.v1) da crawl-site
  • config.json facoltativo con un blocco tasks_pipeline
  • Un CLI Screaming Frog con licenza solo se vuoi che sf run avvii la scansione

Limiti

  • Costruisce un backlog proposto da un audit. Non approva, assegna né distribuisce lavoro
  • Priorità e impegno arrivano dalla gravità per regola, non dalla dimensione del tuo sito o del team
  • Elenchi di URL e righe di riproduzione hanno un tetto per task, quindi un task mostra un campione più un conteggio
  • La copertura è buona quanto l'audit: un controllo non eseguito non produce task

Domande

Serve la licenza di Screaming Frog?
Non per il costruttore di task. Legge export che hai già (CSV o XLSX), un audit.json o una scansione nativa. Solo sf run con --crawl avvia una scansione tramite il CLI di Screaming Frog con licenza.
Cambia qualcosa sul mio sito?
No. Il costruttore di task legge l'audit e scrive file: tasks.json e tasks.md nella cartella che dai con --out. Cosa distribuire lo decidi tu.
Posso cambiare le priorità?
Sì. Passa un config.json con --config e imposta priority_map, effort_map, group_by, include_severities, max_urls_per_task e min_occurrences sotto tasks_pipeline.
E se un task non ha passaggi di riproduzione?
tasks.md dice che la riproduzione non è disponibile dall'audit salvato. Non ne inventa una.
Posso costruire task da un audit che ho già?
Sì. Esegui sf tasks con --json puntando a un audit.json o a un file di scansione nativo. Scrive tasks.json e tasks.md senza scansionare né inviare richieste.
Può eseguirlo un agente AI?
Sì. Gli stessi passaggi esistono come strumenti MCP: sf_audit_run per l'audit e sf_audit_tasks per il backlog.