
Verifica delle correzioni SEO

Ricontrolla segnalazioni o URL selezionate dopo un rilascio. Ogni segnalazione è classificata come risolta, persistente, cambiata o non verificabile, usando solo le pagine interessate.

Cosa fa

Ricontrollo mirato

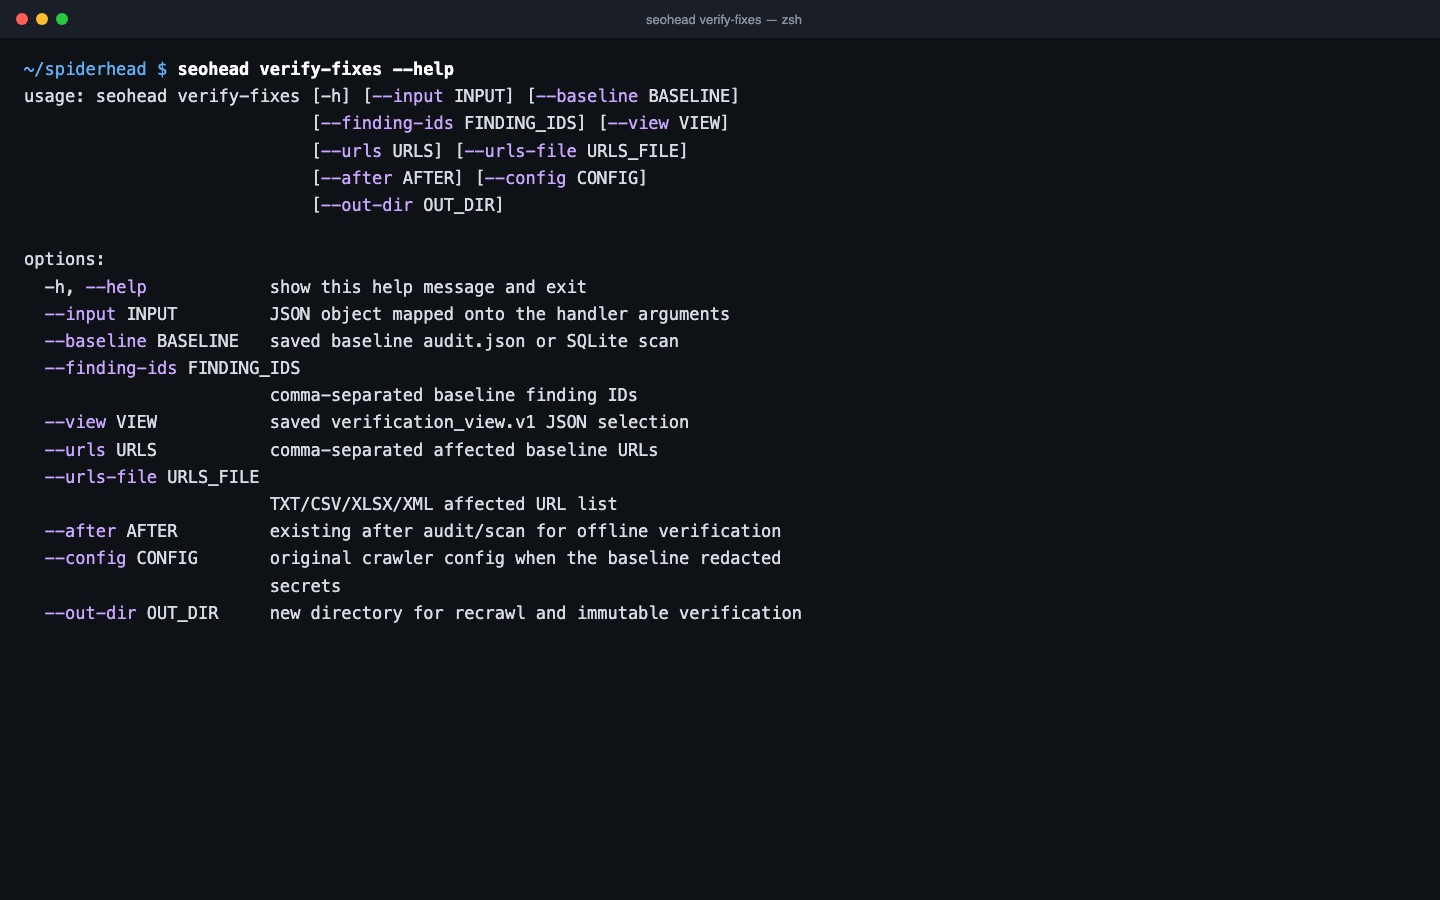
Scegli cosa controllare per ID di segnalazione, per URL interessata, da un file di URL o da una vista di verifica salvata. SpiderHead riscarica solo quelle pagine, con la policy HTTP, robots e render registrata nella baseline. I controlli su tutto il sito non vengono rieseguiti.

  • Una selezione contiene al massimo 500 destinazioni di scansione e 5.000 segnalazioni.
  • Una selezione oltre i limiti fallisce. Non viene mai campionata.
  • --after usa un audit o una scansione successiva esistenti, quindi non viene inviata alcuna richiesta.

Verdetti circoscritti

Un ricontrollo parziale non può dichiarare corretto l'intero sito. I controlli su tutto il sito e quelli non misurati tornano non verificabili. Una scansione successiva non valida non può risolvere segnalazioni, e rianalizzare la stessa scansione non è evidenza fresca.

  • Ogni verdetto porta un motivo e l'evidenza.
  • I risultati sono scritti come nuovo file JSON e Markdown immutabile.
  • Le pagine mancanti restano non verificabili.

Registro dei rimedi

Per i lavori lunghi, un registro dei rimedi legato a un progetto segue ogni caso attraverso i suoi stati di vita. Un task avanza su evidenza di ricontrollo, quindi un task segnato come fatto non viene scambiato per un sito corretto. I ricontrolli restano limitati ai casi esatti in sospeso.

  • remediation-ingest carica un audit salvato come baseline.
  • remediation-recheck controlla i casi in sospeso senza scansionare il sito.
  • remediation-report mostra le evidenze prima e dopo, offline.

Tre passaggi, una scansione salvata

  1. Parti da una baseline

    Punta verify-fixes all'audit.json o alla scansione SQLite che hai già, poi scegli ID di segnalazione o URL interessate.

  2. Ricontrolla solo le pagine interessate

    Riscarica le URL selezionate con la policy HTTP, robots e render registrata nella baseline. I controlli su tutto il sito non vengono rieseguiti.

  3. Leggi il verdetto per segnalazione

    Ogni segnalazione è marcata risolta, persistente, cambiata o non verificabile, con motivo ed evidenza in un nuovo file JSON o Markdown immutabile.

Controlli di questa funzionalità

ControlloCosa significaGravitàEvidenza
BROKEN_PAGE_4XXLa pagina restituisce uno stato 4xx; un ricontrollo può mostrarla corretta quando la URL risponde 2xxCriticalCodice di stato prima e dopo, per URL
SERVER_ERROR_5XXLa pagina restituisce uno stato 5xx; risolta solo se il ricontrollo ottiene un 2xxCriticalCodice di stato prima e dopo, per URL
TITLE_MISSINGLa pagina non ha l'elemento title; una correzione compare come risolta sulla stessa URLCriticalRighe di segnalazione della baseline e del ricontrollo per la URL
H1_MISSINGLa pagina non ha l'intestazione H1ImportantRighe di segnalazione della baseline e del ricontrollo per la URL
CANONICAL_MISSINGLa pagina non ha l'elemento link canonicalImportantRighe di segnalazione della baseline e del ricontrollo per la URL
REDIRECT_CHAINIl redirect passa per due o più hop prima della URL finaleImportantStato per hop dal ricontrollo
BAD_REDIRECT_TYPE302, 303 o 307 usati dove si attende un 301 permanenteTipStato per hop dal ricontrollo

Un solo comando

bash
seohead verify-fixes --baseline ./report/audit.json --urls https://example.com/old-page --out-dir ./verification-1

Prima installa SpiderHead: guida all'installazione. Ogni comando funziona anche come strumento MCP per agenti AI.

Cosa ti serve

  • Una baseline: un audit.json o una scansione SQLite salvata
  • Una selezione: ID di segnalazione, URL, un file di URL o una vista salvata
  • Una nuova cartella di output (--out-dir) per i file di verifica
  • Opzionale: la configurazione originale del crawler se la baseline aveva offuscato le credenziali (--config)

Limiti

  • Senza --after invia richieste di lettura alle URL che selezioni.
  • Solo le pagine selezionate vengono controllate. Non riscansiona il sito.
  • Una scansione successiva usata con --after dev'essere distinta e osservata dopo la baseline.
  • I controlli su tutto il sito non si possono verificare da un ricontrollo parziale.

Domande

Cambia qualcosa sul mio sito?
No. Invia solo richieste di lettura alle URL che selezioni. L'output è un nuovo file di verifica nella cartella che indichi con --out-dir.
Un risultato risolto significa che tutto il sito è a posto?
No. Controlla solo le pagine interessate che hai selezionato. I controlli su tutto il sito e quelli non misurati non possono diventare corretti da un ricontrollo parziale; tornano non verificabili.
Devo prima scansionare di nuovo?
Serve una baseline: un audit.json o una scansione SQLite salvata. Per controllare senza richieste di rete, passa --after con un audit successivo esistente e lavora offline.
Quante segnalazioni posso verificare in un run?
Fino a 500 destinazioni di scansione e 5.000 segnalazioni. Le selezioni più grandi falliscono invece di essere campionate, quindi dividile.
Che differenza c'è con compare-crawls?
compare-crawls confronta due file salvati e non scarica nulla. verify-fixes riscarica le pagine che selezioni e dà un verdetto per segnalazione. Usa compare-crawls per una panoramica di rilascio e verify-fixes per chiudere task specifici.
Posso usarlo da un assistente AI?
Sì. La stessa operazione è disponibile nel server MCP locale come seo_verify_fixes, con gli stessi argomenti del CLI.