
Integrazione Google Search Console

Interroga Search Console, archivia i suoi dati in un file SQLite locale e uniscili alle evidenze della scansione per URL. L'accesso è in sola lettura e usa le tue credenziali Google.

Cosa fa

Collega in sola lettura

SpiderHead usa solo lo scope di Search Console in sola lettura. Ci sono tre modi di fornire l'accesso, e ne scegli uno. provider-verify poi verifica l'accesso alla proprietà separatamente, perché un login valido non prova che tu possa leggere un dato sito.

  • Consenso dal browser con il tuo client OAuth Desktop, tramite scripts/gsc_oauth_login.py. Il refresh token è conservato nella tua cartella di configurazione locale.
  • Un service account Google che aggiungi come utente sulla proprietà.
  • Un access token pronto nell'impostazione GSC_ACCESS_TOKEN.

Storico locale

gsc-archive mette in coda un intervallo di date e lo scarica in lotti piccoli e riprendibili dentro un file SQLite che nomini. sources-sync conserva lo storico giornaliero per progetto e scarica solo i giorni mancanti. Nulla va a un servizio ospitato, e i file sono creati con permessi del solo proprietario.

  • Le date sono inclusive e usano l'ora del Pacifico.
  • Granularità diverse (totali, pagine, query) sono dataset separati e non vengono mai sommate.
  • Gli archivi possono contenere query e URL, quindi tienili fuori da report pubblici e da Git.

Ispezione URL

gsc-query con modalità inspect_url restituisce il verdetto di indicizzazione di Google per una URL. Resta sulla sua riga, separato dai controlli del crawler. Dentro sf run, --gsc-inspect ispeziona un campione deterministico fino a 50 URL, con limiti locali di 600 al minuto e 2.000 ogni 24 ore.

  • Solo la versione indicizzata di una pagina può essere ispezionata.
  • I limiti per sito di Google si aggiungono a quelli locali.
  • Le URL non ispezionate restano sconosciute.

Tre passaggi, una scansione salvata

  1. Collega una concessione in sola lettura

    Collega una concessione Google in sola lettura per una proprietà che possiedi. Controllane lo stato in qualsiasi momento.

  2. Archivia in locale

    Metti in coda un intervallo di date ed eseguilo in lotti piccoli e limitati dentro un file SQLite sul tuo computer. Le riesecuzioni scaricano solo i giorni mancanti.

  3. Uniscilo a ogni URL

    Clic, impression, posizione e CTR si uniscono alle pagine scansionate per URL. Il verdetto di indicizzazione di Google per una URL resta sulla sua riga.

Un solo comando

bash
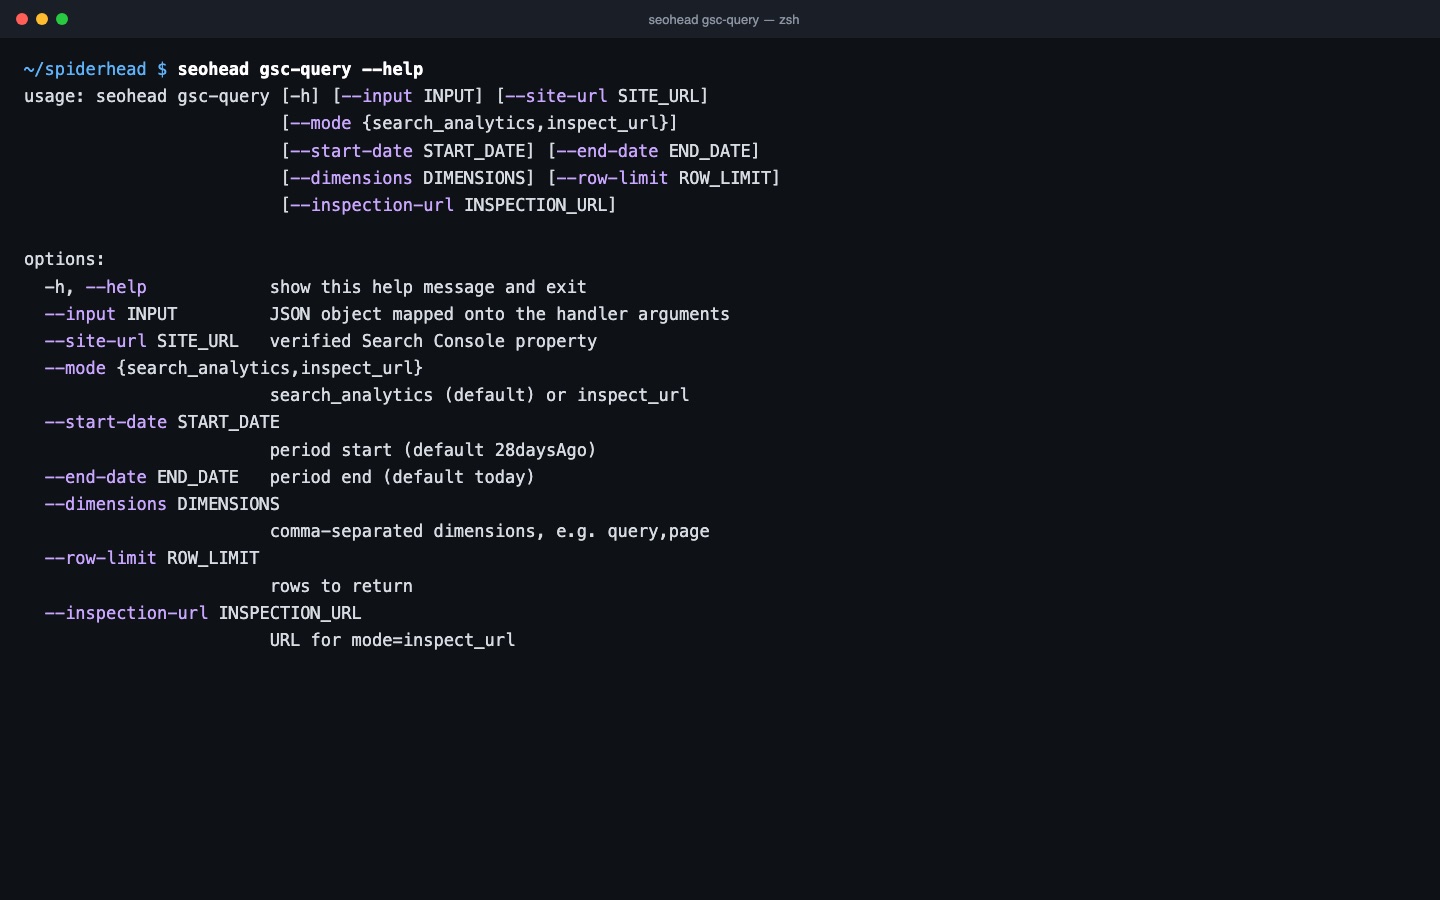
seohead gsc-query --site-url sc-domain:example.com --start-date 2026-09-01 --end-date 2026-09-30

Prima installa SpiderHead: guida all'installazione. Ogni comando funziona anche come strumento MCP per agenti AI.

Cosa ti serve

  • Una proprietà Search Console che possiedi o puoi leggere (una proprietà dominio o un prefisso URL)
  • Una credenziale: consenso OAuth, service account o access token (tutti in sola lettura)
  • Un intervallo di date, entro gli ultimi circa 16 mesi
  • Opzionale: una scansione o scan a cui unire le righe

Limiti

  • Google conserva circa 16 mesi di dati.
  • Le query anonimizzate sono escluse e le righe possono essere troncate. Un lavoro troncato è marcato e non è un export completo.
  • Clic, impression, CTR e posizione non si sommano tra granularità diverse.
  • Il verdetto di indicizzazione copre solo le URL che ispezioni.

Domande

I miei dati vanno a un servizio ospitato?
No. Le richieste vanno dal tuo computer dritte all'API di Google Search Console, con la tua concessione. I risultati sono conservati in file SQLite locali con permessi del solo proprietario. Tieni quei file fuori da report pubblici e da Git, perché possono contenere query e URL.
Può modificare la mia proprietà Search Console?
No. La concessione è in sola lettura. Lo strumento legge solo search analytics e risultati di ispezione URL.
Fino a quanto indietro vanno i dati?
Circa 16 mesi, che è lo storico disponibile di Google. Le date sono inclusive e usano l'ora del Pacifico.
Perché alcune query sembrano mancare?
Google omette le query anonimizzate e può troncare le righe restituite. Un lavoro troncato non è un export completo, e lo strumento lo marca come tale.
Il verdetto di indicizzazione di Google sostituisce i controlli della scansione?
No. Il verdetto di Google per una URL arriva da gsc-query in modalità inspect_url. I controlli del crawler (metadati, header, robots, redirect, dati strutturati, render) girano con inspect-url. I due risultati restano separati.
Quanto costa, e cosa viene conservato in locale?
L'API è gratuita entro le quote di Google. SpiderHead conserva il tuo refresh token o il percorso del service account nella cartella di configurazione locale, e i file di archivio e storico dove li indirizzi. Nessun token è scritto nei file di storico.