Yandex Wordstat
collect · synonymsFrequenza base, affinamenti e query simili tramite l'API di Yandex Cloud. Servono API key e folder ID; quota oraria.
Raccogli, pulisci e raggruppa le keyword di ogni progetto: Wordstat, cluster SERP, frequenza esatta, analisi dei competitor e piano offline prima di ogni spesa.
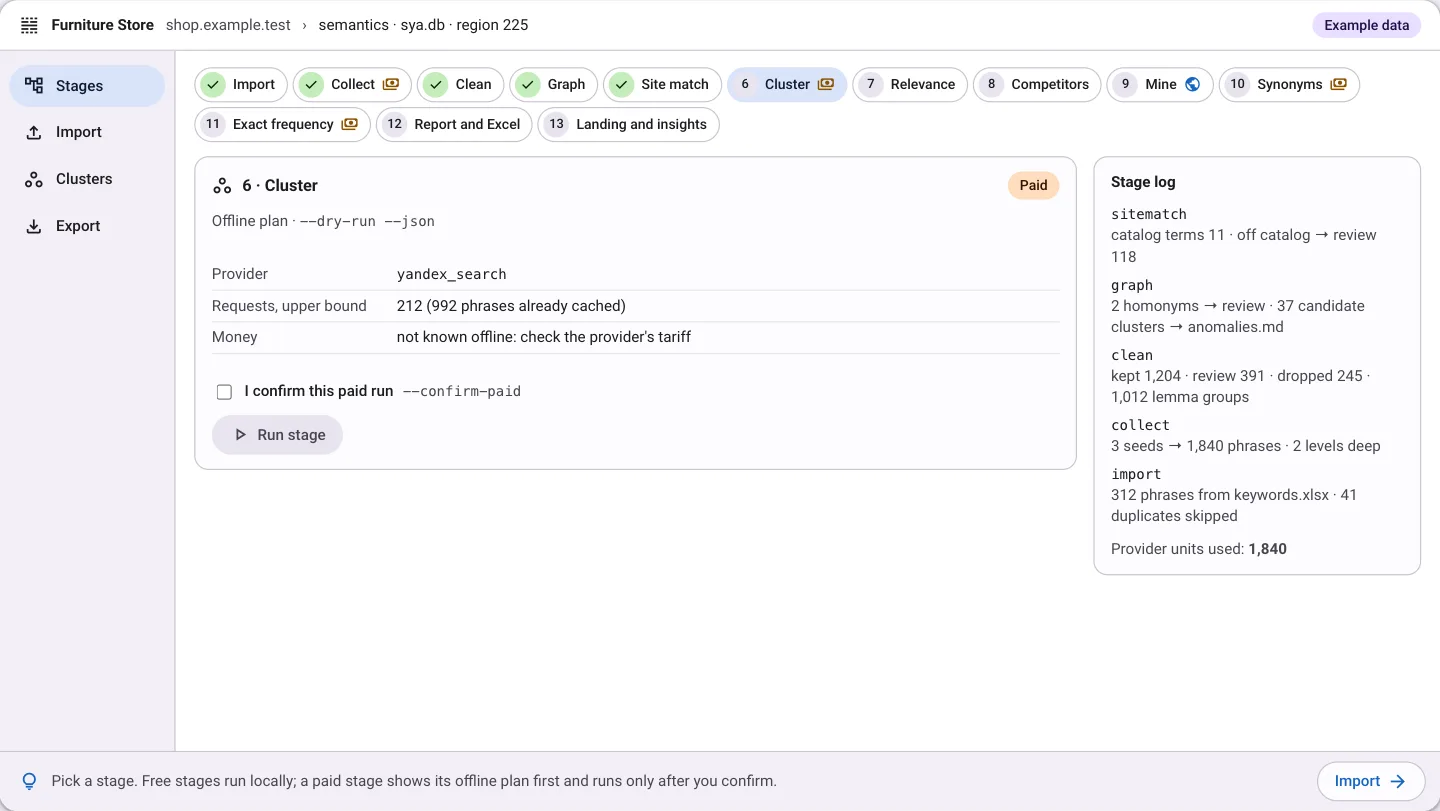
Ogni fase cambia uno stato e ne registra il motivo: una frase non viene mai cancellata e ogni decisione si può spiegare. Le fasi gratuite stanno tra quelle a pagamento, così controlli il pool prima di comprare la risposta successiva.
Porta quello che hai già: un CSV o un foglio di un XLSX. Associa query, frequency, group, subgroup, URL e comment, poi scegli tra add, update o replace. L'anteprima mostra le righe nuove, esistenti e duplicate prima di scrivere qualsiasi cosa.
phrasesEspande i tuoi seed per regione e riespande le frasi forti fino alla profondità che imposti. La coda è deduplicata e --resume riprende un'esecuzione interrotta senza chiedere di nuovo la stessa frase.
phrases, expansions, provenanceApplica i filtri del progetto (intento, stop word, pattern informazionali), segnala le frequenze anomale e raggruppa le frasi per lemma. Una frase con impression o posizioni osservate non viene mai tagliata dalle regole sulla frequenza.
status, route, lemma groupCostruisce un grafo delle parole del pool. I candidati omonimi vanno in revisione e i cluster candidati finiscono in anomalies.md, prima che tu paghi altro.
anomalies.mdUna frase entra nel core solo se il sito la offre. Le frasi senza alcun termine di catalog.txt vanno in revisione come fuori catalogo.
review listRecupera una top 10 per frase e la mette in cache, quindi una nuova esecuzione paga solo le frasi nuove. Le frasi che condividono pagine formano un cluster; --method louvain raggruppa di nuovo i risultati in cache per spezzare le catene lunghe.
SERP cache, clusters, landing candidatesSe nella top 10 di una frase non compare nessun sito del tuo tipo presente in vendors.txt, l'argomento è probabilmente fuori target. La frase va in revisione; non si cancella nulla.
review listLegge i risultati in cache: quali domini presidiano i tuoi cluster e quali parole usano nei title. I candidati vanno in synonyms.txt.
competitors.md, synonyms.txtApre le pagine dei competitor più frequenti tra i risultati raccolti e legge title, description, H1 e primi H2. Le frasi tematiche di due e tre parole vanno in synonyms.txt.
competitor_mining.md, synonyms.txtVerifica i candidati di synonyms.txt. Entrano nel core solo le frasi con domanda; poi collect --resume fa crescere il pool a partire da loro.
checked phrasesCompra la frequenza esatta !W una sola volta per gruppo di lemmi, alla fine, quando il pool ha smesso di cambiare. Sopra la soglia di budget del progetto serve --yes.
exact frequency, task receiptsreport.md e clusters.csv da leggere, una cartella XLSX (Summary, Core, Info, Clusters, Rejected) per il cliente, pool.csv e pool.json per altri strumenti.
report.md, XLSX, CSV, JSONDopo il lancio, scegli la landing page di ogni cluster tra i candidati misurati, poi leggi i segnali settimanali dei cluster dai tuoi dati locali di Search Console, Webmaster e Metrika e trasforma quelli scelti in task della checklist.
landing, weekly signals, tasksIl core non si raccoglie una volta sola. Competitor e mining alimentano nuovi candidati, i sinonimi li verificano, la raccolta riprende e il clustering riparte. La frequenza esatta si compra per ultima.
collectclean · graph · site matchclustercompetitors · minesynonymscollect --resumeexact, oncereportLa pipeline di raccolta usa dati Yandex. La domanda su Google, il monitoraggio delle posizioni e la search analytics sono comandi separati del toolkit che lavorano accanto al core.
collect · synonymsFrequenza base, affinamenti e query simili tramite l'API di Yandex Cloud. Servono API key e folder ID; quota oraria.
clusterUna top 10 per frase e regione, in cache con data e regione del recupero. Solo l'endpoint asincrono.
exactLa frequenza esatta !W che l'API di Wordstat non fornisce. Si paga alla creazione del task; il task_id viene conservato, quindi un risultato andato in timeout si recupera di nuovo, non si ricompra.
google-keywordsVolume di ricerca su Google, competizione ed espansione dei seed. Sandbox per impostazione predefinita.
keywords-expand · keywords-seasonality · regions-treeEspandi una frase, leggi la sua domanda per mese, sfoglia l'albero delle regioni (l'albero è gratuito).
topvisor-readLegge progetti, keyword e storico delle posizioni registrate dal tuo account esistente. Dal toolkit non si possono avviare controlli a pagamento.
semantics insightsSegnali settimanali dei cluster da dati che il toolkit ha già sincronizzato in locale. Lo step insights non fa alcuna chiamata ai provider.
Ogni fase a pagamento ha un piano offline: la regione, il motore, la fonte delle query e un limite massimo di richieste o task. Un piano non crea alcun client del provider.
--dry-run --json stampa il piano. L'esecuzione richiede --confirm-paid, anche quando la stima è zero.
I tentativi Wordstat, i recuperi SERP e i task Arsenkin vengono riservati prima della chiamata. Una richiesta ambigua non viene mai reinviata in automatico.
Le SERP in cache e le ricevute dei pagamenti sopravvivono alla sostituzione del pool, quindi un nuovo clustering paga solo le frasi nuove.
Ogni addebito finisce in spend-report con il progetto semantico e la fase a cui appartiene.
Quando il prezzo di un provider non si può stabilire offline, il piano lo dice invece di inventare un numero.
Catturato dal progetto di esempio sintetico incluso nel toolkit. Le frasi sono in russo, come la domanda su Yandex, e le frequenze sono inventate. Nessuna chiamata a pagamento è stata fatta.
$ seohead semantics clean --project ./core
$ seohead semantics graph --project ./core
$ seohead semantics sitematch --project ./core
clean: kept=34 review=4 dropped=3 | lemma groups=41 (median base=720, outlier>36000)
graph: homonyms=0, to review=0, candidate clusters=7 -> anomalies.md
sitematch: catalog terms=11 | off-catalog->review=8 | kept and matching the site=26$ seohead semantics cluster --project ./core --dry-run
"mode": "estimate", "stage": "cluster", "paid": true,
"provider": "yandex_search",
"request_estimate": {"unit": "requests", "count": 26, "kind": "upper_bound"},
"money_estimate": null,
"money_unavailable_reason": "provider pricing is not available from this offline preflight",
"paid_calls_made": 0$ seohead semantics status --project ./core
dropped=3 | kept=26 | review=12 | _total=41 | _exact=0 | _expanded=0 | _clusters=0
provider units: {'yandex_requests': 0, 'arsenkin': 0}
next: seohead semantics exact --project ./core$ seohead semantics export --project ./core --scope no-landing --dry-run
"mode": "preview", "scope": "no-landing", "rows": 41,
"planned_files": ["core/semantics/pool.csv", "core/semantics/pool.json"]seohead semantics status --project ./my-corePrima installa SpiderHead: guida all'installazione. Ogni comando funziona anche come strumento MCP per agenti AI.
Dieci strumenti MCP espongono le stesse fasi e letture. Una chiamata a pagamento restituisce il piano e richiede confirm_paid=true per inviare il lavoro.
seo_semantics_statusContatori, unità del provider e fase successivaseo_semantics_runFasi gratuiteseo_semantics_minePagine dei competitor, nessuna quota del providerseo_semantics_paidFasi a pagamento: prima il piano, poi confirm_paid=trueseo_semantics_clustersElenco dei cluster paginatoseo_semantics_cluster_showUn cluster con le prove della sua landingseo_semantics_cluster_queriesFrasi di un cluster con la top 10 conservataseo_semantics_set_landingAssegna o rimuovi una landing pageseo_semantics_insightsSegnali settimanali per cluster e fonteseo_semantics_insights_tasksI segnali scelti nella checklist