
Crawl budget rispettoso e rate limit

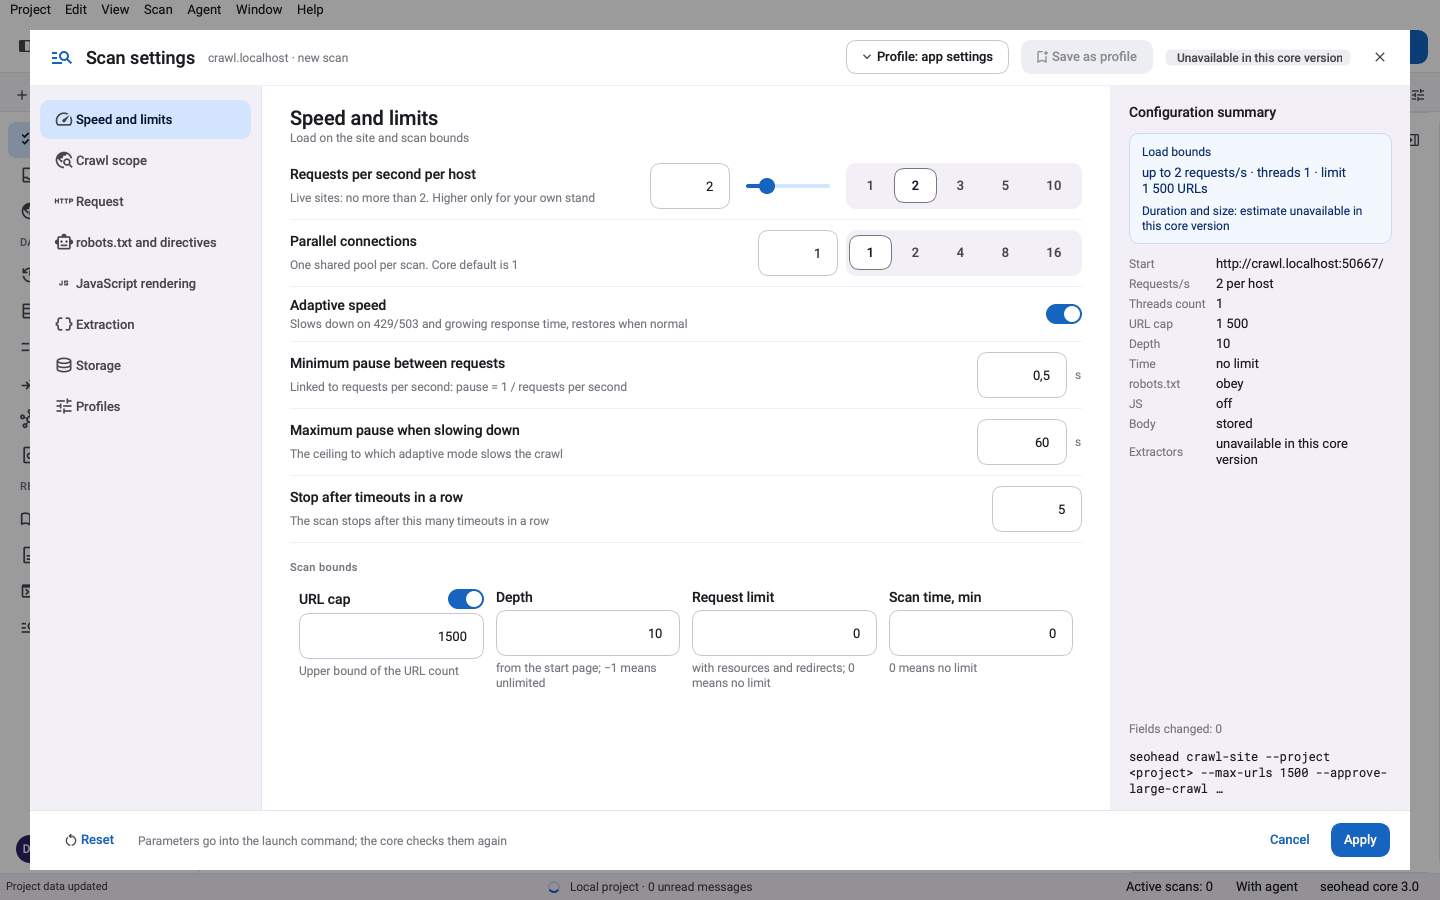
SpiderHead è rispettoso per impostazione predefinita: circa due richieste al secondo per host, richieste limitate e in sola lettura, e un tetto esplicito di URL che è un budget, non una stima della dimensione del sito.

Cosa fa

Budget che decidi tu

Una scansione si ferma ai limiti che le dai: numero di URL (predefinito 200), profondità dei link (predefinita 5), tentativi HTTP totali e un budget facoltativo a tempo. Puoi restringerla con regole di inclusione ed esclusione per pattern di URL, estensione o tipo di media. Superare un budget di progetto richiede --approve-large-crawl.

  • --max-urls è un budget esplicito, non una stima della dimensione del sito
  • La pausa si adatta all'origine: cresce quando il server rallenta o va in timeout

Sicuro per progetto

Gli strumenti di rete bloccano i bersagli privati e locali salvo che tu li autorizzi per nome. Il crawler invia solo richieste limitate e in sola lettura al sito che indichi e si identifica con uno User-Agent. Si ferma anche da solo dopo 5 timeout di fila.

Tre passaggi, una scansione salvata

  1. Imposta un budget di URL

    --max-urls limita le pagine che una scansione scarica (predefinito 200), e superare un budget di progetto richiede --approve-large-crawl.

  2. Dosaggio per ogni host

    La pausa predefinita è di 0,5 secondi tra le richieste, circa due al secondo per host; --max-urls-per-second imposta la frequenza e il back-off adattivo rallenta quando il server è in difficoltà.

  3. Rispetta robots.txt e i bersagli privati

    robots.txt è rispettato per impostazione predefinita e gli indirizzi privati o locali restano bloccati finché non li autorizzi per nome.

Controlli di questa funzionalità

ControlloCosa significaGravitàEvidenza
SLOW_RESPONSEIl server ha impiegato più di 1,5 secondi a rispondereImportantTempo di risposta per pagina contro la soglia di 1,5 s
BLOCKED_BY_ROBOTSLa URL è bloccata da robots.txtImportantURL bloccata dalla scansione o dall'export SF
IMPORTANT_URL_BLOCKED_BY_ROBOTSUna pagina che riceve link interni è bloccata da robots.txt, quindi la scoperta dei link si fermaImportantURL bloccata e suoi inlink interni
ROBOTS_BLOCKS_RESOURCESrobots.txt blocca JavaScript o CSS serviti al rendering della paginaTipURL della risorsa bloccata
SITEMAP_NOT_IN_ROBOTSrobots.txt non contiene la direttiva SitemapTipContenuto di robots.txt

Un solo comando

bash
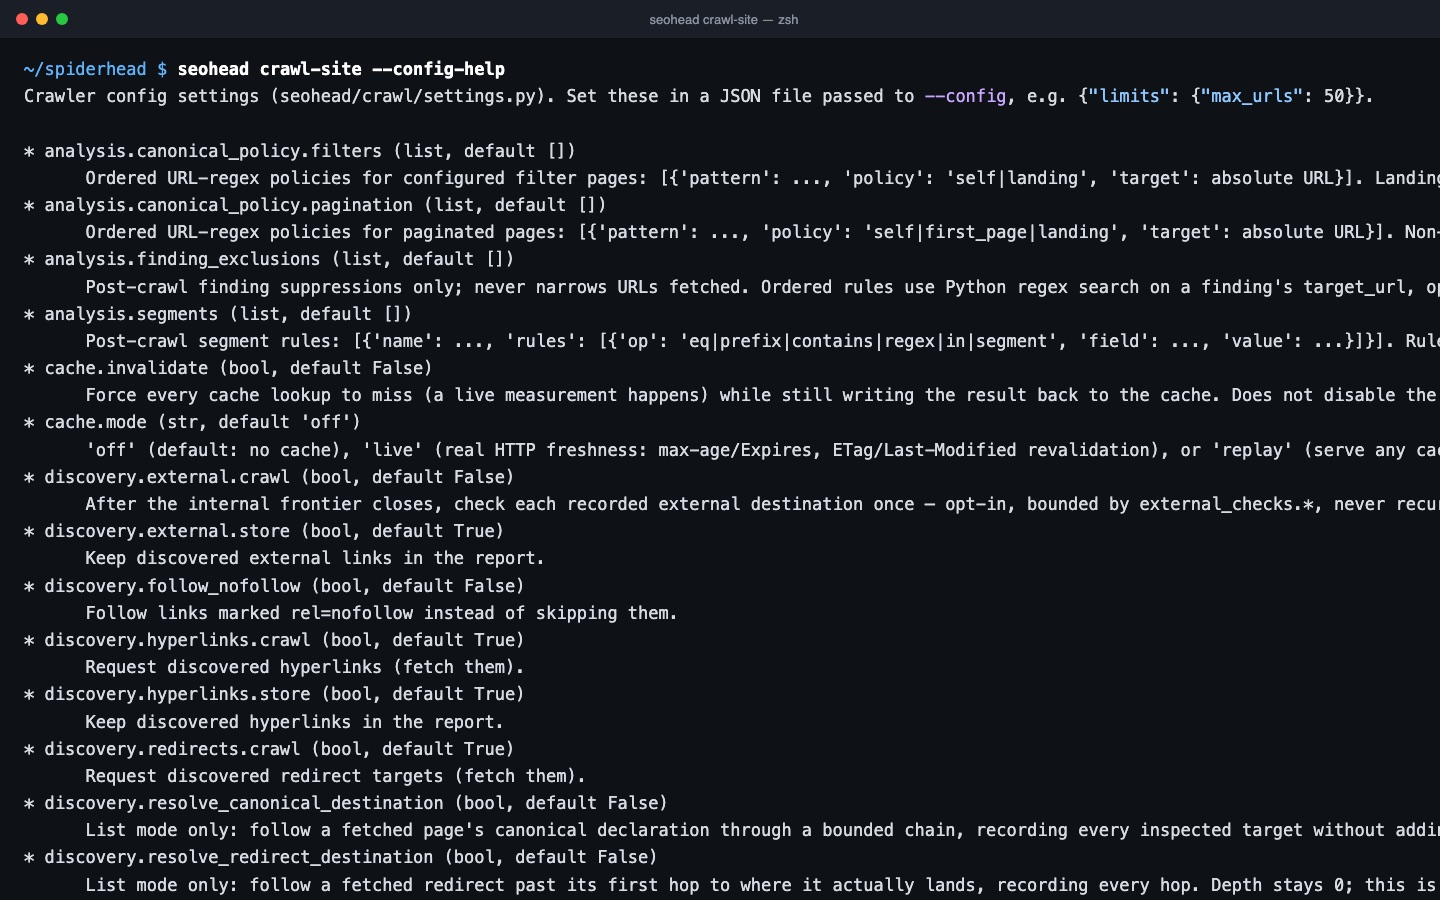
seohead crawl-site --config-help

Prima installa SpiderHead: guida all'installazione. Ogni comando funziona anche come strumento MCP per agenti AI.

Cosa ti serve

  • Una URL di partenza
  • Opzionale: --max-urls e --max-urls-per-second
  • Opzionale: un file di configurazione della scansione per pause, profondità e ambito

Limiti

  • Il limite di frequenza è per host; non conosce la capacità del tuo server
  • Il back-off adattivo reagisce alle risposte lente, non può prevedere il carico
  • --robots ignore salta robots.txt: usalo solo su siti che possiedi

Domande

Il crawler rallenterà il mio sito?
Attende 0,5 secondi tra le richieste per impostazione predefinita e rallenta da solo quando il server risponde piano o va in timeout. Una scansione si ferma dopo 5 timeout di fila.
Rispetta robots.txt?
Sì, per impostazione predefinita. --robots report_only scarica robots.txt, segnala cosa verrebbe bloccato e scansiona comunque. --robots ignore salta del tutto robots.txt, quindi usalo solo su siti che possiedi.
Può scansionare uno staging su un indirizzo privato?
Solo se lo autorizzi. SEOHEAD_ALLOW_PRIVATE_HOSTS ammette host indicati per nome, e SEOHEAD_ALLOW_PRIVATE_NETWORKS=1 apre ogni intervallo privato.
Posso scansionare più in fretta?
Sì. --max-urls-per-second imposta la frequenza massima per host e speed.concurrency alza il numero di richieste in volo (predefinito 1). Il back-off adattivo può comunque rallentare la scansione se il server è in difficoltà. Alza questi valori solo su server che controlli.