Yandex Wordstat
collect · synonymsБазовая частотность, уточнения и похожие запросы через API Yandex Cloud. Нужны API-ключ и ID каталога; почасовая квота.
Сбор, чистка и кластеризация запросов проекта: спрос Wordstat, кластеры по выдаче, точная частотность, анализ конкурентов и офлайн-план перед платным вызовом.
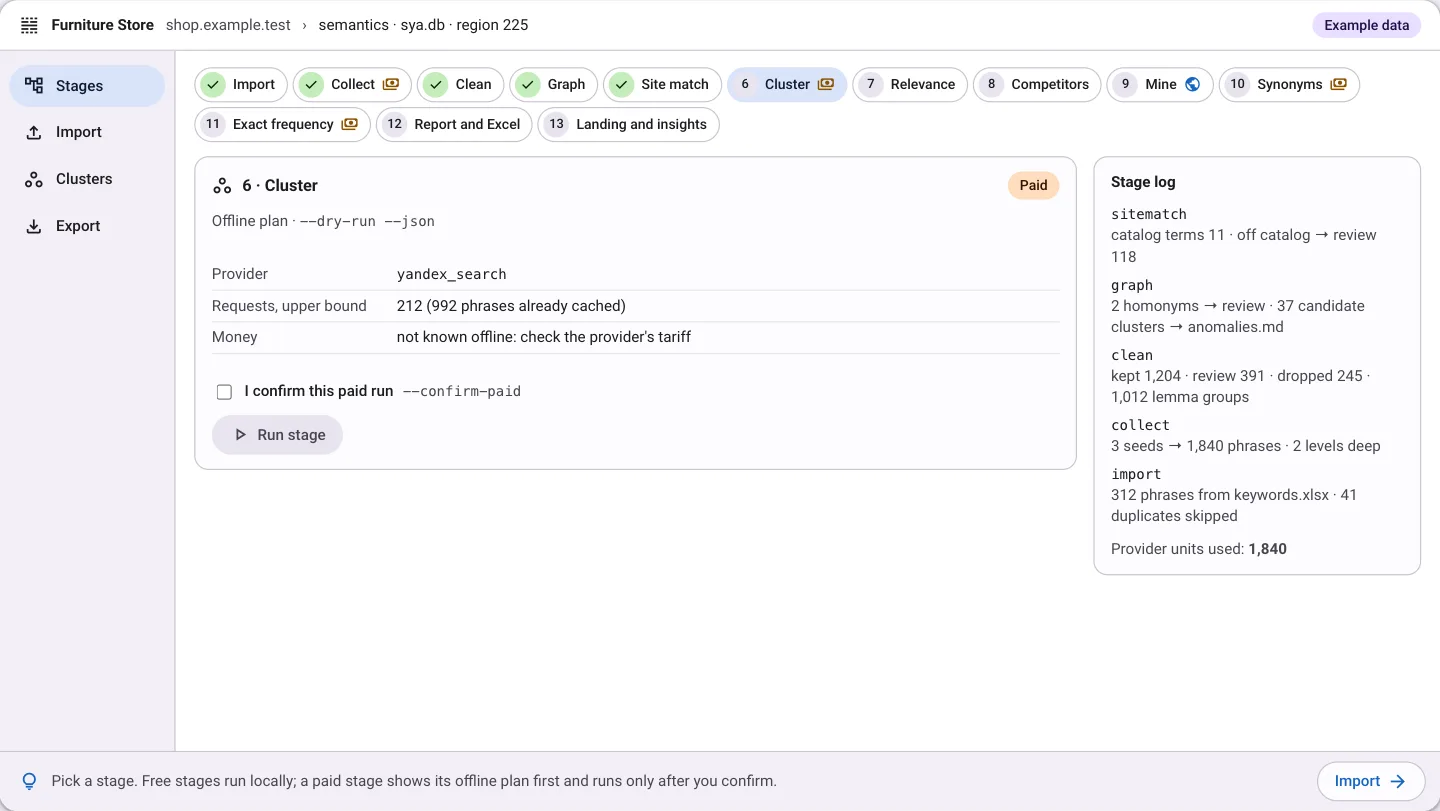
Каждый этап меняет статус и записывает причину, поэтому фраза никогда не удаляется, а любое решение можно объяснить. Бесплатные этапы стоят между платными: вы проверяете пул, прежде чем покупать следующий ответ.
Загрузите то, что уже есть: CSV или один лист XLSX. Сопоставьте query, frequency, group, subgroup, URL и comment, затем добавьте, обновите или замените. Предпросмотр показывает новые, существующие и дублирующиеся строки до записи.
phrasesРасширяет ваши исходные фразы по региону и повторно расширяет сильные до заданной глубины. Очередь дедуплицируется, а --resume продолжает прерванный запуск, не запрашивая ту же фразу повторно.
phrases, expansions, provenanceПрименяет фильтры проекта (интент, стоп-слова, информационные шаблоны), отмечает выбросы по частотности и группирует фразы по леммам. Фразу с наблюдаемыми показами или позициями правила частотности не отсекают никогда.
status, route, lemma groupСтроит граф слов пула. Кандидаты в омонимы уходят на проверку, а кластеры-кандидаты попадают в anomalies.md — до любых новых трат.
anomalies.mdФраза входит в ядро, только если сайт это предлагает. Фразы без единого термина из catalog.txt уходят на проверку как не из каталога.
review listПолучает один топ-10 на фразу и кэширует его, поэтому повторный запуск оплачивает только новые фразы. Фразы с общими страницами образуют кластер; --method louvain перегруппировывает кэшированные результаты и разрывает длинные цепочки.
SERP cache, clusters, landing candidatesЕсли в топ-10 фразы нет ни одного сайта вашего типа из vendors.txt, тема, скорее всего, не по профилю. Фраза уходит на проверку; ничего не удаляется.
review listЧитает кэшированную выдачу: какие домены занимают ваши кластеры и какие слова они используют в заголовках. Кандидаты попадают в synonyms.txt.
competitors.md, synonyms.txtОткрывает самые частые страницы конкурентов из собранной выдачи и читает их title, description, H1 и первые заголовки H2. Тематические фразы из двух и трёх слов попадают в synonyms.txt.
competitor_mining.md, synonyms.txtПроверяет кандидатов из synonyms.txt. В ядро входят только фразы со спросом; затем collect --resume растит пул от них.
checked phrasesПокупает точную частотность !W один раз на группу лемм, в самом конце, когда пул перестал меняться. Сверх бюджетного порога проекта нужен --yes.
exact frequency, task receiptsreport.md и clusters.csv для чтения, книга XLSX (Summary, Core, Info, Clusters, Rejected) для клиента, pool.csv и pool.json для других инструментов.
report.md, XLSX, CSV, JSONПосле запуска выберите целевую страницу каждого кластера из измеренных кандидатов, затем читайте еженедельные сигналы по кластерам из локальных данных Search Console, Вебмастера и Метрики и превращайте выбранные в задачи чек-листа.
landing, weekly signals, tasksЯдро собирают не за один раз. Конкуренты и разбор страниц дают новых кандидатов, синонимы их проверяют, сбор возобновляется, и кластеризация идёт снова. Точную частотность покупают последней.
collectclean · graph · site matchclustercompetitors · minesynonymscollect --resumeexact, oncereportКонвейер сбора работает на данных Яндекса. Спрос Google, отслеживание позиций и поисковая аналитика — отдельные команды тулкита, которые работают рядом с ядром.
collect · synonymsБазовая частотность, уточнения и похожие запросы через API Yandex Cloud. Нужны API-ключ и ID каталога; почасовая квота.
clusterОдин топ-10 на фразу и регион, кэшируется со временем получения и регионом. Только асинхронный эндпоинт.
exactТочная частотность !W, которую не отдаёт API Wordstat. Оплата при создании задачи; task_id сохраняется, поэтому результат после тайм-аута запрашивается снова, а не покупается заново.
google-keywordsОбъём поиска Google, конкуренция и расширение исходных фраз. По умолчанию песочница.
keywords-expand · keywords-seasonality · regions-treeРасширить одну фразу, прочитать её спрос по месяцам, просмотреть дерево регионов (дерево бесплатно).
topvisor-readЧитает проекты, ключевые слова и записанную историю позиций из вашего действующего аккаунта. Платные проверки из тулкита запустить нельзя.
semantics insightsЕженедельные сигналы по кластерам из данных, которые тулкит уже синхронизировал локально. Сам шаг выводов не обращается к провайдерам.
У каждого платного этапа есть офлайн-план: регион, поисковая система, источник запросов и верхняя оценка числа запросов или задач. План не создаёт клиент провайдера.
--dry-run --json печатает план. Сам запуск требует --confirm-paid, даже если оценка равна нулю.
Попытки Wordstat, получения выдачи и задачи Arsenkin резервируются до вызова. Неоднозначный запрос автоматически не отправляется повторно.
Кэшированная выдача и оплаченные квитанции переживают замену пула, поэтому повторная кластеризация оплачивает только новые фразы.
Каждое списание попадает в spend-report с семантическим проектом и этапом, к которым оно относится.
Если цену провайдера нельзя установить офлайн, план так и говорит, а не выдумывает число.
Снято на синтетическом демонстрационном проекте, который поставляется с тулкитом. Его фразы русские, как и спрос в Яндексе, а частотности выдуманы. Платных вызовов не было.
$ seohead semantics clean --project ./core
$ seohead semantics graph --project ./core
$ seohead semantics sitematch --project ./core
clean: kept=34 review=4 dropped=3 | lemma groups=41 (median base=720, outlier>36000)
graph: homonyms=0, to review=0, candidate clusters=7 -> anomalies.md
sitematch: catalog terms=11 | off-catalog->review=8 | kept and matching the site=26$ seohead semantics cluster --project ./core --dry-run
"mode": "estimate", "stage": "cluster", "paid": true,
"provider": "yandex_search",
"request_estimate": {"unit": "requests", "count": 26, "kind": "upper_bound"},
"money_estimate": null,
"money_unavailable_reason": "provider pricing is not available from this offline preflight",
"paid_calls_made": 0$ seohead semantics status --project ./core
dropped=3 | kept=26 | review=12 | _total=41 | _exact=0 | _expanded=0 | _clusters=0
provider units: {'yandex_requests': 0, 'arsenkin': 0}
next: seohead semantics exact --project ./core$ seohead semantics export --project ./core --scope no-landing --dry-run
"mode": "preview", "scope": "no-landing", "rows": 41,
"planned_files": ["core/semantics/pool.csv", "core/semantics/pool.json"]seohead semantics status --project ./my-coreСначала установите: руководство по установке. Каждая команда работает и как MCP-инструмент для ИИ-агентов.
Десять MCP-инструментов открывают те же этапы и чтения. Платный вызов возвращает план и требует confirm_paid=true, чтобы отправить работу.
seo_semantics_statusСчётчики, единицы провайдера и следующий этапseo_semantics_runБесплатные этапыseo_semantics_mineСтраницы конкурентов, без квоты провайдераseo_semantics_paidПлатные этапы: сначала план, затем confirm_paid=trueseo_semantics_clustersСписок кластеров постраничноseo_semantics_cluster_showОдин кластер с доказательствами выбора целевой страницыseo_semantics_cluster_queriesФразы кластера с сохранённым топ-10seo_semantics_set_landingНазначить или снять целевую страницуseo_semantics_insightsЕженедельные сигналы по кластерам и источникамseo_semantics_insights_tasksВыбранные сигналы в чек-лист