Yandex Wordstat
collect · synonymsFrecuencia base, refinamientos y consultas similares a través de la API de Yandex Cloud. Clave de API e ID de carpeta; cuota por hora.
Recopila, depura, agrupa y amplía las palabras clave de un proyecto: Wordstat, clústeres de SERP, frecuencia exacta y competidores, con plan previo antes de pagar.
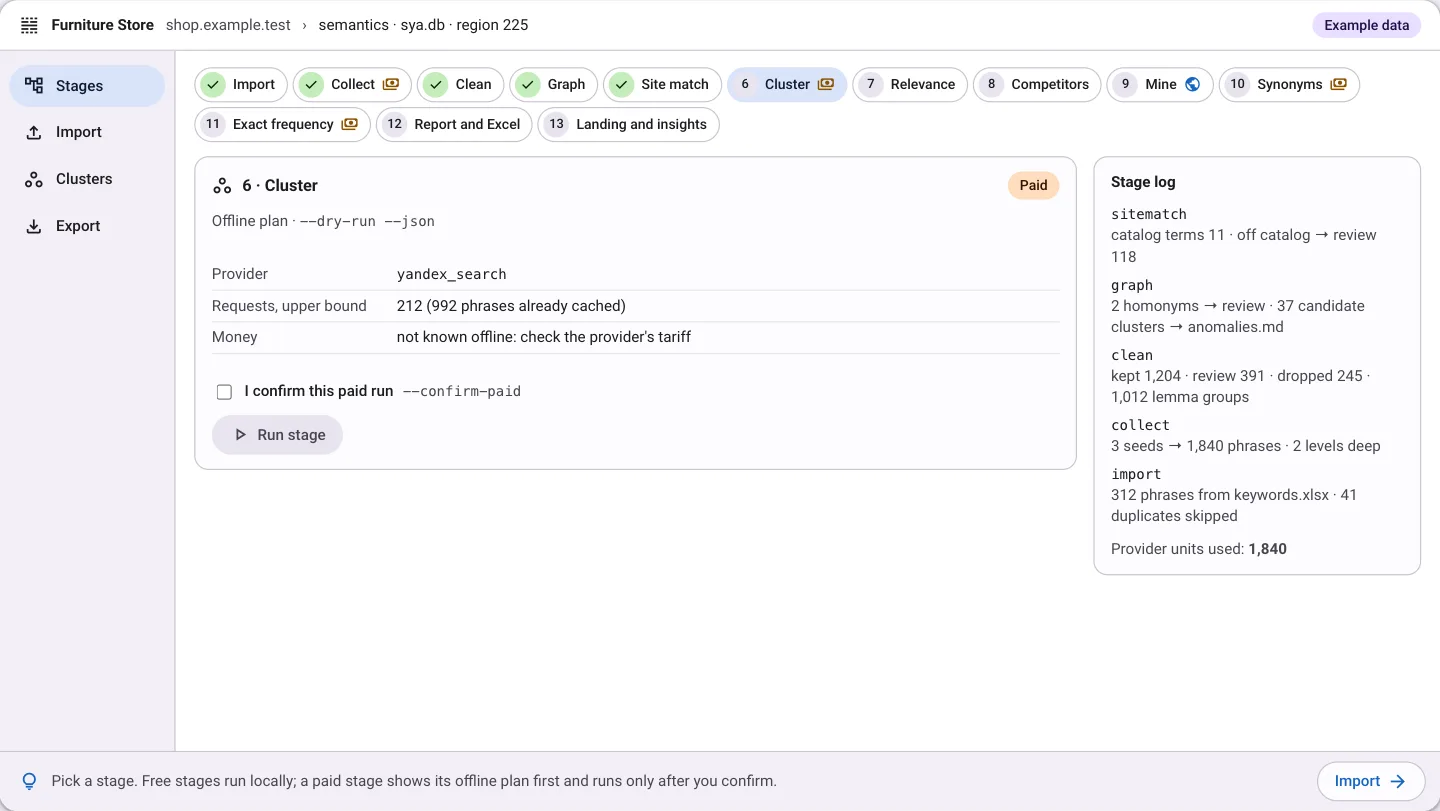
Cada etapa cambia un estado y registra el motivo, así que ninguna frase se borra y toda decisión se puede explicar. Las etapas gratuitas van entre las de pago: revisas el conjunto antes de comprar la siguiente respuesta.
Trae lo que ya tienes: un CSV o una hoja de un XLSX. Asigna query, frequency, group, subgroup, URL y comment, y elige entre add, update o replace. La vista previa muestra las filas nuevas, existentes y duplicadas antes de escribir nada.
phrasesAmplía tus semillas por región y vuelve a ampliar las frases fuertes hasta la profundidad que fijes. La cola se deduplica y --resume continúa una ejecución interrumpida sin pedir de nuevo la misma frase.
phrases, expansions, provenanceAplica los filtros del proyecto (intención, stop words, patrones informacionales), marca los valores atípicos de frecuencia y agrupa las frases por lema. Una frase con impresiones o posiciones observadas nunca se descarta por reglas de frecuencia.
status, route, lemma groupConstruye un grafo de palabras del conjunto. Los candidatos a homónimos pasan a revisión y los clústeres candidatos se guardan en anomalies.md, antes de que pagues por nada más.
anomalies.mdUna frase pertenece al núcleo solo si el sitio la ofrece. Las frases sin ningún término de catalog.txt pasan a revisión como fuera de catálogo.
review listObtiene un top 10 por frase y lo guarda en caché, así que una ejecución repetida solo paga las frases nuevas. Las frases que comparten páginas forman un clúster; --method louvain reagrupa los resultados en caché para romper las cadenas largas.
SERP cache, clusters, landing candidatesSi en el top 10 de una frase no aparece ningún sitio de tu tipo de vendors.txt, el tema probablemente queda fuera de alcance. La frase pasa a revisión; no se borra nada.
review listLee los resultados en caché: qué dominios ocupan tus clústeres y qué palabras usan en los títulos. Los candidatos pasan a synonyms.txt.
competitors.md, synonyms.txtAbre las páginas de la competencia que más se repiten en los resultados recopilados y lee su title, description, H1 y los primeros encabezados H2. Las frases temáticas de dos y tres palabras pasan a synonyms.txt.
competitor_mining.md, synonyms.txtComprueba los candidatos de synonyms.txt. Solo las frases con demanda entran en el núcleo; después collect --resume hace crecer el conjunto a partir de ellas.
checked phrasesCompra la frecuencia exacta !W una vez por grupo de lemas, al final, cuando el conjunto ya no cambia. Por encima del umbral de presupuesto del proyecto requiere --yes.
exact frequency, task receiptsreport.md y clusters.csv para leer, un libro XLSX (Summary, Core, Info, Clusters, Rejected) para el cliente, y pool.csv y pool.json para otras herramientas.
report.md, XLSX, CSV, JSONTras el lanzamiento, elige la landing de cada clúster entre candidatas medidas, lee las señales semanales por clúster a partir de tus datos locales de Search Console, Webmaster y Metrika, y convierte las elegidas en tareas de la lista de comprobación.
landing, weekly signals, tasksEl núcleo no se recopila una sola vez. Los competidores y la minería aportan candidatos nuevos, synonyms los comprueba, la recopilación se reanuda y el clustering vuelve a ejecutarse. La frecuencia exacta se compra al final.
collectclean · graph · site matchclustercompetitors · minesynonymscollect --resumeexact, oncereportLa canalización de recopilación funciona con datos de Yandex. La demanda en Google, el seguimiento de posiciones y la analítica de búsqueda son comandos independientes del toolkit que trabajan junto al núcleo.
collect · synonymsFrecuencia base, refinamientos y consultas similares a través de la API de Yandex Cloud. Clave de API e ID de carpeta; cuota por hora.
clusterUn top 10 por frase y región, guardado en caché con su hora de obtención y su región. Solo el endpoint asíncrono.
exactLa frecuencia exacta !W que la API de Wordstat no ofrece. Se cobra al crear la tarea; el task_id se conserva, así que un resultado con tiempo agotado se vuelve a obtener, no se vuelve a comprar.
google-keywordsVolumen de búsqueda en Google, competencia y ampliación de semillas. Sandbox por defecto.
keywords-expand · keywords-seasonality · regions-treeAmplía una frase, lee su demanda por meses y explora el árbol de regiones (el árbol es gratis).
topvisor-readLee proyectos, palabras clave e historial de posiciones registrado desde tu cuenta existente. Las comprobaciones de pago no se pueden lanzar desde el toolkit.
semantics insightsSeñales semanales por clúster a partir de datos que el toolkit ya sincronizó en local. El propio paso de insights no hace llamadas a proveedores.
Cada etapa de pago tiene un plan sin conexión: la región, el motor, el origen de las consultas y un límite superior de solicitudes o tareas. Un plan no crea ningún cliente de proveedor.
--dry-run --json imprime el plan. La ejecución en sí requiere --confirm-paid, incluso cuando la estimación es cero.
Los intentos de Wordstat, las obtenciones de SERP y las tareas de Arsenkin se reservan antes de la llamada. Una solicitud ambigua nunca se reenvía automáticamente.
Las SERP en caché y los recibos de pago sobreviven a un replace del conjunto, así que volver a agrupar solo paga las frases nuevas.
Cada cargo queda en spend-report con el proyecto semántico y la etapa a la que pertenece.
Cuando el precio de un proveedor no se puede determinar sin conexión, el plan lo dice en lugar de inventar una cifra.
Capturada del proyecto de ejemplo sintético que se incluye con el toolkit. Sus frases están en ruso, como la demanda en Yandex, y sus frecuencias son inventadas. No se hizo ninguna llamada de pago.
$ seohead semantics clean --project ./core
$ seohead semantics graph --project ./core
$ seohead semantics sitematch --project ./core
clean: kept=34 review=4 dropped=3 | lemma groups=41 (median base=720, outlier>36000)
graph: homonyms=0, to review=0, candidate clusters=7 -> anomalies.md
sitematch: catalog terms=11 | off-catalog->review=8 | kept and matching the site=26$ seohead semantics cluster --project ./core --dry-run
"mode": "estimate", "stage": "cluster", "paid": true,
"provider": "yandex_search",
"request_estimate": {"unit": "requests", "count": 26, "kind": "upper_bound"},
"money_estimate": null,
"money_unavailable_reason": "provider pricing is not available from this offline preflight",
"paid_calls_made": 0$ seohead semantics status --project ./core
dropped=3 | kept=26 | review=12 | _total=41 | _exact=0 | _expanded=0 | _clusters=0
provider units: {'yandex_requests': 0, 'arsenkin': 0}
next: seohead semantics exact --project ./core$ seohead semantics export --project ./core --scope no-landing --dry-run
"mode": "preview", "scope": "no-landing", "rows": 41,
"planned_files": ["core/semantics/pool.csv", "core/semantics/pool.json"]seohead semantics status --project ./my-corePrimero, instala SpiderHead: guía de instalación. Cada comando también funciona como herramienta MCP para agentes de IA.
Diez herramientas MCP exponen las mismas etapas y lecturas. Una llamada de pago devuelve el plan y necesita confirm_paid=true para enviar el trabajo.
seo_semantics_statusContadores, unidades de proveedor y la siguiente etapaseo_semantics_runEtapas gratuitasseo_semantics_minePáginas de la competencia, sin cuota de proveedorseo_semantics_paidEtapas de pago: primero el plan, después confirm_paid=trueseo_semantics_clustersLista paginada de clústeresseo_semantics_cluster_showUn clúster con las pruebas de su landingseo_semantics_cluster_queriesFrases de un clúster con el top 10 conservadoseo_semantics_set_landingAsignar o quitar una landingseo_semantics_insightsSeñales semanales por clúster y fuenteseo_semantics_insights_tasksLas señales elegidas pasan a la lista de comprobación