Yandex Wordstat
collect · synonymsFrequência base, refinamentos e consultas parecidas pela API do Yandex Cloud. Chave de API e ID da pasta; cota por hora.
Colete, limpe e clusterize as palavras-chave do projeto: Wordstat, clusters de SERP e frequência exata, com plano offline antes de cada chamada paga.
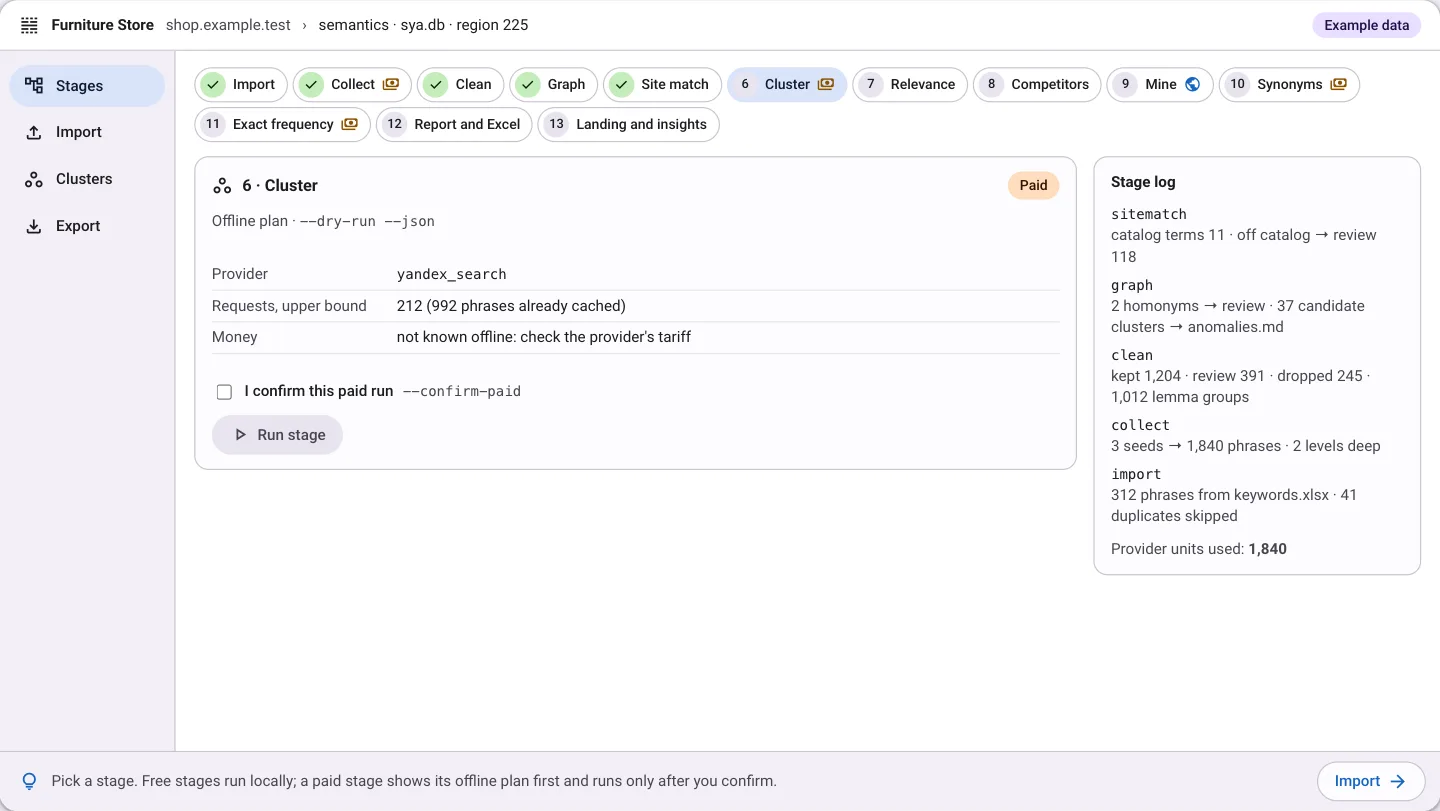
Cada etapa muda um status e registra o motivo, então nenhuma frase é apagada e toda decisão pode ser explicada. As etapas gratuitas ficam entre as pagas, para você conferir o conjunto antes de comprar a próxima resposta.
Traga o que você já tem: um CSV ou uma planilha de um XLSX. Mapeie query, frequency, group, subgroup, URL e comment e depois adicione, atualize ou substitua. A prévia mostra as linhas novas, existentes e duplicadas antes de gravar qualquer coisa.
phrasesExpande suas sementes por região e expande de novo as frases fortes até a profundidade definida. A fila é deduplicada, e --resume continua uma execução interrompida sem pedir a mesma frase outra vez.
phrases, expansions, provenanceAplica os filtros do projeto (intenção, stop words, padrões informacionais), sinaliza frequências atípicas e agrupa as frases por lema. Uma frase com impressões ou posições observadas nunca é cortada por regras de frequência.
status, route, lemma groupMonta um grafo de palavras do conjunto. Candidatas a homônimos vão para revisão e os clusters candidatos vão para anomalies.md, antes de você pagar por qualquer outra coisa.
anomalies.mdUma frase só entra no núcleo se o site a oferece. Frases sem nenhum termo de catalog.txt vão para revisão como fora do catálogo.
review listBusca um top 10 por frase e o guarda em cache, então uma nova execução paga só pelas frases novas. Frases que compartilham páginas formam um cluster; --method louvain reagrupa os resultados em cache para quebrar cadeias longas.
SERP cache, clusters, landing candidatesSe nenhum site do seu tipo de vendors.txt aparece no top 10 de uma frase, o tema provavelmente está fora do escopo. A frase vai para revisão; nada é apagado.
review listLê os resultados em cache: quais domínios dominam seus clusters e quais palavras usam nos títulos. Os candidatos vão para synonyms.txt.
competitors.md, synonyms.txtAbre as páginas de concorrentes mais frequentes dos resultados coletados e lê title, description, H1 e os primeiros H2. Frases temáticas de duas e três palavras vão para synonyms.txt.
competitor_mining.md, synonyms.txtVerifica os candidatos de synonyms.txt. Só frases com demanda entram no núcleo; depois collect --resume faz o conjunto crescer a partir delas.
checked phrasesCompra a frequência exata !W uma vez por grupo de lemas, no fim, quando o conjunto parou de mudar. Acima do limite de orçamento do projeto, exige --yes.
exact frequency, task receiptsreport.md e clusters.csv para leitura, uma planilha XLSX (Summary, Core, Info, Clusters, Rejected) para o cliente, pool.csv e pool.json para outras ferramentas.
report.md, XLSX, CSV, JSONDepois do lançamento, escolha a landing page de cada cluster entre candidatas medidas, depois leia os sinais semanais dos clusters a partir dos seus dados locais do Search Console, Webmaster e Metrika e transforme os escolhidos em tarefas do checklist.
landing, weekly signals, tasksO núcleo não se coleta de uma vez. Concorrentes e mineração trazem novos candidatos, a etapa de sinônimos os verifica, a coleta continua e a clusterização roda de novo. A frequência exata é comprada por último.
collectclean · graph · site matchclustercompetitors · minesynonymscollect --resumeexact, oncereportO pipeline de coleta roda com dados do Yandex. Demanda do Google, monitoramento de posições e análise de busca são comandos separados do toolkit, que funcionam ao lado do núcleo.
collect · synonymsFrequência base, refinamentos e consultas parecidas pela API do Yandex Cloud. Chave de API e ID da pasta; cota por hora.
clusterUm top 10 por frase e região, guardado em cache com o horário e a região da busca. Somente o endpoint assíncrono.
exactA frequência exata !W que a API do Wordstat não fornece. Cobrada na criação da tarefa; o task_id é guardado, então um resultado que expirou é buscado de novo, não comprado de novo.
google-keywordsVolume de busca, concorrência e expansão de sementes do Google. Sandbox por padrão.
keywords-expand · keywords-seasonality · regions-treeExpanda uma frase, leia a demanda dela por mês, navegue pela árvore de regiões (a árvore é gratuita).
topvisor-readLê projetos, palavras-chave e o histórico de posições registrado na sua conta existente. Verificações pagas não podem ser iniciadas pelo toolkit.
semantics insightsSinais semanais dos clusters a partir de dados que o toolkit já sincronizou localmente. A etapa de insights em si não faz nenhuma chamada a provedores.
Toda etapa paga tem um plano offline: a região, o mecanismo, a origem das consultas e um limite máximo de requisições ou tarefas. Um plano não cria nenhum cliente de provedor.
--dry-run --json imprime o plano. A execução em si exige --confirm-paid, mesmo quando a estimativa é zero.
Tentativas do Wordstat, buscas de SERP e tarefas do Arsenkin são reservadas antes da chamada. Uma requisição ambígua nunca é reenviada automaticamente.
SERPs em cache e recibos pagos sobrevivem à substituição do conjunto, então clusterizar de novo paga só pelas frases novas.
Cada cobrança vai para spend-report com o projeto semântico e a etapa a que pertence.
Quando o preço de um provedor não pode ser determinado offline, o plano diz isso em vez de chutar um número.
Capturada do projeto de exemplo sintético que acompanha o toolkit. As frases estão em russo, como a demanda do Yandex, e as frequências são inventadas. Nenhuma chamada paga foi feita.
$ seohead semantics clean --project ./core
$ seohead semantics graph --project ./core
$ seohead semantics sitematch --project ./core
clean: kept=34 review=4 dropped=3 | lemma groups=41 (median base=720, outlier>36000)
graph: homonyms=0, to review=0, candidate clusters=7 -> anomalies.md
sitematch: catalog terms=11 | off-catalog->review=8 | kept and matching the site=26$ seohead semantics cluster --project ./core --dry-run
"mode": "estimate", "stage": "cluster", "paid": true,
"provider": "yandex_search",
"request_estimate": {"unit": "requests", "count": 26, "kind": "upper_bound"},
"money_estimate": null,
"money_unavailable_reason": "provider pricing is not available from this offline preflight",
"paid_calls_made": 0$ seohead semantics status --project ./core
dropped=3 | kept=26 | review=12 | _total=41 | _exact=0 | _expanded=0 | _clusters=0
provider units: {'yandex_requests': 0, 'arsenkin': 0}
next: seohead semantics exact --project ./core$ seohead semantics export --project ./core --scope no-landing --dry-run
"mode": "preview", "scope": "no-landing", "rows": 41,
"planned_files": ["core/semantics/pool.csv", "core/semantics/pool.json"]seohead semantics status --project ./my-coreInstale primeiro: guia de instalação. Todo comando também funciona como ferramenta MCP para agentes de IA.
Dez ferramentas MCP expõem as mesmas etapas e leituras. Uma chamada paga devolve o plano e precisa de confirm_paid=true para enviar o trabalho.
seo_semantics_statusContadores, unidades do provedor e a próxima etapaseo_semantics_runEtapas gratuitasseo_semantics_minePáginas de concorrentes, sem cota de provedorseo_semantics_paidEtapas pagas: primeiro o plano, depois confirm_paid=trueseo_semantics_clustersLista de clusters paginadaseo_semantics_cluster_showUm cluster com as evidências da landing pageseo_semantics_cluster_queriesFrases de um cluster com o top 10 guardadoseo_semantics_set_landingDefinir ou limpar uma landing pageseo_semantics_insightsSinais semanais por cluster e fonteseo_semantics_insights_tasksSinais escolhidos para o checklist