
Extracción personalizada de páginas rastreadas

Los selectores de contenido y las reglas de extracción declarativas se aplican sobre los cuerpos de página conservados, y la búsqueda en el HTML del rastreo guardado localiza qué páginas incluyen un marcador, como un fragmento de GTM.

Qué hace

Reglas de extracción

Las reglas son datos simples, no código: cada una tiene un tipo (text, attribute, structured, presence o count), un selector y un operador (equals, contains, matches o exists). El operador matches usa un patrón glob con límites, no una expresión regular. scan-extract aplica las reglas sobre los cuerpos de página conservados sin red y sin escribir nada, así que puedes cambiar una regla y volver a ejecutarla sin rastrear de nuevo. Para previsualizar extractores CSS, XPath o de expresiones regulares sobre HTML que pegues, usa custom-extract-sample.

Buscar en el HTML guardado

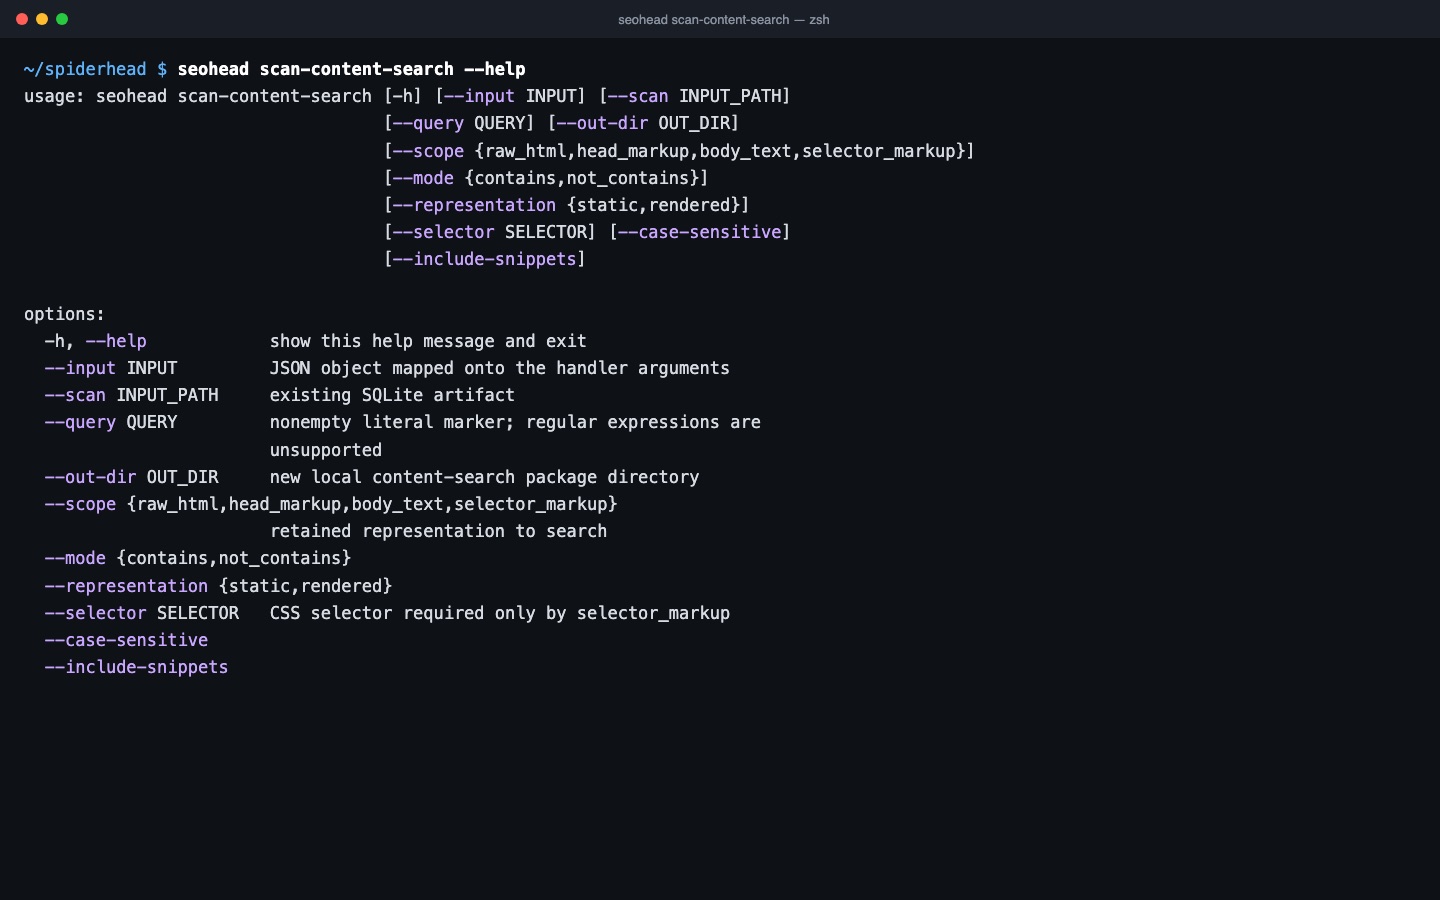
scan-content-search busca una cadena o una expresión regular en el HTML sin procesar, en el marcado del head, en el texto del body o en el marcado que coincide con un selector CSS. Úsalo para saber qué páginas incluyen un marcador, como un fragmento de GTM. Escribe las coincidencias en un paquete local nuevo, así que el resultado queda guardado.

  • Consulta literal o por expresión regular, sobre HTML sin procesar o sobre el DOM renderizado
  • Los resultados se leen de 100 en 100 registros con scan-content-search-page

Tres pasos, un análisis guardado

  1. Rastrea una vez y conserva los cuerpos

    Un rastreo guardado conserva los cuerpos completos de las páginas dentro del límite de retención de cuerpos. Las reglas y las búsquedas se ejecutan sobre esa copia, no sobre el sitio en directo.

  2. Ejecuta las reglas de extracción sin conexión

    Escribe las reglas en JSON, con kind text, attribute, structured, presence o count, y operator equals, contains, matches (un glob) o exists. Pásalas a seohead scan-extract con --input o con la herramienta MCP; no se descarga nada y el resultado no se guarda.

  3. Busca un marcador en el HTML guardado

    scan-content-search encuentra una cadena literal o una expresión regular en el HTML sin procesar, en el marcado del head, en el texto del body o en un selector CSS, y escribe un paquete local. Léelo de 100 filas en 100 con scan-content-search-page.

Comprobaciones de esta función

ComprobaciónQué significaGravedadEvidencia
TITLE_MISSINGFalta el elemento title. Una regla de tipo text sobre el selector del título localiza el mismo hueco en todo el rastreo guardado.CriticalURL de la página; el elemento title no existe o está vacío
CANONICAL_MISSINGLa página indexable no tiene URL canónica. Una regla presence sobre link[rel=canonical] lista las páginas que no la tienen.ImportantURL de la página; no se ha encontrado enlace canónico
SCHEMA_VALIDATION_ERRORErrores de validación de datos estructurados. Una regla structured con un puntero JSON te permite leer los valores de JSON-LD detrás del error.ImportantURL de la página y el elemento de datos estructurados que falla
STRUCTURED_DATA_MISSINGFaltan datos estructurados en las páginas donde los esperas. Una regla presence sobre el bloque JSON-LD muestra las páginas que no tienen ninguno.TipURL de la página; no se han encontrado datos estructurados
LOREM_IPSUM_PLACEHOLDERAparece texto de relleno Lorem Ipsum en el área de contenido de la página. Una búsqueda de contenido por la frase de relleno la localiza en todo el rastreo.ImportantURL de la página y número de coincidencias del texto de relleno

Un solo comando

bash
seohead scan-content-search --scan ./scans/audit.sqlite --query gtm.js

Primero, instala SpiderHead: guía de instalación. Cada comando también funciona como herramienta MCP para agentes de IA.

Qué necesitas

  • Un rastreo guardado (SQLite) con cuerpos de página conservados
  • Para extraer: una lista JSON de reglas, pasada con --input o con la herramienta MCP
  • Para buscar: una cadena o una expresión regular, y una carpeta de salida nueva

Límites

  • Solo se pueden buscar o extraer las páginas cuyo cuerpo se haya conservado
  • Las reglas de extracción no tienen campo de expresión regular; para expresiones regulares usa la búsqueda de contenido
  • Una coincidencia indica que el código está en el HTML, no que una etiqueta se haya disparado para un visitante
  • El contenido renderizado solo se puede buscar si el rastreo guardó una copia renderizada

Preguntas

¿La extracción vuelve a descargar el sitio?
No. scan-extract y scan-content-search leen los cuerpos conservados en el archivo del rastreo guardado. Nunca descargan una URL, así que puedes cambiar una regla y volver a ejecutarla sin un nuevo rastreo.
Si encuentro una etiqueta de GTM, ¿se ha disparado?
No necesariamente. Una coincidencia indica que la etiqueta está en el HTML. No demuestra que se haya disparado para un visitante. La búsqueda informa de dónde está el código.
¿Qué pasa si no se conservó el cuerpo de una página?
La página aparece como desconocida, no como ausente. Una búsqueda nunca dice que un marcador no existe si el cuerpo no está en el rastreo.
¿Se guarda el resultado de la extracción?
scan-extract no guarda su resultado; lo muestra solo en esa ejecución. scan-content-search escribe un paquete local nuevo, así que conservas sus coincidencias.
¿Puedo usar expresiones regulares?
En la búsqueda de contenido, sí: --kind regex acepta una expresión regular de Python. Si una página supera el tiempo límite de la expresión regular, o la plataforma no puede aplicarlo, aparece como no disponible, no como una no coincidencia. Las reglas de extracción no aceptan expresiones regulares.

Pruébalo en tu propio sitio