
Extração personalizada de páginas rastreadas

Seletores de conteúdo e regras declarativas de extração rodam sobre o HTML retido das páginas, e a busca no código-fonte de scans salvos encontra quais páginas trazem um marcador, como um snippet do GTM.

O que faz

Regras de extração

As regras são dados simples, não código: cada uma tem um kind (text, attribute, structured, presence ou count), um seletor e um operador (equals, contains, matches ou exists). O operador matches usa um padrão glob limitado, não uma expressão regular. O scan-extract roda as regras sobre o HTML retido, sem rede e sem gravar nada. Assim, você muda uma regra e a executa de novo, sem rastrear o site outra vez. Para testar extratores CSS, XPath ou regex em um HTML colado, use o custom-extract-sample.

Buscar no HTML salvo

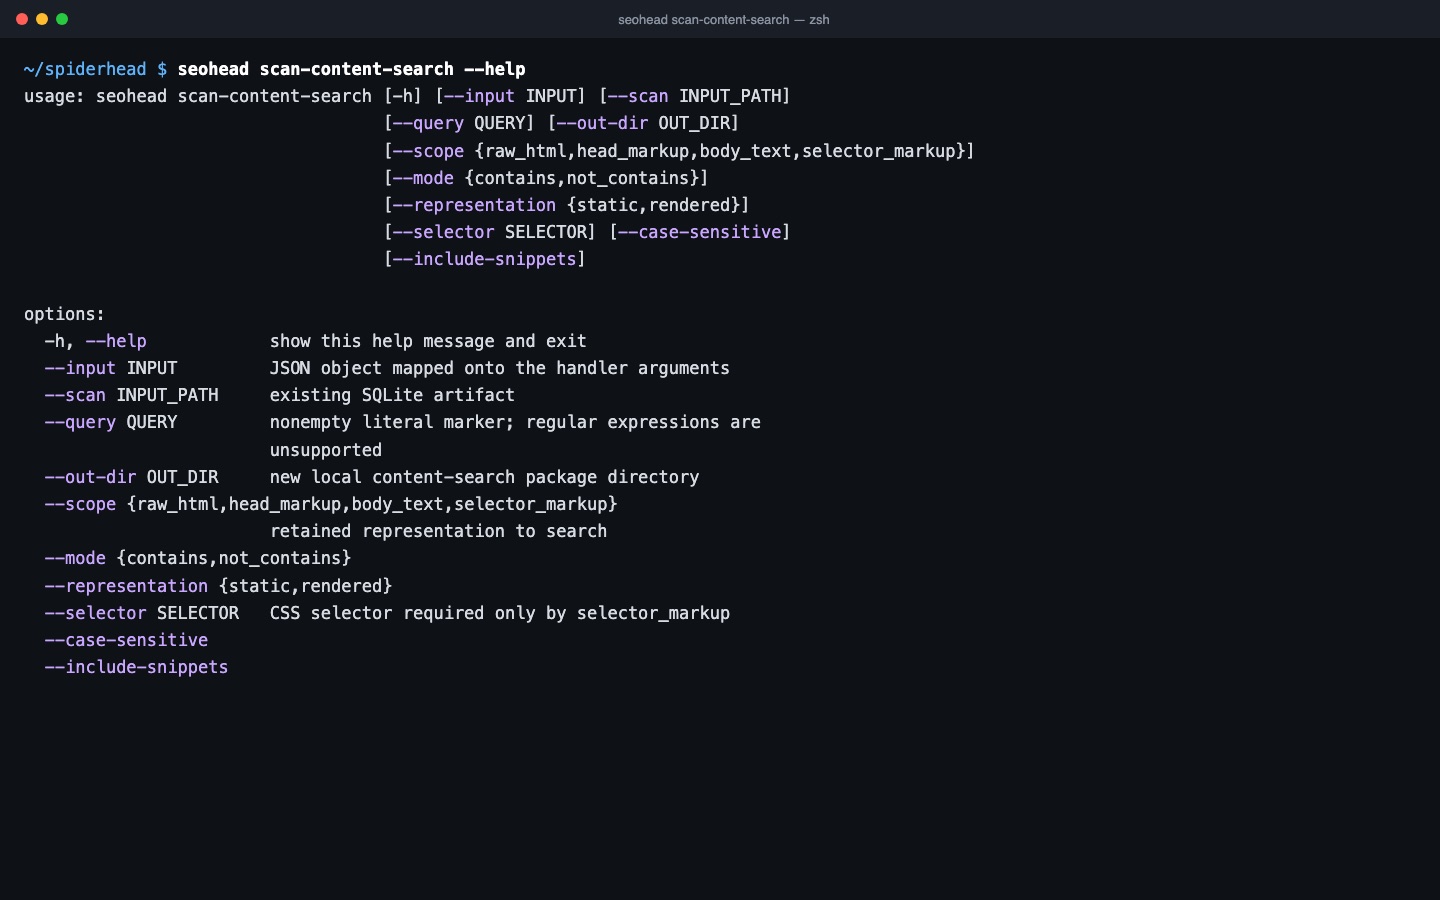
O scan-content-search encontra uma string ou uma expressão regular no HTML bruto, na marcação do head, no texto do body ou na marcação que casa com um seletor CSS. Use-o para descobrir quais páginas trazem um marcador, como um snippet do GTM. Ele grava as ocorrências em um novo pacote local, e o resultado fica guardado com você.

  • Consulta literal ou regex, no HTML bruto ou no DOM renderizado
  • Os resultados são lidos 100 registros por vez com o scan-content-search-page

Três passos, um rastreamento salvo

  1. Rastreie uma vez e guarde o HTML

    Um scan salvo guarda o HTML completo das páginas dentro do limite de retenção. As regras e as buscas rodam sobre essa cópia, e não sobre o site ao vivo.

  2. Rode as regras de extração offline

    Escreva as regras em JSON com kind text, attribute, structured, presence ou count, e operador equals, contains, matches (um glob) ou exists. Passe-as ao seohead scan-extract por --input ou pela ferramenta MCP. Nada é baixado e o resultado não é salvo.

  3. Busque um marcador no HTML salvo

    O scan-content-search encontra uma string literal ou uma regex no HTML bruto, na marcação do head, no texto do body ou em um seletor CSS, e grava um pacote local. Leia 100 linhas por vez com o scan-content-search-page.

Verificações deste recurso

VerificaçãoO que significaGravidadeEvidência
TITLE_MISSINGO elemento title está ausente. Uma regra kind text no seletor title encontra a mesma falha em todo o scan salvo.CriticalURL da página; o elemento title está ausente ou vazio
CANONICAL_MISSINGA página indexável não tem URL canônica. Uma regra presence em link[rel=canonical] lista as páginas que não a têm.ImportantURL da página; nenhum link canonical encontrado
SCHEMA_VALIDATION_ERRORErros de validação de dados estruturados. Uma regra structured com um JSON pointer permite ler os valores do JSON-LD por trás do erro.ImportantURL da página e o item de dados estruturados com erro
STRUCTURED_DATA_MISSINGDados estruturados estão ausentes nas páginas em que você os espera. Uma regra presence no bloco JSON-LD mostra as páginas que não têm nenhum.TipURL da página; nenhum dado estruturado encontrado
LOREM_IPSUM_PLACEHOLDERTexto de preenchimento Lorem Ipsum aparece na área de conteúdo da página. Uma busca de conteúdo pela frase de preenchimento encontra o problema em todo o scan.ImportantURL da página e a quantidade de ocorrências do texto de preenchimento

Um comando

bash
seohead scan-content-search --scan ./scans/audit.sqlite --query gtm.js

Instale primeiro: guia de instalação. Todo comando também funciona como ferramenta MCP para agentes de IA.

O que você precisa

  • Um scan salvo (SQLite) com o HTML das páginas retido
  • Para extração: uma lista JSON de regras, passada por --input ou pela ferramenta MCP
  • Para busca: uma string ou expressão regular, e uma nova pasta de saída

Limites

  • Só dá para buscar ou extrair em páginas cujo HTML foi retido
  • As regras de extração não têm campo de regex; para expressões regulares, use a busca de conteúdo
  • Uma ocorrência mostra que o código está no HTML, não que uma tag disparou para um visitante
  • O conteúdo renderizado só é pesquisável se o scan tiver guardado uma cópia renderizada

Perguntas

A extração baixa o site de novo?
Não. O scan-extract e o scan-content-search leem os HTMLs retidos no arquivo do scan salvo. Eles nunca buscam uma URL, então você pode mudar uma regra e executá-la de novo sem um novo rastreamento.
Se encontrar uma tag do GTM, ela disparou?
Não necessariamente. Uma ocorrência na busca mostra que a tag está no HTML. Ela não prova que disparou para um visitante. A busca informa onde o código está presente.
O que acontece se o HTML da página não foi retido?
A página aparece como unknown (status desconhecido), e não como sem marcador. A busca nunca diz que um marcador não existe quando o HTML não está no scan.
O resultado da extração é salvo?
O scan-extract não salva o resultado; ele o imprime só para aquela execução. O scan-content-search grava um novo pacote local, e as ocorrências ficam com você.
Posso usar expressões regulares?
Na busca de conteúdo, sim: --kind regex aceita uma expressão regular do Python. Se uma página ultrapassar o limite de tempo da regex, ou a plataforma não conseguir aplicar esse limite, ela aparece como indisponível, e não como sem ocorrência. As regras de extração não aceitam regex.

Teste no seu próprio site