Своя экстракция со обойдённых страниц
CSS-селекторы и декларативные правила экстракции работают по сохранённым телам страниц, а поиск по исходникам скана находит, на каких страницах стоит маркер — например, сниппет GTM.
Своя экстракция со обойдённых страниц
Правила экстракции
Декларативные правила по сохранённым телам — извлекайте заново без повторного обхода.
Поиск по сохранённому HTML
Найдите все страницы, содержащие строку или шаблон, в сохранённом скане.
- scan-content-search
- Ограниченные, пагинированные результаты
Три шага — один сохранённый скан
Обойдите один раз и сохраните тела
Сохранённый скан держит полные тела страниц в пределах лимита хранения. Правила и поиски идут по этой копии, а не по живому сайту.
Запустите правила офлайн
Правила пишутся JSON-ом с типом text, attribute, structured, presence или count и оператором equals, contains, matches или exists. Запуск — seohead scan extract; ничего не скачивается, результат не сохраняется.
Найдите маркер в сохранённом HTML
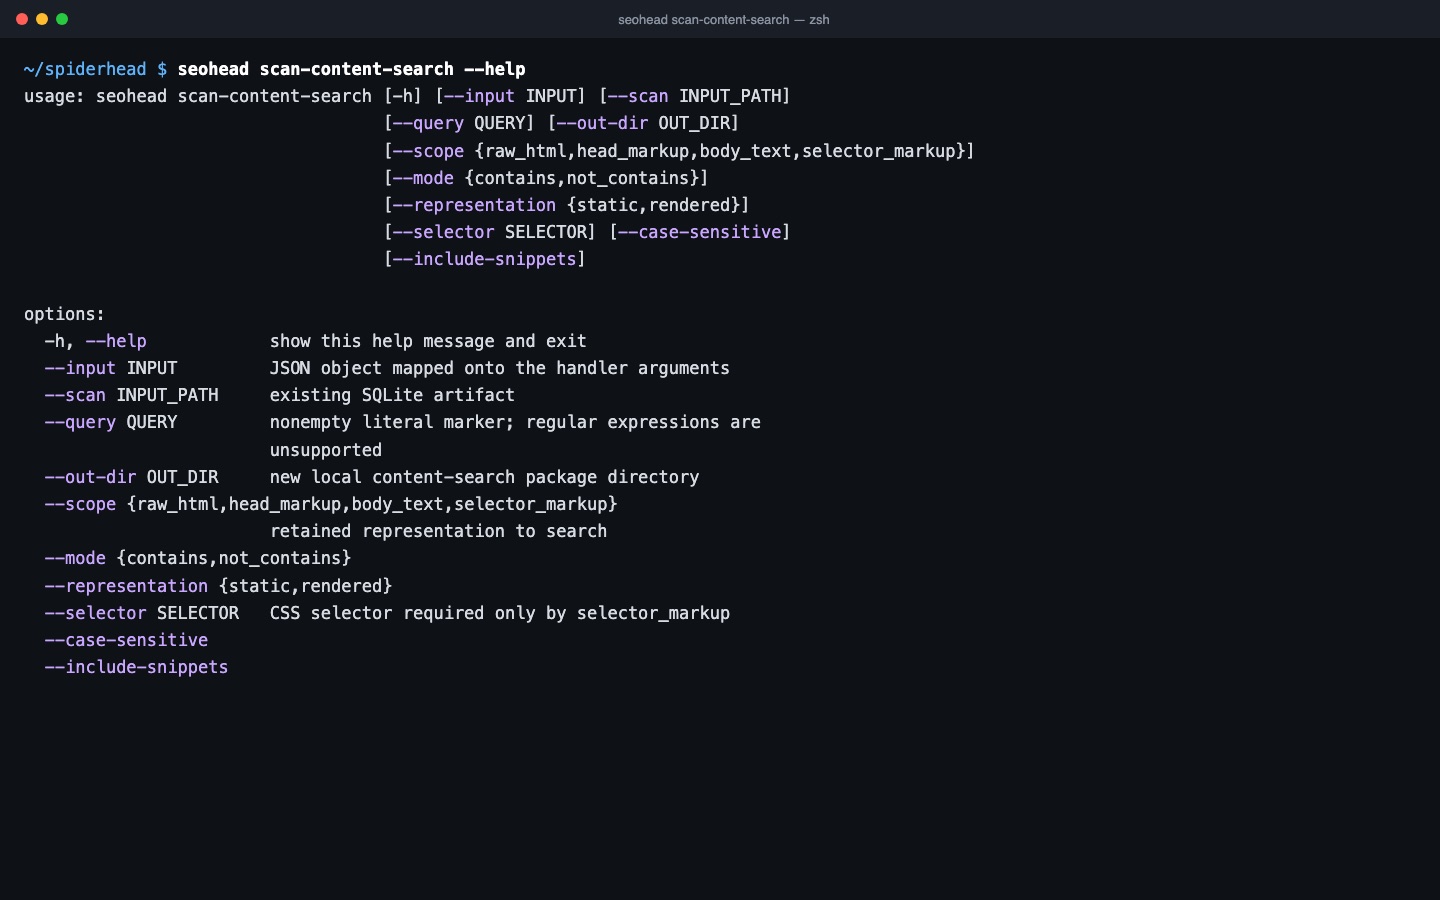
scan-content-search ищет строку или регулярку в сыром HTML, разметке head, тексте body или CSS-селекторе и пишет локальный пакет. Читайте по 100 строк за раз через scan-content-search-page.
Проверки в этой возможности
| Проверка | Что значит | Критичность | Доказательство |
|---|---|---|---|
TITLE_MISSING | Элемент title отсутствует. Правило kind text по селектору title найдёт тот же пробел по всему скану. | Critical | Строка реестра docs/CHECKS.md: критичность critical, исправление: добавить уникальный описательный тайтл. |
CANONICAL_MISSING | У индексируемой страницы нет canonical. Правило presence по link[rel=canonical] перечислит страницы без него. | Important | Строка реестра docs/CHECKS.md: критичность warning (маппинг в Important). |
SCHEMA_VALIDATION_ERROR | Ошибки валидации структурированных данных. Правило structured с JSON-pointer прочитает значения JSON-LD за ошибкой. | Important | Строка реестра docs/CHECKS.md: критичность warning, источник SF Structured Data Validation Errors. |
STRUCTURED_DATA_MISSING | Структурированных данных нет там, где вы их ждёте. Правило presence по блоку JSON-LD покажет страницы без него. | Tip | Строка реестра docs/CHECKS.md: критичность notice (маппинг в Tip). |
LOREM_IPSUM_PLACEHOLDER | В контентной области страницы плейсхолдер Lorem Ipsum. Поиск по контенту найдёт фразу по всему скану. | Important | Строка реестра docs/CHECKS.md: критичность warning, источник crawl:lorem_ipsum_count. |
Одна команда
seohead scan-content-search --scan ./scans/audit.sqlite --query gtm.jsСначала установите: руководство по установке. Каждая команда работает и как MCP-инструмент для ИИ-агентов.