
URL-Verlauf über Scans hinweg

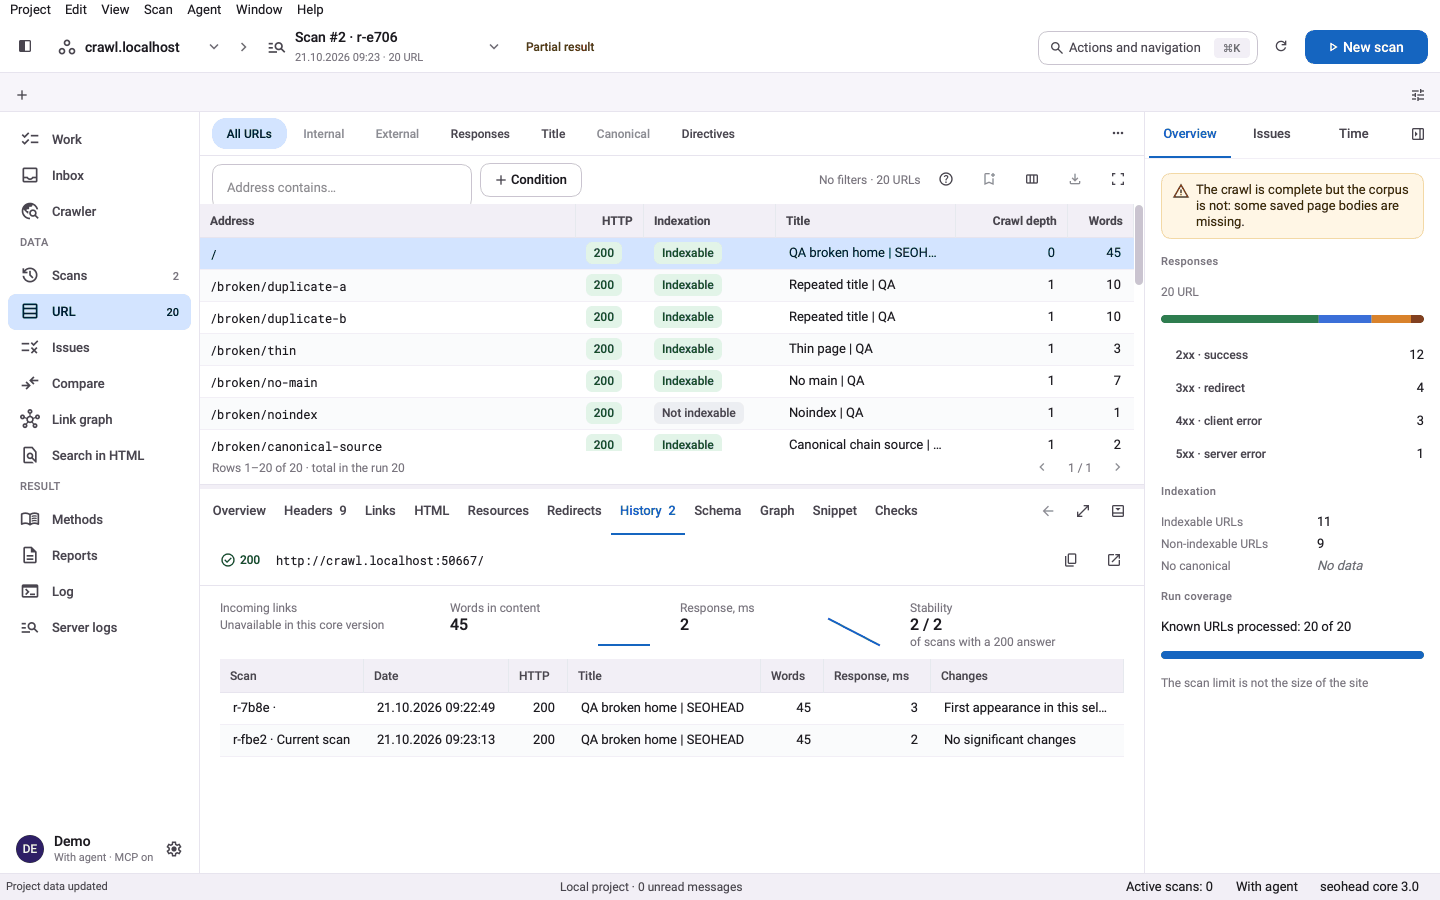
Sehen Sie, wie sich eine URL über die Scans eines Projekts verändert hat: Status, Indexierbarkeit, Title, Meta-Description, H1, Canonical, Weiterleitungsziel und Body. Vergleichen Sie den Body zwischen zwei Scans.

Was es leistet

Eine URL über mehrere Scans

scan-url-history liest die neuesten gespeicherten Scans eines Projekts und zeigt den Zustand einer exakten URL in jedem davon. Scans ohne diese URL werden als nicht vorhanden markiert. Benachbarte Scans werden nur Feld für Feld verglichen, wenn beide eine lesbare Beobachtung enthalten.

  • Felder: Status, Indexierbarkeit, Title, Meta-Description, H1, Canonical, Weiterleitungsziel, Wortanzahl, Antwortzeit, HTML-Größe und Body-Hash.
  • Die Anzahl der Inlinks und Outlinks ist enthalten. Ein Vergleich Link für Link ist es nicht.
  • Eine Lücke zwischen Scans wird als nicht vergleichbar markiert.

Body-Vergleich

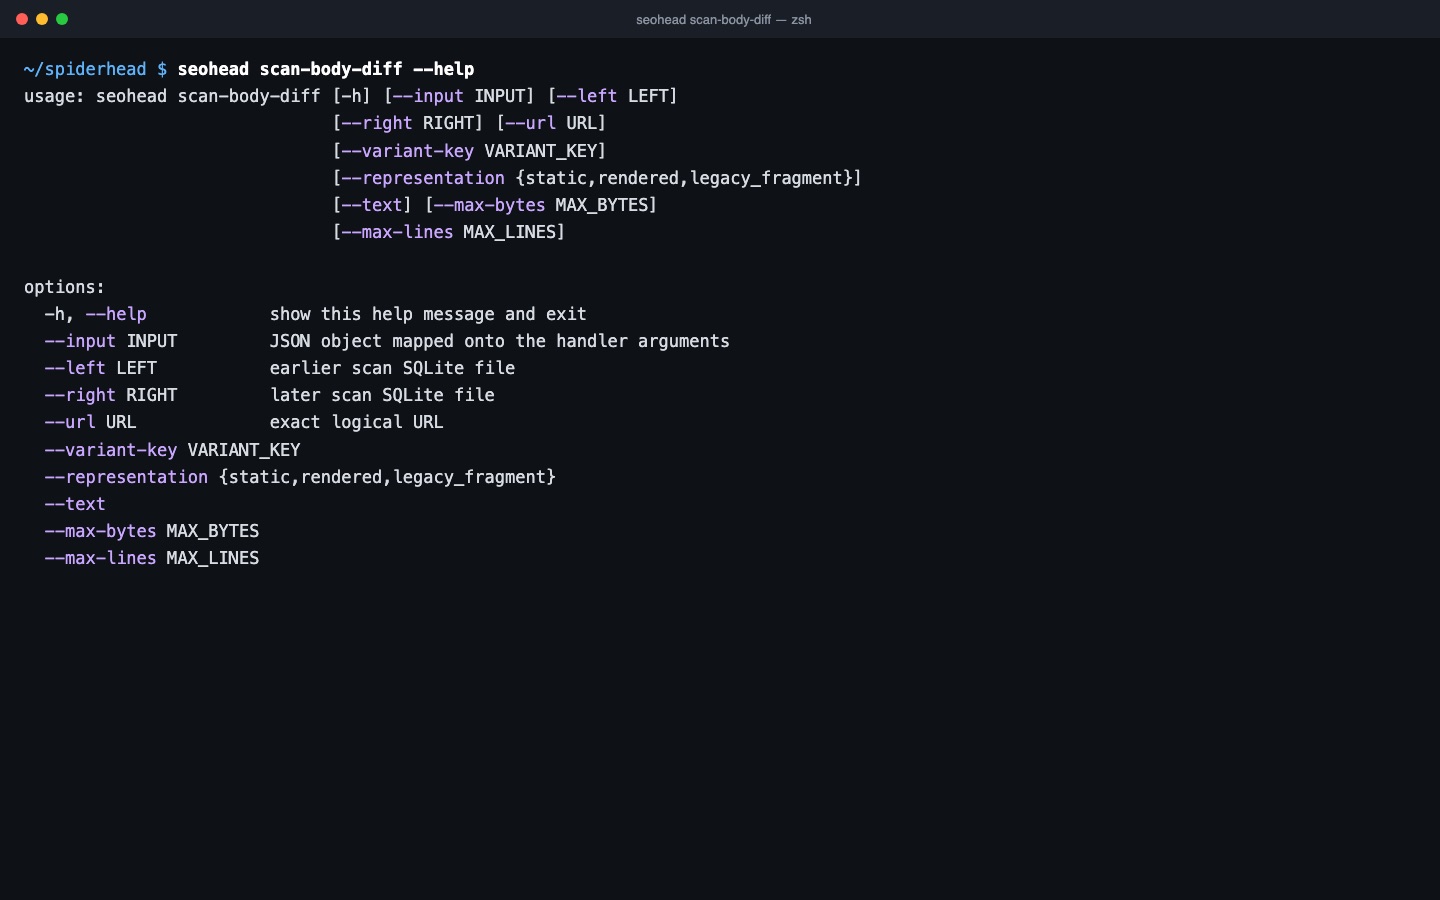
scan-body-diff vergleicht den gespeicherten Body derselben URL in zwei Scan-Dateien. Er kann auch den statischen und den gerenderten Body innerhalb eines Scans vergleichen. Ein geänderter Body ist ein Sachverhalt zur Prüfung, kein Score und kein Urteil.

  • --text ergänzt einen Textvergleich, begrenzt durch --max-bytes und --max-lines.
  • Er sendet keine Anfrage an Ihre Website.
  • Er braucht Scans, die die Bodies der Seiten gespeichert haben.

Vor Beginn Ihrer Scans

wayback-history listet Snapshots einer URL aus dem Internet Archive: wann sie sich geändert hat, welchen Status sie zurückgab und welchen MIME-Typ. Dafür ist kein Schlüssel nötig. compare-url zeigt die Fakten vorher und nachher für eine URL aus zwei gespeicherten Audits.

  • Wayback zeigt Snapshots, die das Archiv angelegt hat, nicht jede Änderung.
  • Nur wayback-history kontaktiert einen externen Dienst.

Drei Schritte, ein gespeicherter Scan

  1. Scans im Projekt aufbewahren

    Jeder Crawl wird als SQLite-Scan-Datei im Ordner scans des Projekts gespeichert. Alte Scans bleiben lesbar, sodass Sie jede URL rückwirkend ansehen können.

  2. Eine URL über Scans hinweg lesen

    scan-url-history zeigt Status, Indexierbarkeit, Title, Canonical und Weiterleitungsziel einer URL in jedem gespeicherten Scan sowie ihren Body-Hash. Scans ohne diese URL werden als nicht vorhanden markiert.

  3. Den Body zwischen zwei Scans vergleichen

    scan-body-diff vergleicht den gespeicherten Body derselben URL in zwei Scan-Dateien. Die Textausgabe ist durch --max-bytes und --max-lines begrenzt. wayback-history ergänzt kostenlose Snapshots des Internet Archive als Kontext.

Ein Befehl

bash
seohead scan-url-history --project ./shop --url https://example.com/

Zuerst installieren: Installationsanleitung. Jeder Befehl läuft auch als MCP-Tool für KI-Agenten.

Was Sie brauchen

  • Ein Projektordner, dessen Verzeichnis scans/ Ihre gespeicherten Scans enthält
  • Die genaue URL, so wie sie gecrawlt wurde
  • Für einen Body-Vergleich: zwei scan.v1-SQLite-Dateien mit gespeicherten Bodies
  • Für Wayback: eine URL und optional einen Zeitraum

Grenzen

  • Nur URLs, die Ihre eigenen Crawls aufgezeichnet haben, haben einen Verlauf.
  • Die Suche verwendet den exakt gespeicherten URL-Text.
  • Linkänderungen werden als Anzahl verglichen, nicht als Liste hinzugefügter und entfernter Links.
  • Die Abdeckung von Wayback hängt davon ab, was das Archiv erfasst hat.

Fragen

Ändert es meine Scans oder meine Website?
Nein. Der URL-Verlauf liest nur Scan-Dateien, und scan-body-diff ist ebenfalls nur lesend. Keines von beiden sendet Anfragen an Ihre Website. wayback-history liest das öffentliche Internet Archive.
Zeigt es Linkänderungen zwischen Scans?
Teilweise. scan-url-history enthält die beobachtete Anzahl der Inlinks und Outlinks je Scan. Welche Links hinzugekommen oder entfernt wurden, zeigt es nicht. Unvollständige Linkdaten bleiben nicht verfügbar und werden nie als null angezeigt.
Bedeutet ein geänderter Body ein SEO-Problem?
Nicht von selbst. Ein geänderter Body ist ein Sachverhalt zur Prüfung, kein Score und kein Urteil. Der Vergleich zeigt, was sich geändert hat; ob das wichtig ist, entscheiden Sie.
Brauche ich einen API-Schlüssel für den Wayback-Verlauf?
Nein. wayback-history nutzt das öffentliche Internet Archive und braucht keinen Schlüssel. Es listet, wann sich die URL geändert hat, welchen Status sie zurückgab und welchen MIME-Typ sie hat.
Wie viele Scans kann ich gleichzeitig lesen?
scan-url-history liest die neuesten Scans, die Sie mit --limit angeben, von 1 bis 500. Der Standardwert ist 50.
Wo wird der Verlauf gespeichert?
In den Scan-Dateien Ihres Projekts auf Ihrem Rechner. SpiderHead legt für diese Funktion keine eigene Verlaufsdatenbank an.

Testen Sie es auf Ihrer eigenen Website