
Storico delle URL tra scansioni

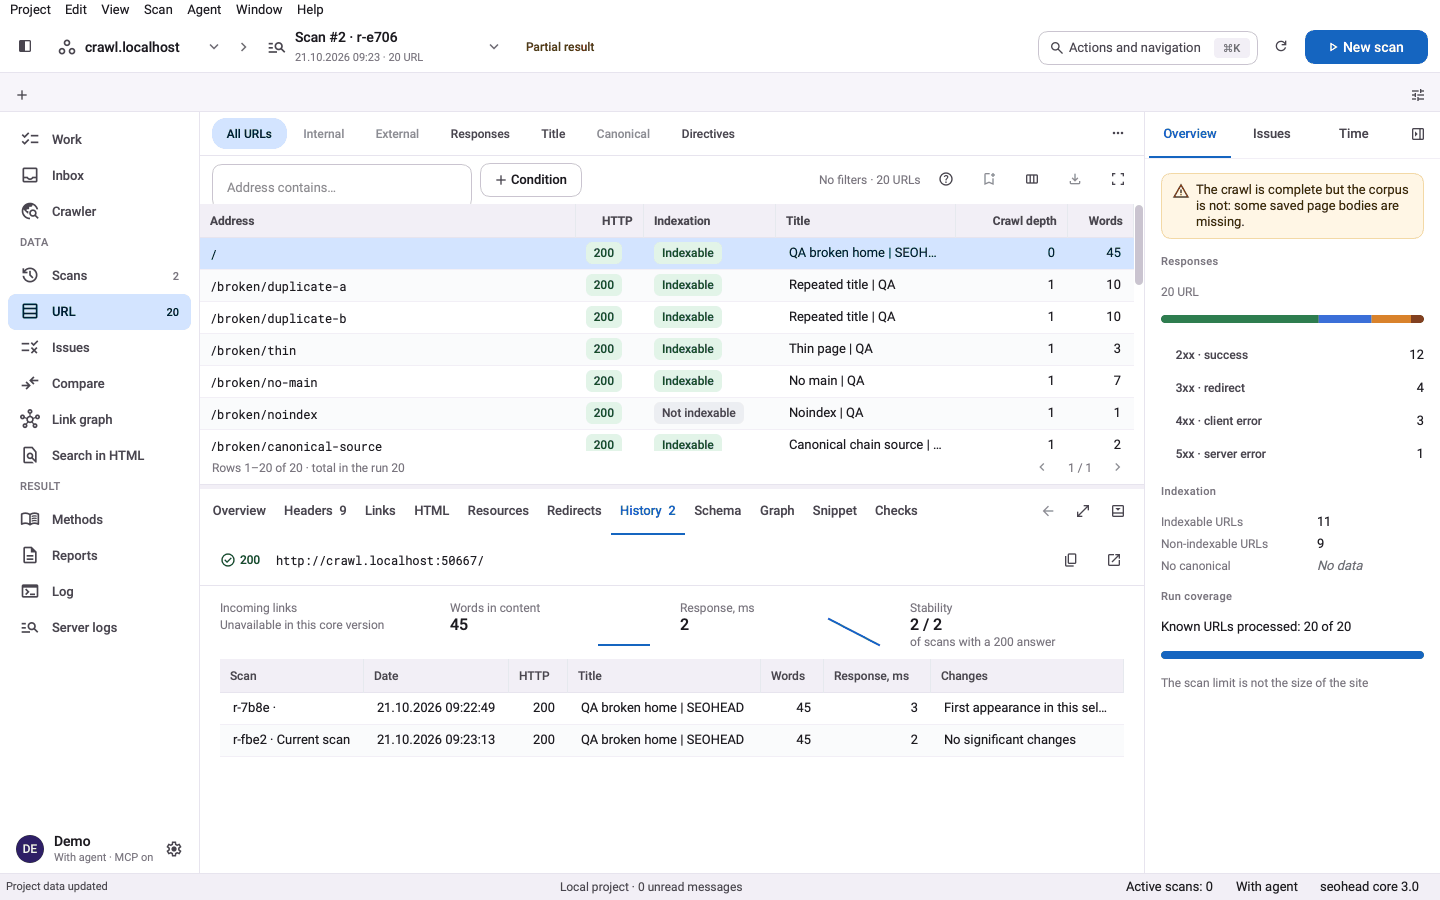
Vedi come è cambiata una URL attraverso le scansioni di un progetto: stato, indicizzabilità, title, meta description, H1, canonical, destinazione dei redirect e corpo. Confronta il corpo tra due scansioni.

Cosa fa

Una URL attraverso le scansioni

scan-url-history legge le scansioni salvate più recenti di un progetto e mostra lo stato di una URL esatta in ciascuna. Le scansioni senza la URL sono marcate assenti. Le scansioni adiacenti sono confrontate campo per campo solo quando entrambe contengono un'osservazione leggibile.

  • Campi: stato, indicizzabilità, title, meta description, H1, canonical, destinazione del redirect, conteggio parole, tempo di risposta, dimensione HTML, hash del corpo.
  • Sono inclusi i conteggi di inlink e outlink. Un diff link per link no.
  • Un intervallo tra le scansioni è marcato non confrontabile.

Diff del corpo

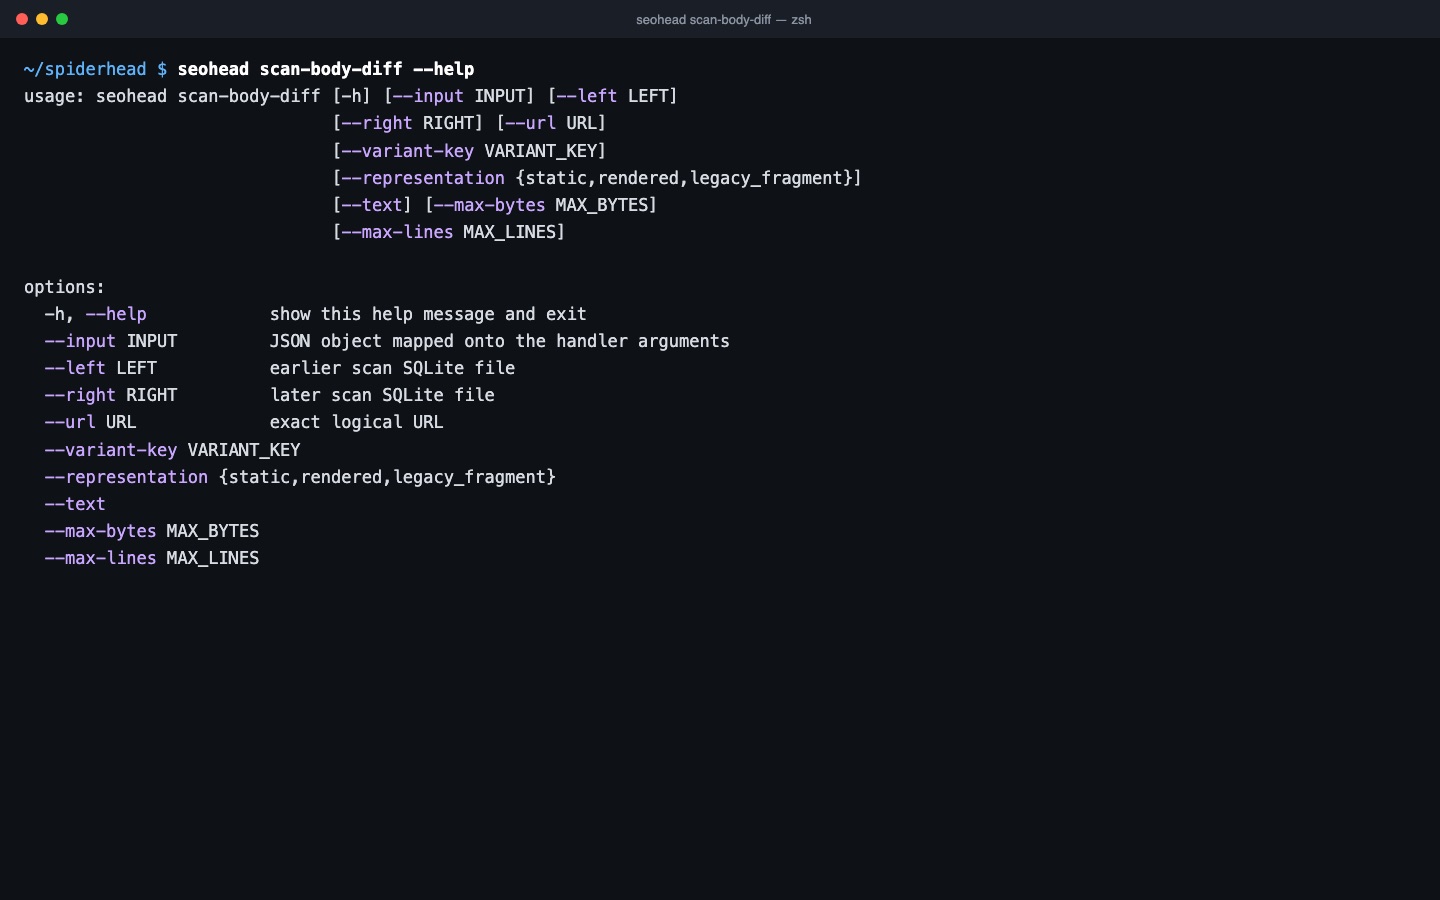
scan-body-diff confronta il corpo conservato della stessa URL in due file di scansione. Può anche confrontare il corpo statico e quello renderizzato dentro una stessa scansione. Un corpo cambiato è un fatto da rivedere, non un punteggio né un verdetto.

  • --text aggiunge un diff testuale, limitato da --max-bytes e --max-lines.
  • Non fa richieste al tuo sito.
  • Richiede scansioni che abbiano conservato i corpi delle pagine.

Prima che le tue scansioni iniziassero

wayback-history elenca gli snapshot dell'Internet Archive per una URL: quando è cambiata, lo stato che restituiva e il suo tipo MIME. Non richiede chiavi. compare-url mostra i fatti prima e dopo per una URL da due audit salvati.

  • Wayback mostra gli snapshot presi dall'archivio, non ogni cambiamento.
  • Solo wayback-history contatta un servizio esterno.

Tre passaggi, una scansione salvata

  1. Conserva le scansioni in un progetto

    Ogni scansione è salvata come file SQLite nella cartella scans del progetto. Le scansioni vecchie restano leggibili, quindi puoi riguardare qualsiasi URL.

  2. Leggi una URL attraverso le scansioni

    scan-url-history mostra stato, indicizzabilità, title, canonical e destinazione del redirect di una URL in ogni scansione conservata, più l'hash del corpo. Le scansioni senza la URL sono marcate assenti.

  3. Confronta il corpo tra due scansioni

    scan-body-diff confronta il corpo conservato della stessa URL in due file di scansione. L'output testuale è limitato da --max-bytes e --max-lines. wayback-history aggiunge snapshot gratuiti dell'Internet Archive per contesto.

Un solo comando

bash
seohead scan-url-history --project ./shop --url https://example.com/

Prima installa SpiderHead: guida all'installazione. Ogni comando funziona anche come strumento MCP per agenti AI.

Cosa ti serve

  • Una cartella di progetto la cui directory scans/ contiene le tue scansioni salvate
  • La URL esatta, scritta com'è stata scansionata
  • Per il diff del corpo: due file SQLite scan.v1 con i corpi conservati
  • Per Wayback: una URL e, facoltativamente, un intervallo di date

Limiti

  • Solo le URL registrate dalle tue scansioni hanno uno storico.
  • La ricerca usa il testo esatto della URL conservata.
  • I cambiamenti dei link sono confrontati come conteggi, non come lista di link aggiunti e rimossi.
  • La copertura Wayback dipende da ciò che l'archivio ha catturato.

Domande

Modifica le mie scansioni o il mio sito?
No. Lo storico delle URL legge solo file di scansione, e anche scan-body-diff è in sola lettura. Nessuno dei due invia richieste al tuo sito. wayback-history legge l'Internet Archive pubblico.
Mostra i cambiamenti dei link tra le scansioni?
In parte. scan-url-history include i conteggi di inlink e outlink osservati per ogni scansione. Non elenca quali link sono stati aggiunti o rimossi. I dati sui link incompleti restano non disponibili, mai a zero.
Un corpo cambiato significa un problema SEO?
Non da solo. Un corpo cambiato è un fatto da rivedere, non un punteggio o un verdetto. Il diff mostra cosa è cambiato; decidi tu se conta.
Serve una chiave API per lo storico Wayback?
No. wayback-history usa l'Internet Archive pubblico e non richiede chiavi. Elenca quando la URL è cambiata, lo stato che restituiva e il suo tipo MIME.
Quante scansioni posso leggere in una volta?
scan-url-history legge le scansioni più recenti che chiedi con --limit, da 1 a 500. Il predefinito è 50.
Dove è conservato lo storico?
Nei file di scansione del tuo progetto, sul tuo computer. SpiderHead non costruisce un database storico separato per questa funzione.