
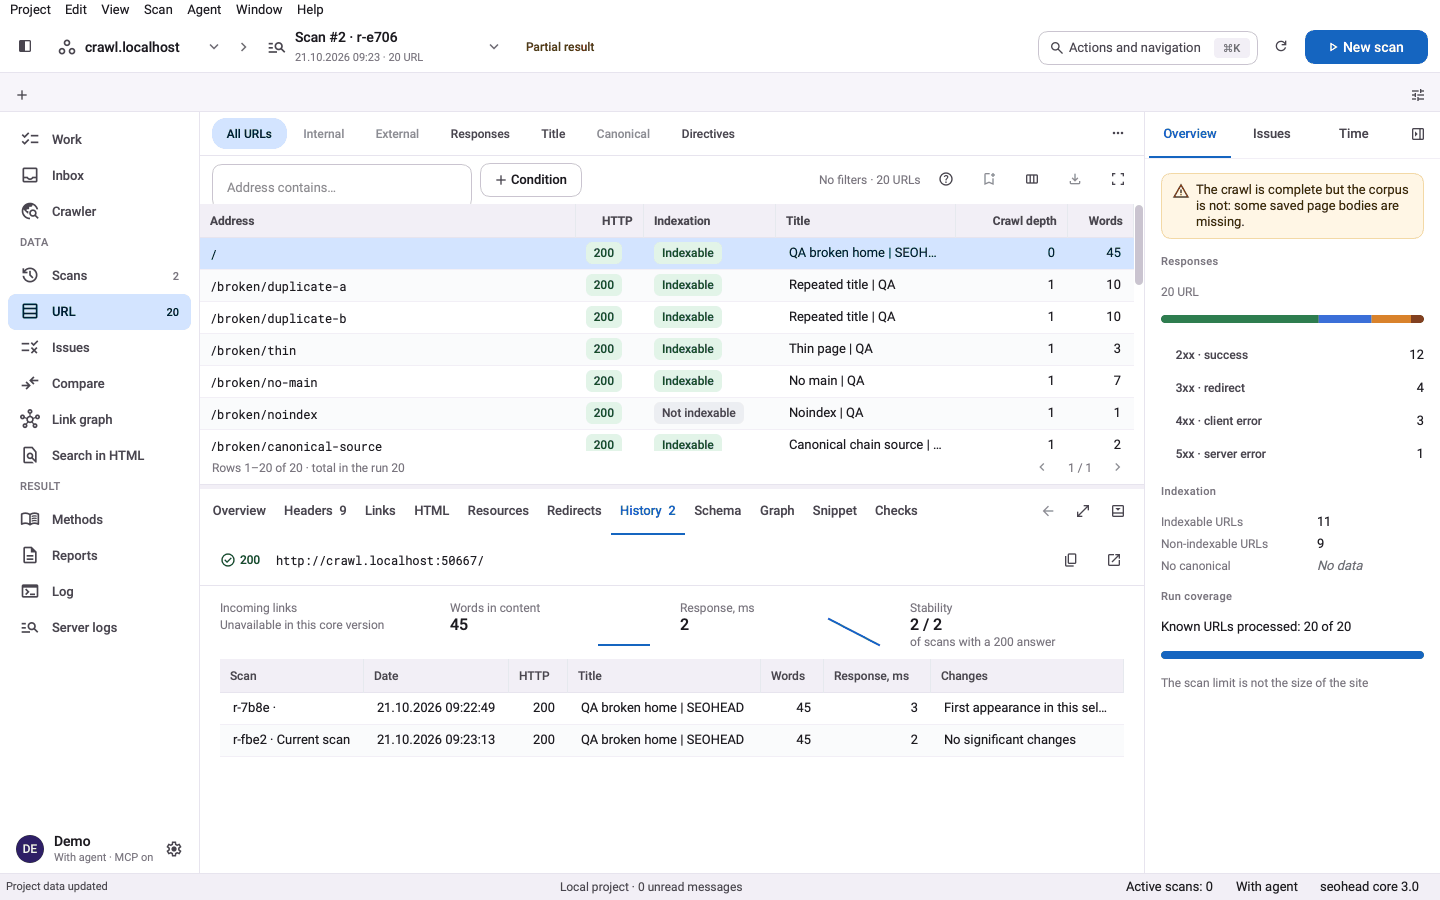
История URL между сканированиями

Смотрите, как менялся один URL между сканированиями проекта: статус, индексируемость, title, meta description, H1, canonical, цель редиректа и тело страницы. Сравнивайте тело между двумя сканированиями.

Что делает

Один URL между сканированиями

scan-url-history читает самые новые сохранённые сканирования проекта и показывает состояние одного точного URL в каждом. В сканированиях без этого URL он отмечается как отсутствующий. Соседние сканирования сравниваются поле за полем, только если в обоих есть читаемое наблюдение.

  • Поля: статус, индексируемость, title, meta description, H1, canonical, цель редиректа, количество слов, время ответа, размер HTML, хэш тела.
  • Количество входящих и исходящих ссылок учитывается, построчного сравнения ссылок нет.
  • Разрыв между сканированиями помечается как несопоставимый.

Сравнение тела

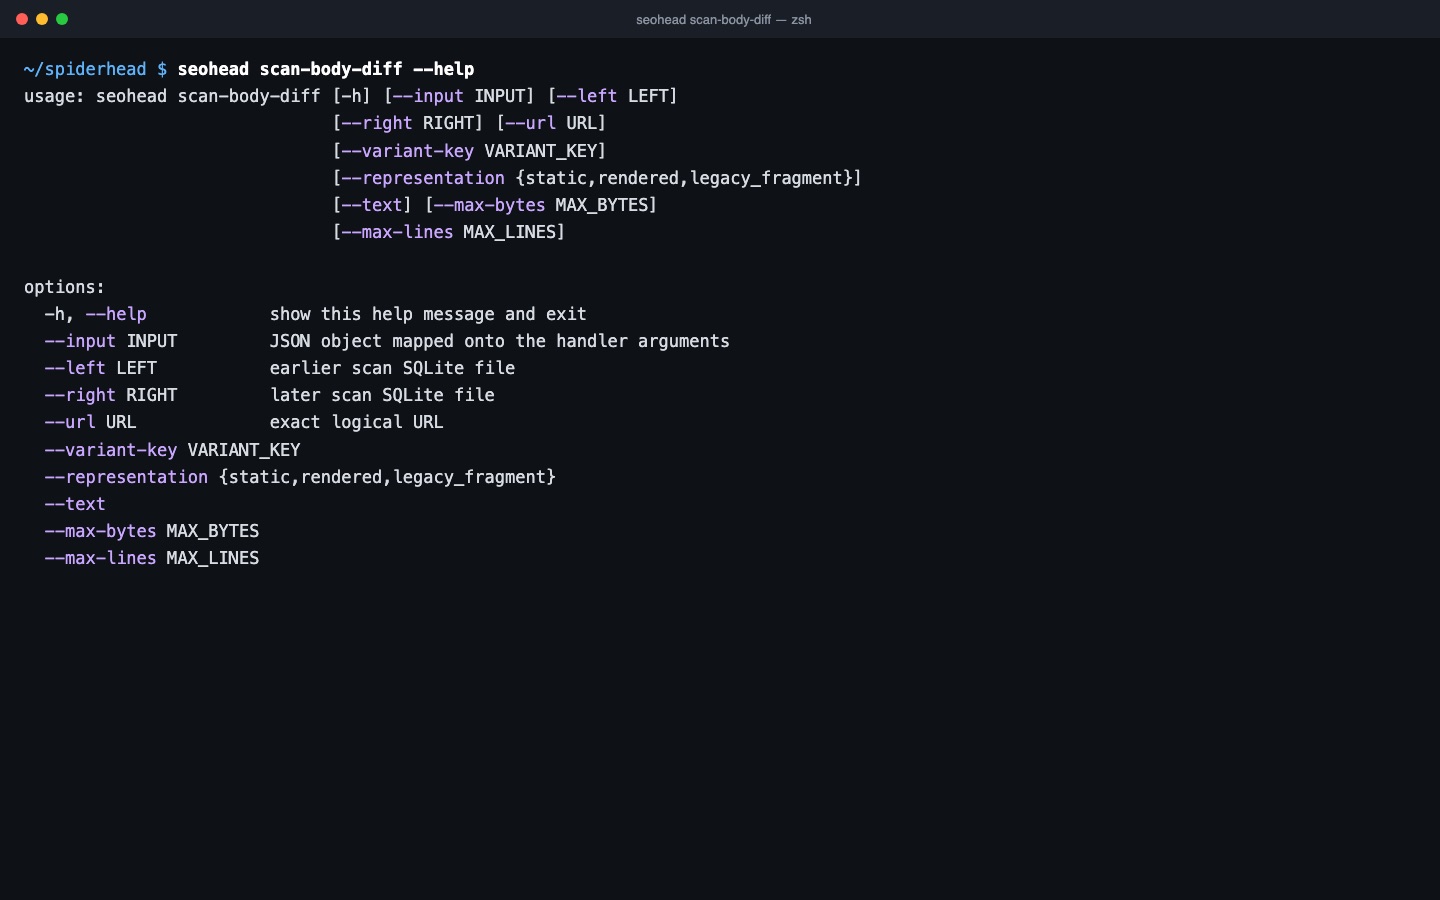
scan-body-diff сравнивает сохранённое тело одного URL в двух файлах сканирования. Он также может сравнить статичное и отрисованное тело внутри одного сканирования. Изменённое тело — факт для проверки, а не оценка и не вердикт.

  • --text добавляет текстовое сравнение, ограниченное --max-bytes и --max-lines.
  • Запросов к вашему сайту не делает.
  • Нужны сканирования, которые сохранили тела страниц.

До начала ваших сканирований

wayback-history показывает снимки Internet Archive для URL: когда он менялся, какой статус вернул и какой у него MIME-тип. Ключ не нужен. compare-url показывает факты «до» и «после» для одного URL из двух сохранённых аудитов.

  • Wayback показывает снимки, которые сделал архив, а не каждое изменение.
  • Только wayback-history обращается к внешнему сервису.

Три шага — один сохранённый скан

  1. Храните сканирования в проекте

    Каждое сканирование сохраняется как SQLite-файл в папке scans проекта. Старые сканирования остаются читаемыми, поэтому вернуться можно к любому URL.

  2. Читайте один URL между сканированиями

    scan-url-history показывает статус, индексируемость, title, canonical и цель редиректа одного URL в каждом сохранённом сканировании, а также хэш тела. В сканированиях без URL он отмечается как отсутствующий.

  3. Сравните тело между двумя сканированиями

    scan-body-diff сравнивает сохранённое тело одного URL в двух файлах сканирования. Текстовый вывод ограничен --max-bytes и --max-lines. wayback-history добавляет бесплатные снимки Internet Archive как контекст.

Одна команда

bash
seohead scan-url-history --project ./shop --url https://example.com/

Сначала установите: руководство по установке. Каждая команда работает и как MCP-инструмент для ИИ-агентов.

Что нужно

  • Папка проекта, в каталоге scans/ которой лежат сохранённые сканирования
  • Точный URL, записанный так, как его сканировали
  • Для сравнения тела — два файла scan.v1 SQLite с сохранёнными телами страниц
  • Для Wayback — URL и, по желанию, диапазон дат

Ограничения

  • История есть только у URL, которые записали ваши собственные сканирования.
  • Поиск идёт по точному сохранённому тексту URL.
  • Изменения ссылок сравниваются как количество, а не как список добавленных и удалённых ссылок.
  • Покрытие Wayback зависит от того, что архив успел сохранить.

Вопросы

Меняет ли это мои сканирования или сайт?
Нет. История URL только читает файлы сканирований, и scan-body-diff тоже только читает. Ни один из них не отправляет запросы на ваш сайт. wayback-history читает публичный Internet Archive.
Показывает ли инструмент изменения ссылок между сканированиями?
Частично. scan-url-history включает наблюдаемое количество входящих и исходящих ссылок для каждого сканирования. Список добавленных и удалённых ссылок он не показывает. Неполные данные о ссылках остаются недоступными, а не становятся нулём.
Значит ли изменённое тело проблему с SEO?
Само по себе нет. Изменённое тело — факт для проверки, а не оценка и не вердикт. Сравнение показывает, что изменилось, а решаете вы, важно ли это.
Нужен ли API-ключ для истории Wayback?
Нет. wayback-history использует публичный Internet Archive и не требует ключа. Он показывает, когда URL менялся, какой статус вернул и какой у него MIME-тип.
Сколько сканирований можно прочитать за раз?
scan-url-history читает самые новые сканирования, которые вы запросите параметром --limit, от 1 до 500. По умолчанию — 50.
Где хранится история?
В файлах сканирований вашего проекта, на вашей машине. Для этой функции SpiderHead не создаёт отдельной базы истории.

Проверьте на своём сайте