
Historique d'une URL entre les analyses

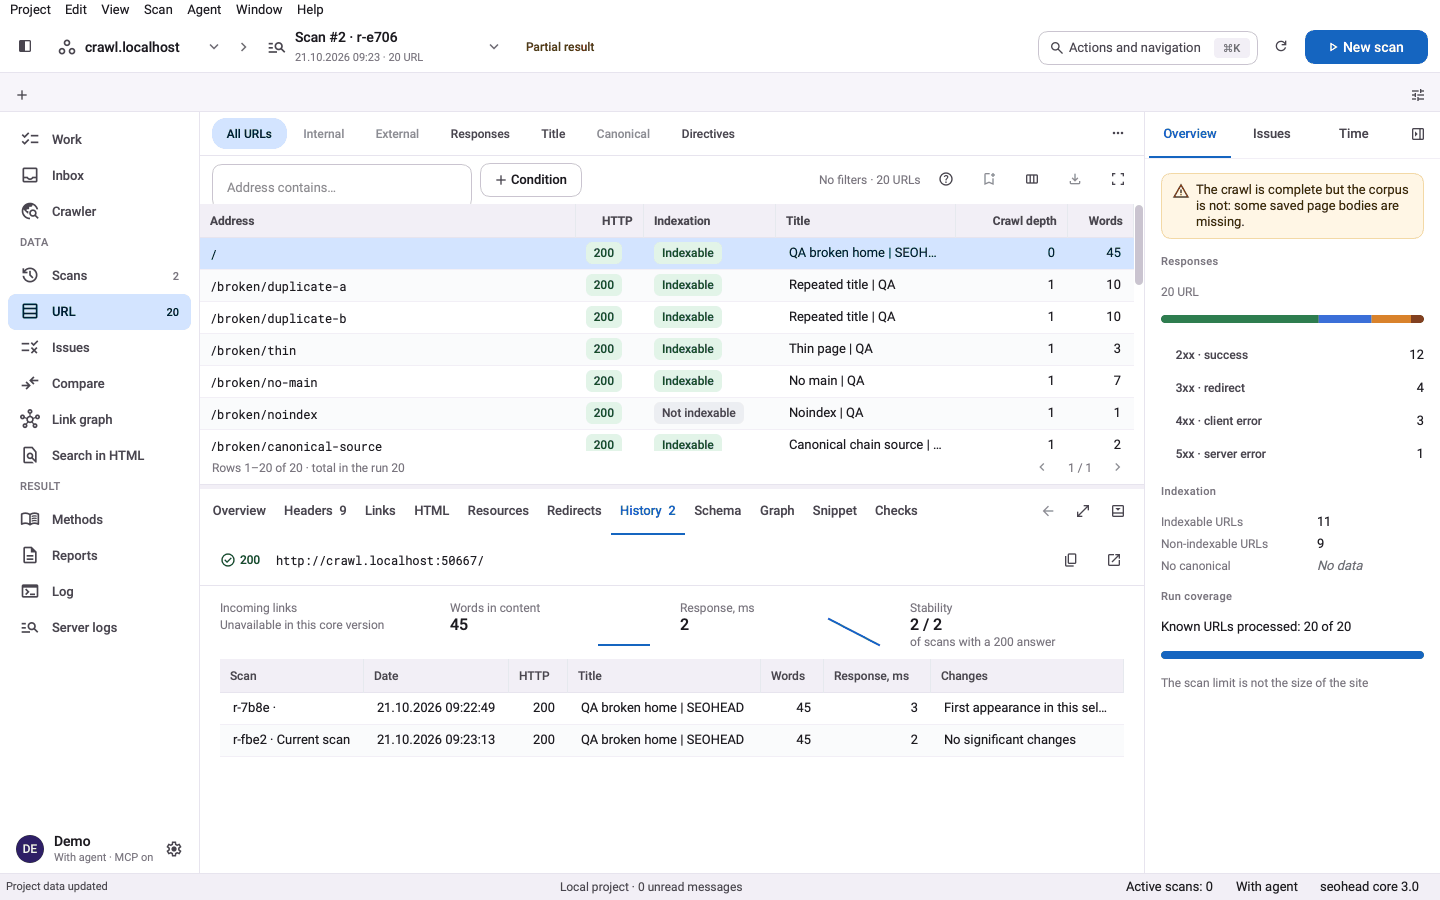
Voyez comment une URL a évolué d'une analyse à l'autre dans un projet : statut, indexabilité, title, meta description, H1, canonical, cible de redirection et contenu. Comparez le contenu entre deux analyses.

Ce qu'elle fait

Une URL à travers les analyses

scan-url-history lit les analyses enregistrées les plus récentes d'un projet et affiche l'état d'une URL exacte dans chacune. Les analyses où l'URL est absente sont marquées comme telles. Deux analyses voisines ne sont comparées champ par champ que si toutes deux contiennent une observation lisible.

  • Champs : statut, indexabilité, title, meta description, H1, canonical, cible de redirection, nombre de mots, temps de réponse, taille du HTML, empreinte (hash) du contenu.
  • Les nombres de liens entrants et sortants sont inclus. Une comparaison lien par lien ne l'est pas.
  • Un écart entre deux analyses est marqué comme non comparable.

Comparaison du contenu

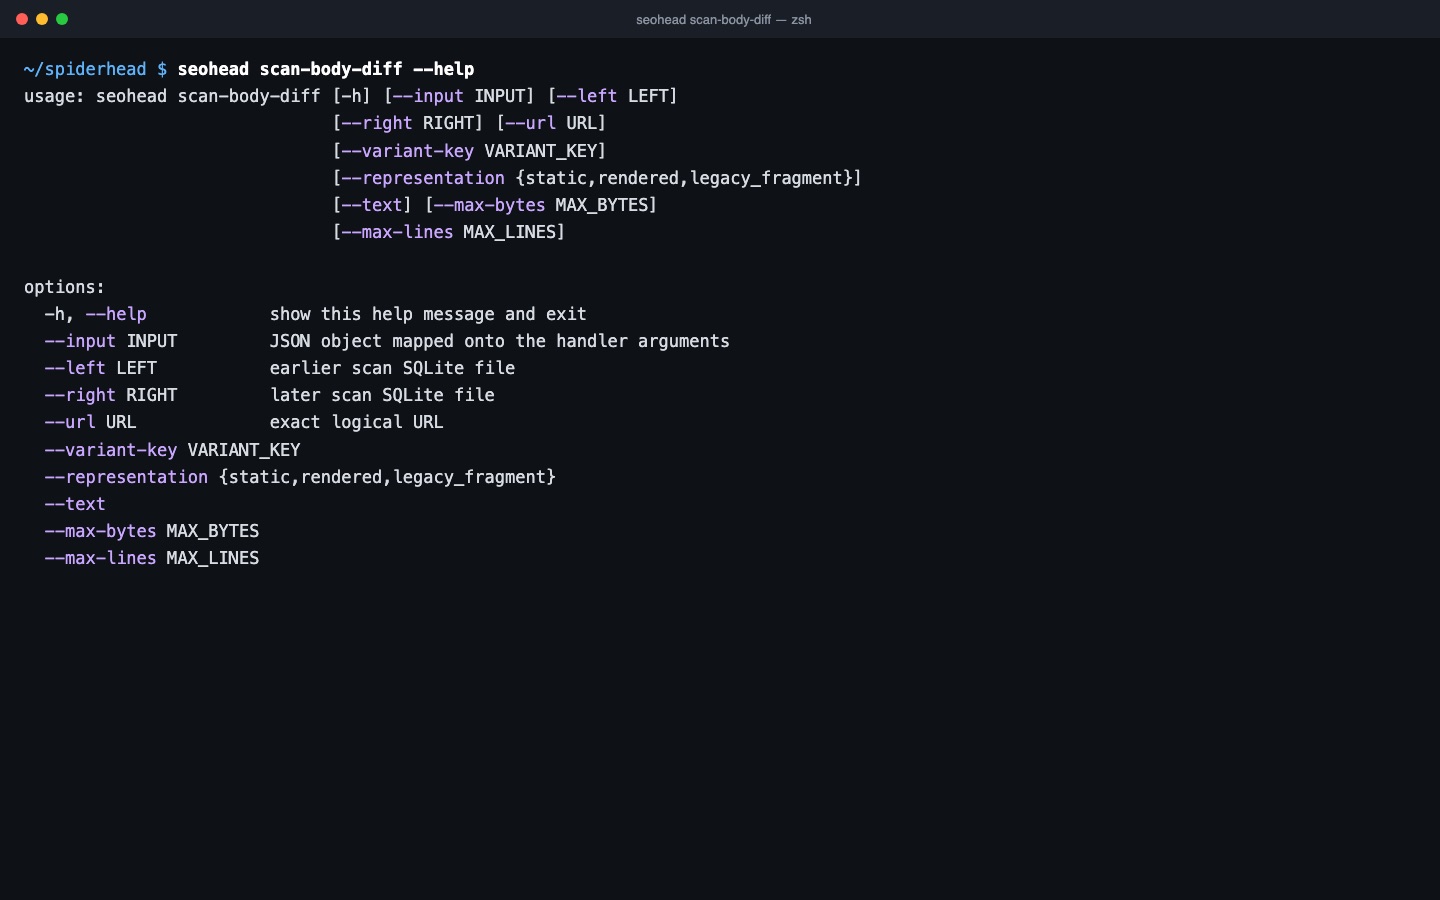
scan-body-diff compare le contenu conservé de la même URL dans deux fichiers d'analyse. Il peut aussi comparer, au sein d'une même analyse, le contenu statique et le contenu après rendu. Un contenu modifié est un fait à examiner, et non un score ni un verdict.

  • --text ajoute une comparaison de texte, limitée par --max-bytes et --max-lines.
  • Il n'envoie aucune requête à votre site.
  • Il nécessite des analyses ayant conservé le contenu des pages.

Avant le début de vos analyses

wayback-history liste les instantanés de l'Internet Archive pour une URL : la date des modifications, le statut renvoyé et son type MIME. Aucune clé n'est nécessaire. compare-url affiche les faits avant et après pour une URL, à partir de deux audits enregistrés.

  • Wayback montre les instantanés pris par l'archive, pas chaque modification.
  • Seul wayback-history interroge un service extérieur.

Trois étapes, un seul scan enregistré

  1. Conserver les analyses dans un projet

    Chaque crawl est enregistré sous forme de fichier d'analyse SQLite dans le dossier scans du projet. Les anciennes analyses restent lisibles : vous pouvez revenir sur n'importe quelle URL.

  2. Lire une URL à travers les analyses

    scan-url-history affiche le statut, l'indexabilité, le title, la canonical et la cible de redirection d'une URL dans chaque analyse conservée, ainsi que son empreinte de contenu. Les analyses où l'URL est absente sont marquées comme telles.

  3. Comparer le contenu entre deux analyses

    scan-body-diff compare le contenu conservé de la même URL dans deux fichiers d'analyse. La sortie texte est limitée par --max-bytes et --max-lines. wayback-history ajoute, pour le contexte, les instantanés gratuits de l'Internet Archive.

Une seule commande

bash
seohead scan-url-history --project ./shop --url https://example.com/

Commencez par installer : guide d'installation. Chaque commande fonctionne aussi comme outil MCP pour les agents IA.

Ce qu'il vous faut

  • Un dossier de projet dont le répertoire scans/ contient vos analyses enregistrées
  • L'URL exacte, telle qu'elle a été crawlée
  • Pour une comparaison de contenu : deux fichiers SQLite scan.v1 contenant les corps de page conservés
  • Pour Wayback : une URL et, éventuellement, une plage de dates

Limites

  • Seules les URL enregistrées par vos propres crawls ont un historique.
  • La recherche utilise le texte exact de l'URL conservée.
  • Les modifications de liens sont comparées sous forme de nombres, et non de listes de liens ajoutés et supprimés.
  • La couverture de Wayback dépend de ce que l'archive a effectivement capturé.

Questions

Cela modifie-t-il mes analyses ou mon site ?
Non. L'historique d'URL ne fait que lire des fichiers d'analyse, et scan-body-diff est lui aussi en lecture seule. Aucun des deux n'envoie de requête à votre site. wayback-history interroge l'Internet Archive public.
Montre-t-il les modifications de liens entre les analyses ?
En partie. scan-url-history inclut, pour chaque analyse, le nombre de liens entrants et sortants observés. Il n'indique pas quels liens ont été ajoutés ou supprimés. Les données de liens incomplètes restent indisponibles, jamais égales à zéro.
Un contenu modifié signifie-t-il un problème SEO ?
Pas en soi. Un contenu modifié est un fait à examiner, et non un score ni un verdict. La comparaison montre ce qui a changé ; c'est à vous de juger si cela compte.
Faut-il une clé API pour l'historique Wayback ?
Non. wayback-history utilise l'Internet Archive public et ne nécessite aucune clé. Il indique quand l'URL a été modifiée, le statut renvoyé et son type MIME.
Combien d'analyses puis-je lire à la fois ?
scan-url-history lit les analyses les plus récentes que vous demandez avec --limit, de 1 à 500. La valeur par défaut est 50.
Où l'historique est-il stocké ?
Dans les fichiers d'analyse de votre projet, sur votre machine. SpiderHead ne crée pas de base de données d'historique distincte pour cette fonctionnalité.