
Проверка canonical-тегов

Проверки canonical работают на уровне страницы и как граф по всему сканированию: цепочки, canonical, которые ведут на редиректы или ошибки, относительные, фрагментные и множественные значения, а также цели, на которые не ведёт ни одна внутренняя ссылка.

Что делает

Теги на уровне страницы

Canonical каждой страницы читается и проверяется отдельно. Отсутствующее, относительное, множественное или фрагментное значение попадает в отчёт, как и canonical-ссылка вне head или с атрибутами, которым там не место. Canonical, который ведёт на другой URL, на другой хост или на неиндексируемую страницу, получает собственную находку, чтобы вы сами решили, какие из них намеренные.

  • Отсутствующий, множественный, относительный и фрагментный canonical
  • Canonical вне head или с неверными атрибутами
  • Цели на другом хосте и неиндексируемые цели

Граф canonical

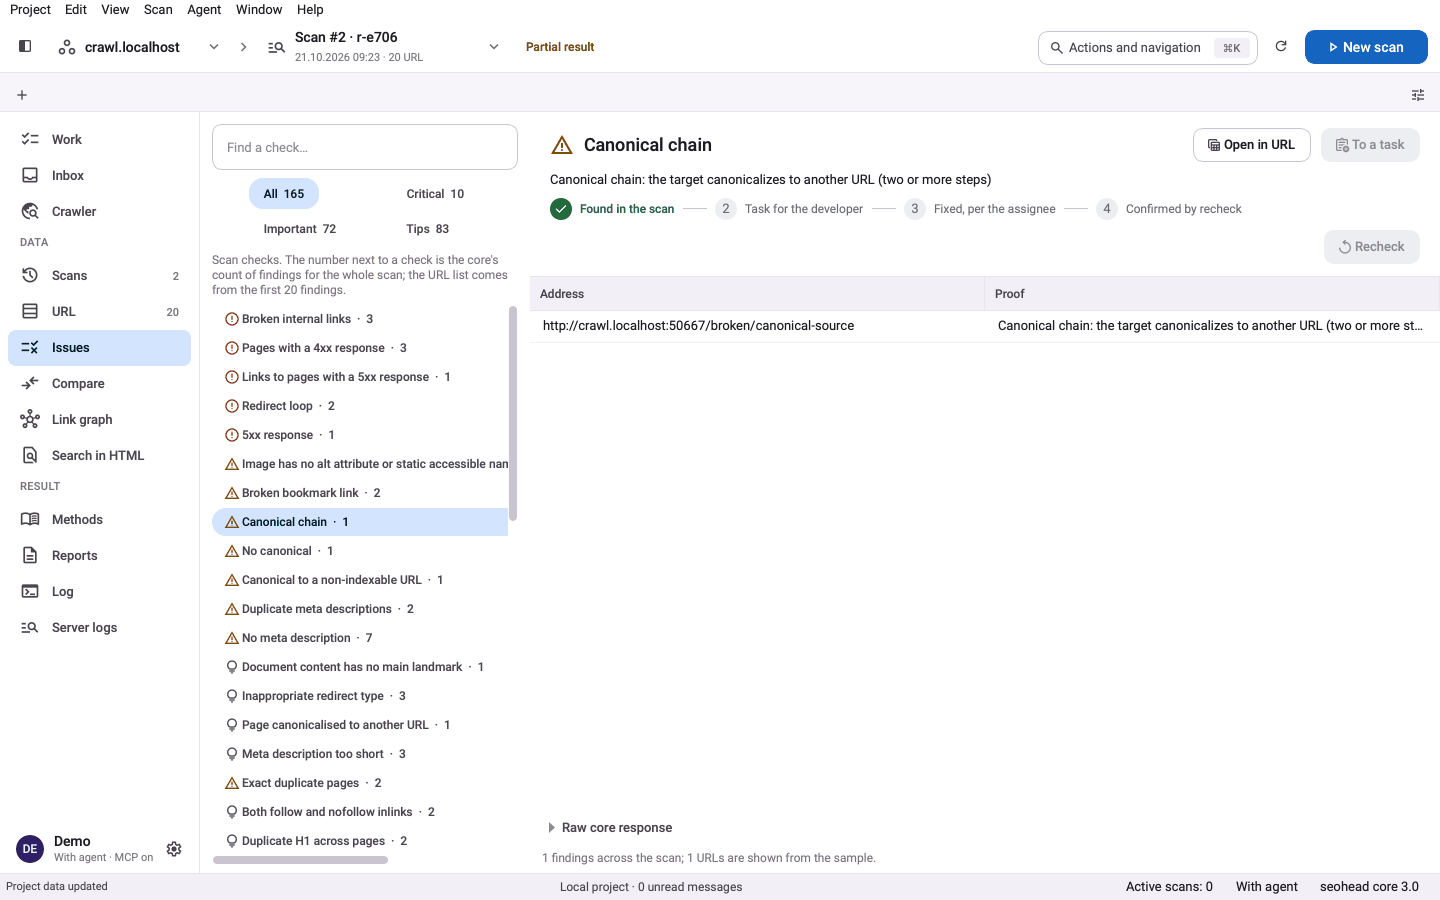
Цели canonical по всему сканированию образуют граф. Он показывает цепочки, где цель сама ссылается canonical на другой URL, canonical, которые ведут на редирект или ошибку, и группы страниц из разных разделов, все ссылающиеся на главную. Цель, на которую не ведёт ни одна внутренняя ссылка, тоже попадает в отчёт.

  • Цепочки из двух и более шагов
  • Canonical на URL с ответом 3xx, 4xx или 5xx
  • Страницы из нескольких разделов, canonical которых указывает на главную
  • Цели без внутренних ссылок

Политики

Пагинации и фильтрам нужны отдельные правила: canonical на первую страницу подходит одному сайту и не подходит другому. Политика проекта задаёт ожидаемое поведение, а в каждой находке ожидаемая цель стоит рядом с фактической.

  • Политика canonical для пагинации
  • Политика canonical для фильтров
  • Ожидаемая цель показана в доказательствах

Три шага — один сохранённый скан

  1. Прочитайте каждый canonical-тег

    Canonical каждой страницы проверяется на отсутствие, множественность, относительный путь и значение с #фрагментом.

  2. Постройте граф canonical

    Цели canonical по всему сканированию образуют граф, поэтому цепочки и циклы видны как пути между страницами.

  3. Проверьте каждую цель

    Каждую цель проверяют на редиректы, ошибки 4xx и 5xx и на наличие внутренних ссылок, которые на неё ведут.

Проверки в этой возможности

ПроверкаЧто значитКритичностьДоказательство
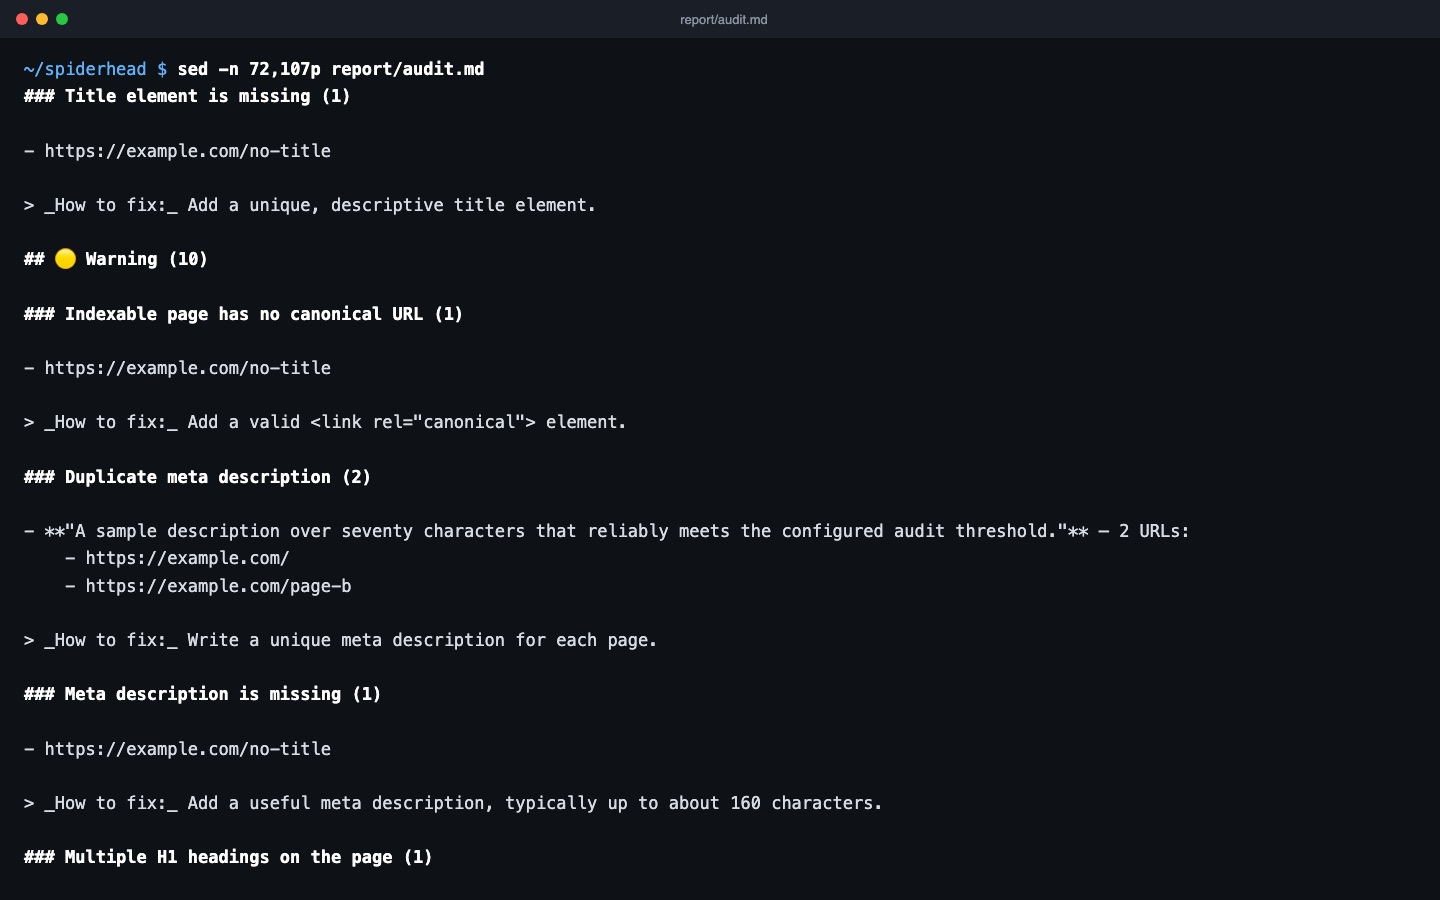
CANONICAL_MISSINGУ индексируемой страницы нет canonical-URLImportantURL страницы
CANONICAL_MULTIPLEНа странице объявлено больше одного canonical-URLImportantURL страницы и каждое значение canonical
CANONICAL_CHAINЦель canonical сама ссылается canonical на другой URL: два шага и болееImportantПолная цепочка canonical-URL
CANONICAL_TO_REDIRECTCanonical ведёт на URL, который отвечает редиректом 3xxImportantЦель canonical и статус её редиректа
CANONICAL_TARGET_ERRORCanonical ведёт на URL, который возвращает 4xx или 5xxImportantЦель canonical и её код статуса
CANONICAL_HOMEPAGE_GROUPРазные индексируемые страницы из нескольких разделов все ссылаются canonical на главнуюImportantСписок страниц, которые ведут на главную
UNLINKED_CANONICALНа цель canonical не ведёт ни одна внутренняя ссылка во всём сканированииImportantURL цели canonical
Ещё в реестре проверок
CANONICAL_RELATIVECANONICAL_FRAGMENTPAGINATION_CANONICAL_POLICYFILTER_CANONICAL_POLICY

Одна команда

bash
seohead parse --url https://example.com/page

Сначала установите: руководство по установке. Каждая команда работает и как MCP-инструмент для ИИ-агентов.

Что нужно

  • Один URL для parse, чтобы прочитать его canonical
  • Сканирование или экспорты Screaming Frog Internal:All для проверок графа
  • Необязательная политика проекта для страниц пагинации и фильтров

Ограничения

  • По одному URL нельзя найти цепочки, цели с ошибками и группу главной страницы: для них нужен граф сканирования
  • Canonical — подсказка для поисковых систем, поэтому проверки показывают, что заявлено, а не какой URL выбрал Google
  • Проверки политик работают только с политикой, настроенной в проекте
  • Страницы, которых нет в сканировании, нельзя проверить как цели

Вопросы

Хватит ли одного URL, чтобы найти проблемы?
Один URL через seohead parse покажет его значение canonical. Проверки цепочек, целей редиректа, целей с ошибками и группы главной страницы требуют граф, построенный по всему сканированию.
Это что-то меняет на моём сайте?
Нет. Проверки только читают страницы. Теги canonical вы правите сами.
Нужен ли Screaming Frog?
Нет. Проверки графа работают на данных сканирования, которые могут прийти из экспортов Screaming Frog Internal:All (sf run --exports-dir) или из собственного crawl-site SpiderHead. Лицензированный Screaming Frog CLI нужен только для сканирования Screaming Frog через --crawl.
А страницы пагинации и фильтров?
Две проверки, PAGINATION_CANONICAL_POLICY и FILTER_CANONICAL_POLICY, сравнивают каждый canonical с политикой проекта и показывают ожидаемую цель.
Может ли он сказать, какой canonical выбрал Google?
Только при подключённой Search Console: GSC_USER_CANONICAL_NOT_SELECTED сравнивает заявленный canonical с тем, который Google выбрал через проверку URL. Без этого проверки показывают только то, что страница заявляет.

Проверьте на своём сайте