
Rastreo respetuoso: presupuesto y límites de velocidad

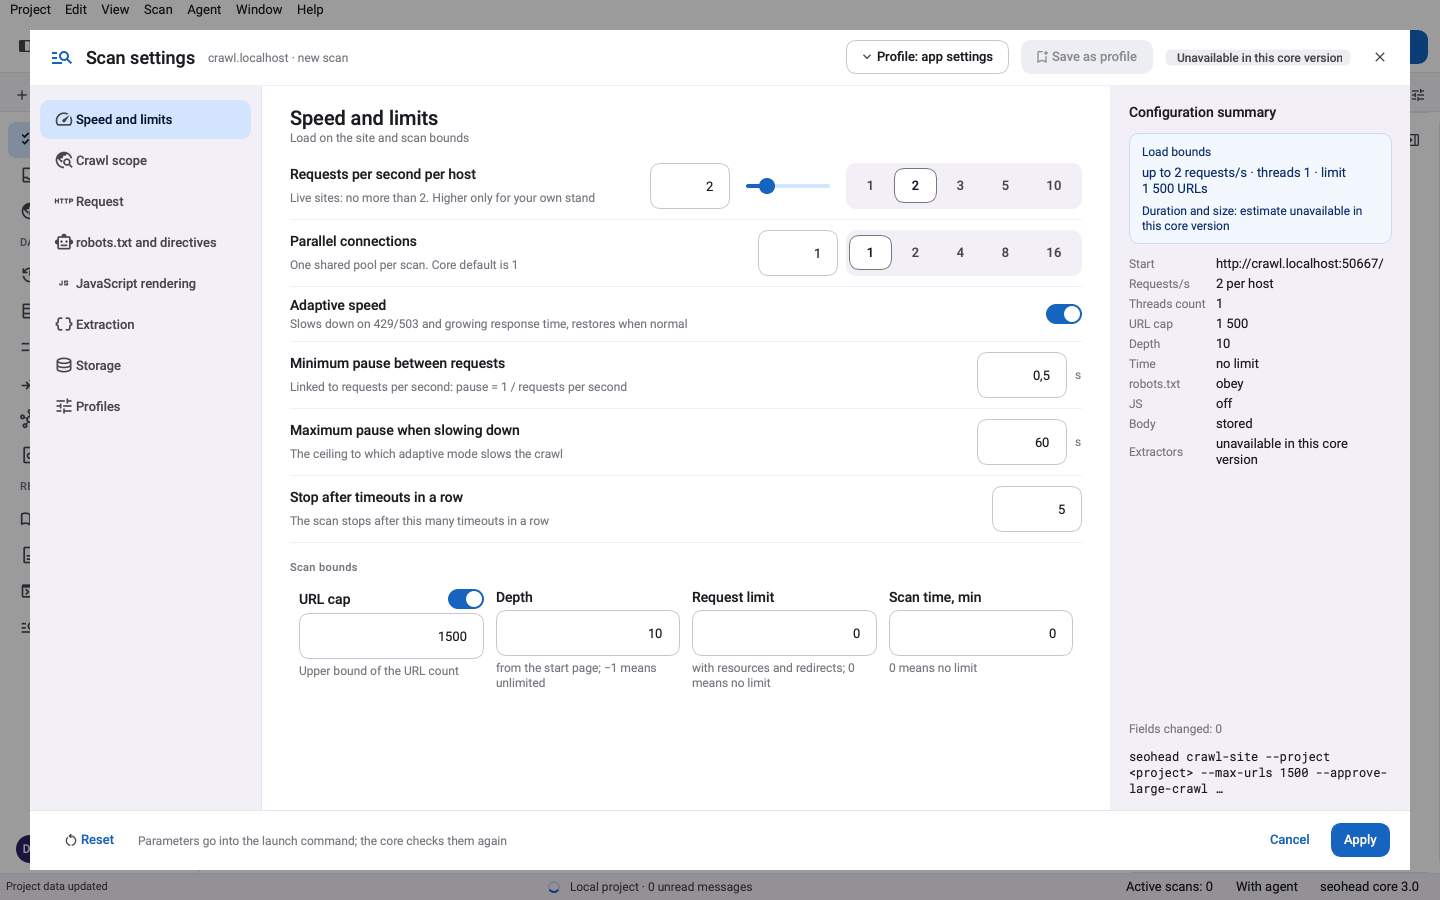
SpiderHead es respetuoso por defecto: unas dos solicitudes por segundo y por host, solicitudes acotadas de solo lectura y un límite de URL explícito que funciona como presupuesto, no como una suposición sobre el tamaño del sitio.

Qué hace

Presupuestos que tú defines

Un rastreo se detiene en los límites que le das: número de URL (200 por defecto), profundidad de enlaces (5 por defecto), número total de intentos HTTP y, si quieres, un presupuesto de tiempo total. Puedes acotarlo con reglas de inclusión y exclusión por patrón de URL, extensión de archivo o tipo de medio. Superar el presupuesto de un proyecto requiere --approve-large-crawl.

  • --max-urls es un presupuesto explícito, no una suposición sobre el tamaño del sitio
  • La pausa se adapta al origen: aumenta cuando el servidor se ralentiza o agota el tiempo de espera

Seguro por diseño

Las herramientas de red bloquean los destinos privados y locales, salvo que los permitas por nombre. El rastreador envía solo solicitudes acotadas y de solo lectura al sitio que indicas, y se identifica con un User-Agent. Además, se detiene solo tras 5 tiempos de espera agotados seguidos.

Tres pasos, un análisis guardado

  1. Define un presupuesto de URL

    --max-urls limita las páginas que descarga un rastreo (200 por defecto), y superar el presupuesto de un proyecto requiere --approve-large-crawl.

  2. Regula cada host

    La pausa por defecto es de 0,5 segundos entre solicitudes, unas dos por segundo y por host; --max-urls-per-second fija la velocidad, y la reducción adaptativa de velocidad ralentiza el rastreo cuando el servidor tiene dificultades.

  3. Respeta robots.txt y los destinos privados

    Por defecto se respeta robots.txt, y las direcciones privadas o locales siguen bloqueadas hasta que las permitas por nombre.

Comprobaciones de esta función

ComprobaciónQué significaGravedadEvidencia
SLOW_RESPONSEEl servidor tardó más de 1,5 segundos en responderImportantTiempo de respuesta por página frente al umbral de 1,5 s
BLOCKED_BY_ROBOTSrobots.txt bloquea la URLImportantURL bloqueada en el rastreo o en la exportación de SF
IMPORTANT_URL_BLOCKED_BY_ROBOTSrobots.txt bloquea una página que recibe enlaces internos, así que se corta el descubrimiento de enlacesImportantURL bloqueada y sus enlaces internos entrantes
ROBOTS_BLOCKS_RESOURCESrobots.txt bloquea JavaScript o CSS necesarios para renderizar la páginaTipURL del recurso bloqueado
SITEMAP_NOT_IN_ROBOTSrobots.txt no tiene la directiva SitemapTipContenido de robots.txt

Un solo comando

bash
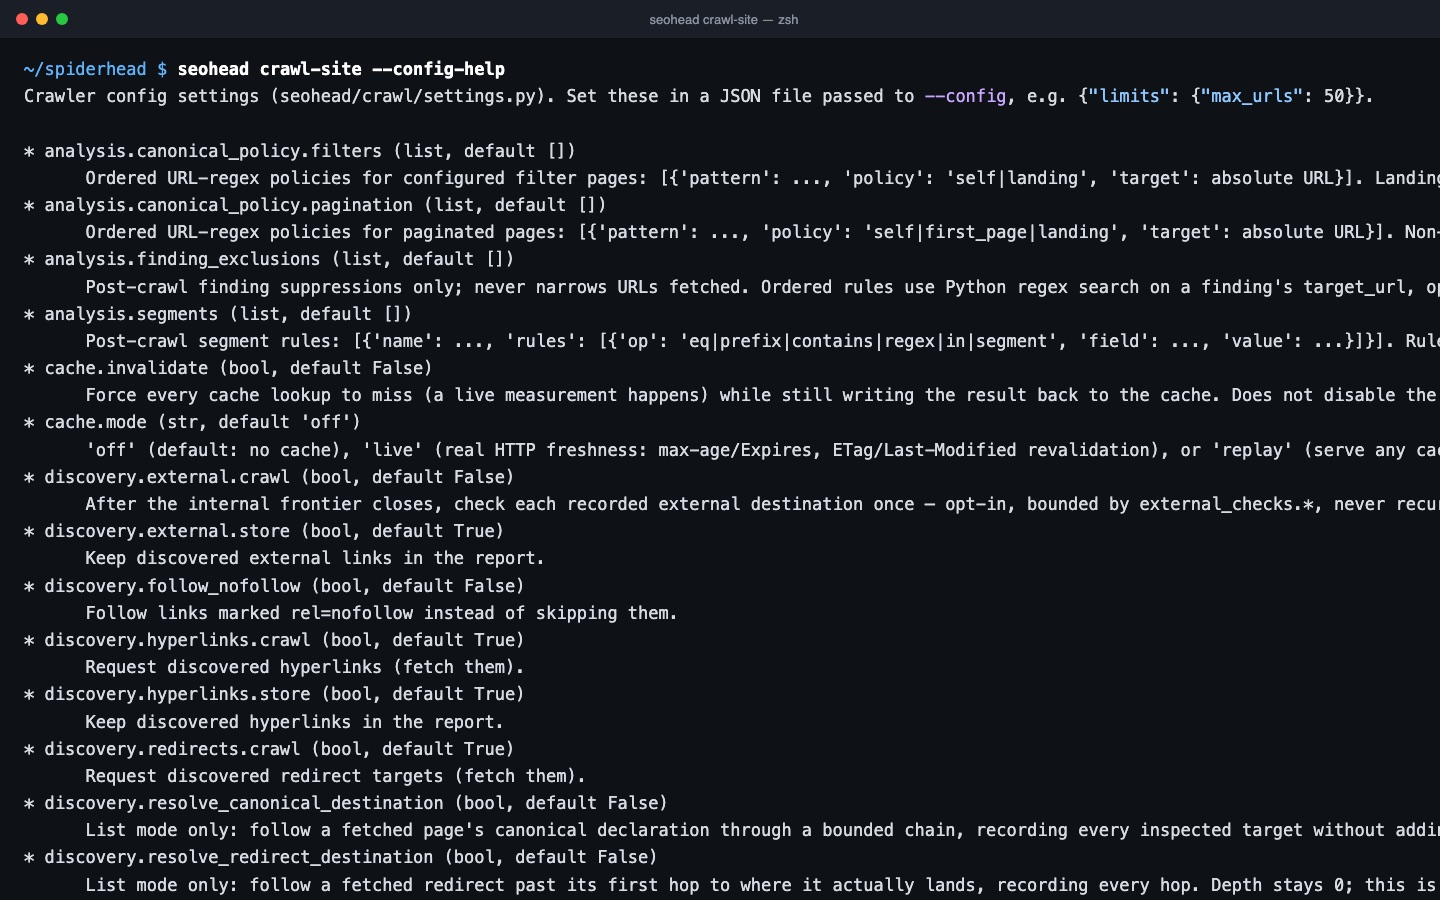
seohead crawl-site --config-help

Primero, instala SpiderHead: guía de instalación. Cada comando también funciona como herramienta MCP para agentes de IA.

Qué necesitas

  • Una URL de inicio
  • Opcional: --max-urls y --max-urls-per-second
  • Opcional: un archivo de configuración del rastreo para pausas, profundidad y alcance

Límites

  • El límite de velocidad es por host; no conoce la capacidad de tu servidor
  • La reducción adaptativa de velocidad reacciona a las respuestas lentas, pero no puede predecir la carga
  • --robots ignore omite robots.txt: úsalo solo en sitios de tu propiedad

Preguntas

¿Ralentizará el rastreador mi sitio?
Por defecto espera 0,5 segundos entre solicitudes y reduce la velocidad por su cuenta cuando el servidor se ralentiza o agota el tiempo de espera. Un rastreo se detiene tras 5 tiempos de espera agotados seguidos.
¿Respeta robots.txt?
Sí, por defecto. --robots report_only descarga robots.txt, informa de lo que quedaría bloqueado y rastrea igualmente. --robots ignore omite robots.txt por completo, así que úsalo solo en sitios de tu propiedad.
¿Puede rastrear un sitio de staging en una dirección privada?
Solo si lo activas. SEOHEAD_ALLOW_PRIVATE_HOSTS permite hosts con nombre, y SEOHEAD_ALLOW_PRIVATE_NETWORKS=1 abre todos los rangos privados.
¿Puedo rastrear más rápido?
Sí. --max-urls-per-second fija la velocidad máxima por host, y speed.concurrency sube el número de solicitudes en curso (1 por defecto). La reducción adaptativa de velocidad puede seguir ralentizando el rastreo si el servidor tiene dificultades. Súbelo solo en servidores que controles.

Pruébalo en tu propio sitio