
Rastreamento responsável: orçamento e limites de requisições

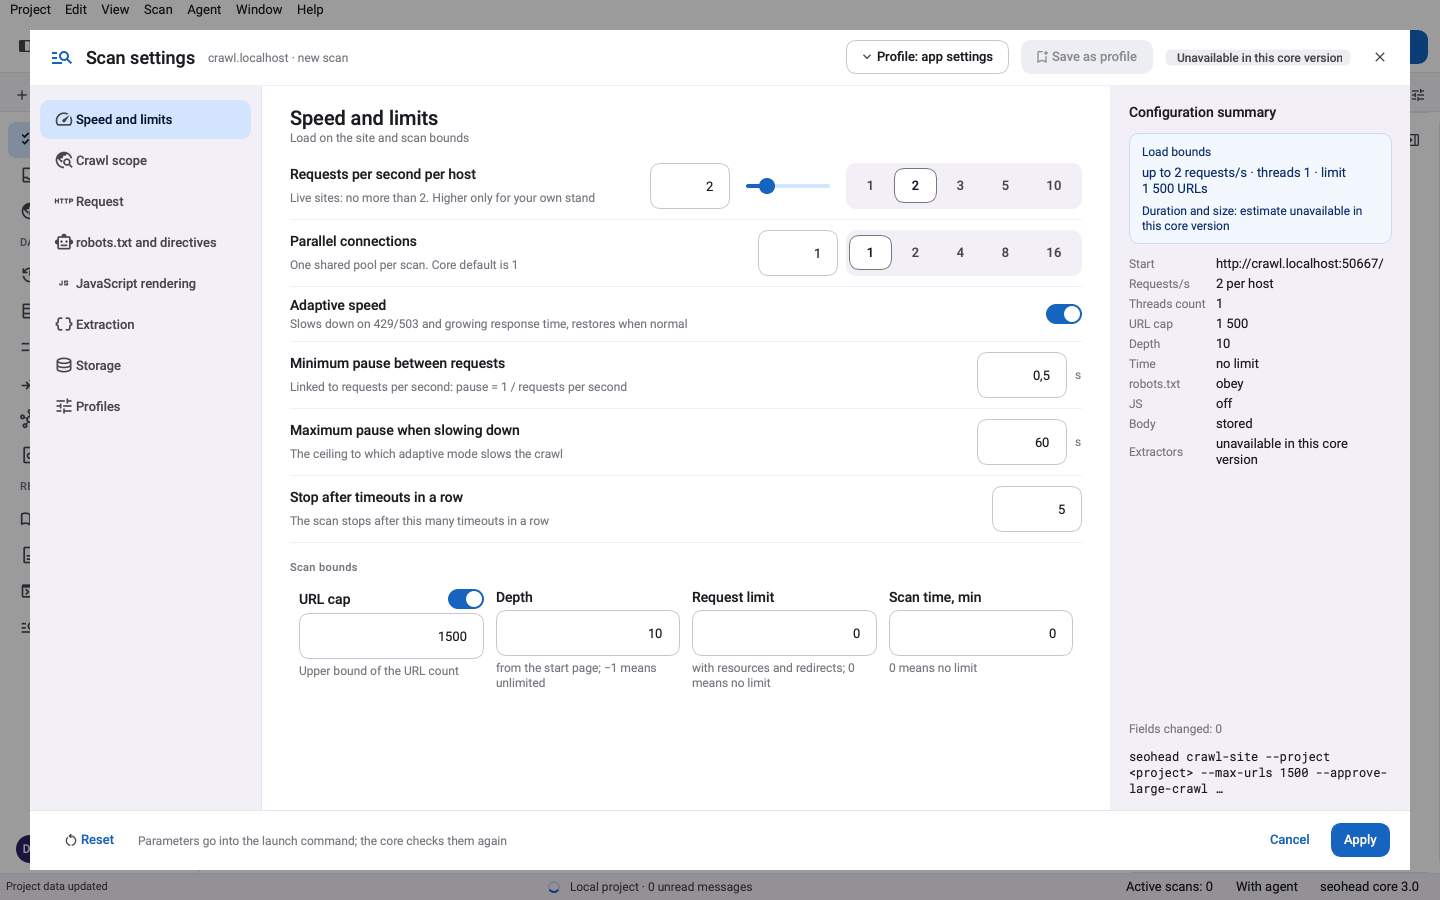
O SpiderHead é responsável por padrão: cerca de duas requisições por segundo por host, requisições limitadas e somente de leitura, e um limite explícito de URLs que funciona como orçamento, e não como palpite sobre o tamanho do site.

O que faz

Orçamentos que você define

O rastreamento para nos limites que você informa: quantidade de URLs (padrão de 200), profundidade de links (padrão de 5), total de tentativas HTTP e, se quiser, um tempo máximo de execução. Você pode restringir com regras de inclusão e exclusão por padrão de URL, extensão de arquivo ou tipo de mídia. Ultrapassar o orçamento de um projeto exige --approve-large-crawl.

  • --max-urls é um orçamento explícito, não um palpite sobre o tamanho do site
  • O intervalo se adapta ao servidor: aumenta quando ele fica lento ou excede o tempo limite

Seguro por padrão

Ferramentas de rede bloqueiam destinos privados e locais, a menos que você os libere pelo nome. O rastreador envia apenas requisições limitadas e somente de leitura para o site que você informa, e se identifica com um User-Agent. Ele também para sozinho depois de 5 timeouts consecutivos.

Três passos, um rastreamento salvo

  1. Defina um orçamento de URLs

    --max-urls limita as páginas que um rastreamento busca (padrão de 200). Ultrapassar o orçamento de um projeto exige --approve-large-crawl.

  2. Controle o ritmo de cada host

    O atraso padrão é de 0,5 segundo entre requisições, cerca de duas por segundo por host. --max-urls-per-second define a taxa, e a redução adaptativa desacelera o rastreamento quando o servidor tem dificuldades.

  3. Respeite o robots.txt e os destinos privados

    O robots.txt é obedecido por padrão, e endereços privados ou locais continuam bloqueados até você liberá-los pelo nome.

Verificações deste recurso

VerificaçãoO que significaGravidadeEvidência
SLOW_RESPONSEO servidor levou mais de 1,5 segundo para responder.ImportantTempo de resposta por página, comparado ao limite de 1,5 s
BLOCKED_BY_ROBOTSA URL é bloqueada pelo robots.txt.ImportantURL bloqueada no rastreamento ou na exportação do Screaming Frog
IMPORTANT_URL_BLOCKED_BY_ROBOTSUma página que recebe links internos está bloqueada pelo robots.txt, então a descoberta de links é interrompida.ImportantURL bloqueada e seus links internos recebidos
ROBOTS_BLOCKS_RESOURCESO robots.txt bloqueia JavaScript ou CSS necessários para renderizar a página.TipURL do recurso bloqueado
SITEMAP_NOT_IN_ROBOTSO robots.txt não tem uma diretiva Sitemap.TipConteúdo do robots.txt

Um comando

bash
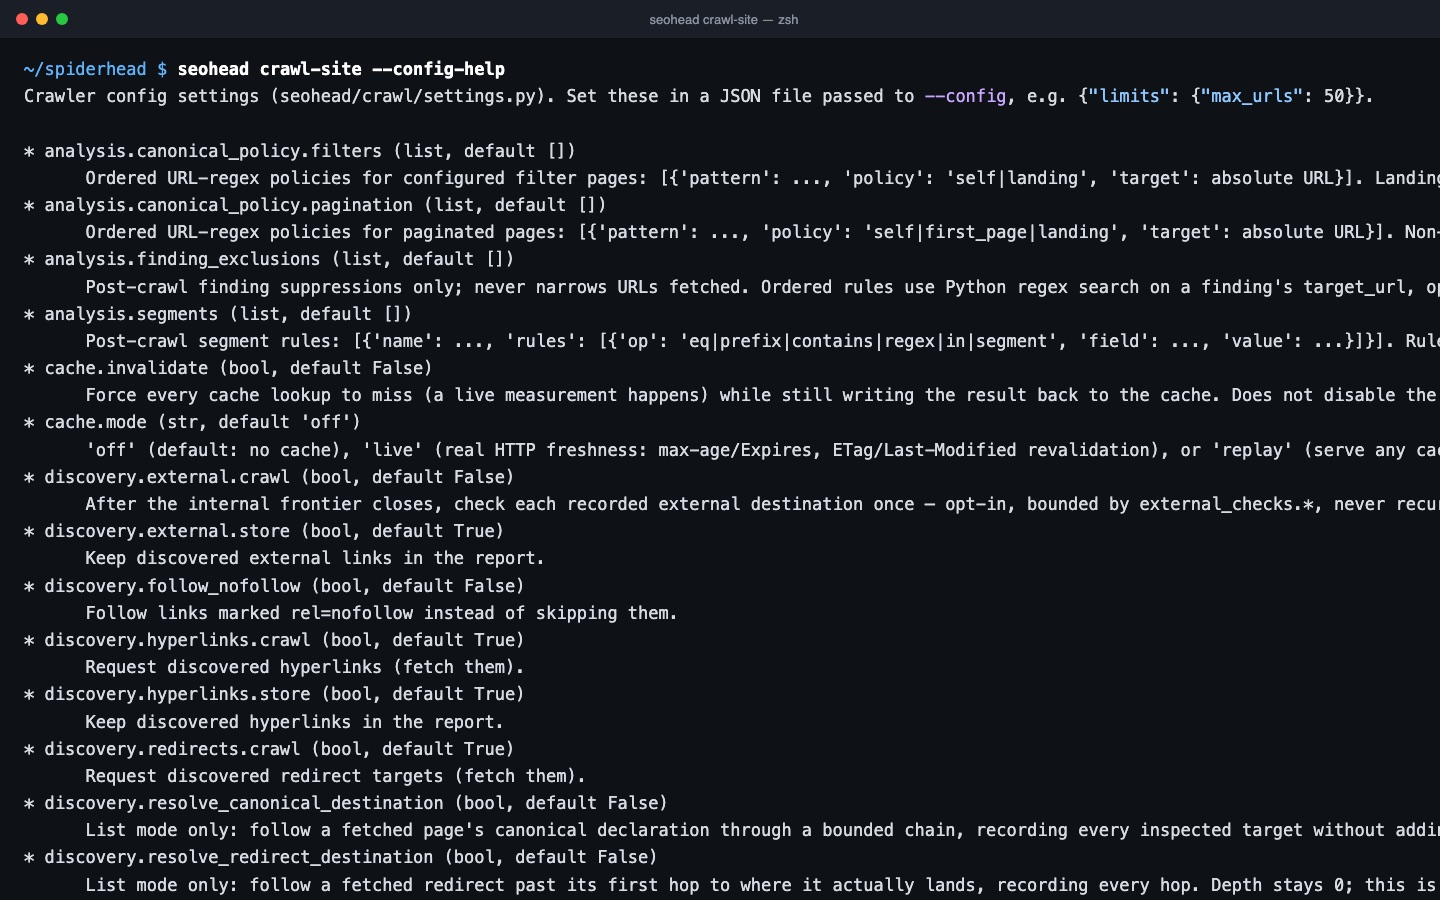
seohead crawl-site --config-help

Instale primeiro: guia de instalação. Todo comando também funciona como ferramenta MCP para agentes de IA.

O que você precisa

  • Uma URL inicial
  • Opcional: --max-urls e --max-urls-per-second
  • Opcional: um arquivo de configuração do rastreamento para atrasos, profundidade e escopo

Limites

  • O limite de taxa é por host; ele não conhece a capacidade do seu servidor
  • A redução adaptativa reage a respostas lentas; ela não consegue prever a carga
  • --robots ignore pula o robots.txt: use apenas em sites que são seus

Perguntas

O rastreador vai deixar meu site lento?
Ele espera 0,5 segundo entre requisições por padrão e recua sozinho quando o servidor fica lento ou excede o tempo limite. O rastreamento para depois de 5 timeouts consecutivos.
Ele obedece ao robots.txt?
Sim, por padrão. --robots report_only busca o robots.txt, informa o que seria bloqueado e rastreia mesmo assim. --robots ignore ignora o robots.txt por completo, por isso use apenas em sites que são seus.
Ele consegue rastrear um site de staging em um endereço privado?
Só depois que você ativar a opção. SEOHEAD_ALLOW_PRIVATE_HOSTS libera nomes de host específicos, e SEOHEAD_ALLOW_PRIVATE_NETWORKS=1 libera todas as faixas privadas.
Dá para rastrear mais rápido?
Dá. --max-urls-per-second define a taxa máxima por host, e speed.concurrency aumenta o número de requisições em andamento (padrão 1). A redução adaptativa ainda pode desacelerar o rastreamento se o servidor tiver dificuldades. Aumente isso apenas em servidores que você controla.

Teste no seu próprio site