
Verificar correcciones SEO

Vuelve a comprobar incidencias o URL concretas después de una publicación. Cada incidencia se clasifica como resuelta, persistente, cambiada o no verificable, usando solo las páginas afectadas.

Qué hace

Comprobación dirigida

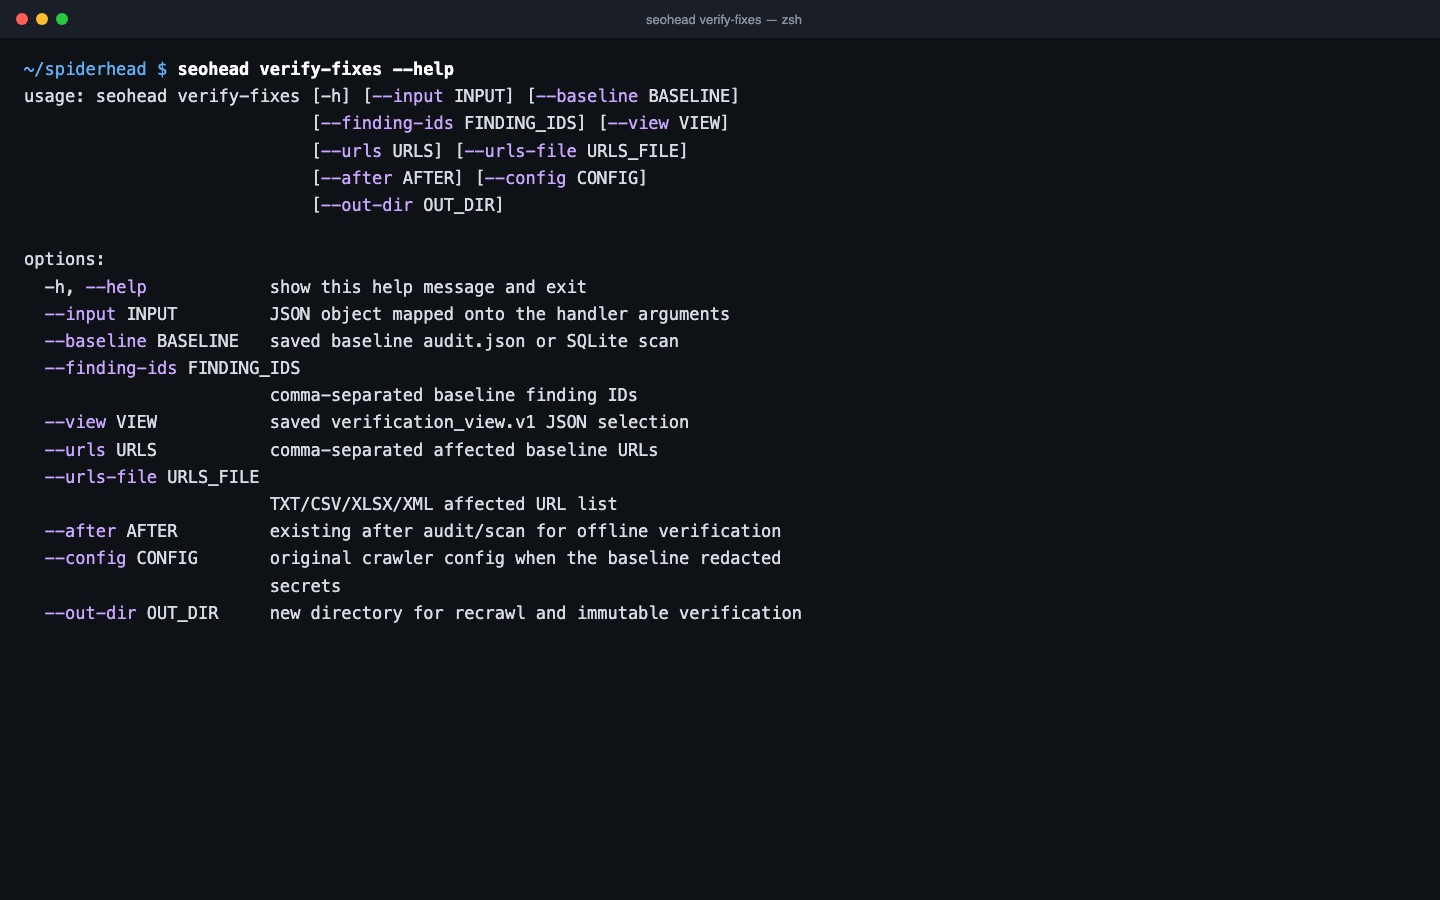
Elige qué comprobar por ID de incidencia, por URL afectada, desde un archivo de URL o desde una vista de verificación guardada. SpiderHead vuelve a pedir solo esas páginas, con la política de HTTP, robots y renderizado registrada en la línea base. Las comprobaciones de todo el sitio no se repiten.

  • Una selección admite como máximo 500 objetivos de rastreo y 5000 incidencias.
  • Una selección que supere los límites falla. Nunca se toma una muestra.
  • --after usa una auditoría o un escaneo posterior que ya existe, así que no se envía ninguna petición.

Veredictos acotados

Una comprobación parcial no puede declarar corregido todo el sitio. Las comprobaciones de todo el sitio y las no medidas aparecen como no verificables. Un rastreo posterior no válido no puede resolver incidencias, y volver a analizar el mismo escaneo no es una evidencia nueva.

  • Cada veredicto incluye un motivo y la evidencia.
  • Los resultados se escriben como un archivo JSON y Markdown nuevo e inmutable.
  • Las páginas que faltan siguen como no verificables.

Registro de correcciones

En trabajos más largos, un registro de correcciones vinculado a un proyecto sigue cada caso por sus estados. Una tarea avanza según la evidencia de la nueva comprobación, así que una tarea marcada como hecha no se confunde con un sitio corregido. Las nuevas comprobaciones se limitan a los casos pendientes exactos.

  • remediation-ingest carga una auditoría guardada como línea base.
  • remediation-recheck comprueba los casos pendientes sin rastrear el sitio.
  • remediation-report muestra la evidencia de antes y después sin conexión.

Tres pasos, un análisis guardado

  1. Parte de una línea base

    Indica a verify-fixes el audit.json o el escaneo SQLite que ya tienes y, después, elige los IDs de incidencias o las URL afectadas.

  2. Comprueba solo las páginas afectadas

    Vuelve a pedir las URL seleccionadas con la política de HTTP, robots y renderizado registrada en la línea base. Las comprobaciones de todo el sitio no se repiten.

  3. Lee el veredicto por incidencia

    Cada incidencia se marca como resuelta, persistente, cambiada o no verificable, con un motivo y la evidencia en un nuevo archivo JSON o Markdown inmutable.

Comprobaciones de esta función

ComprobaciónQué significaGravedadEvidencia
BROKEN_PAGE_4XXLa página devuelve un estado 4xx; una nueva comprobación puede mostrarla como corregida cuando la URL devuelve 2xxCriticalCódigo de estado antes y después, por URL
SERVER_ERROR_5XXLa página devuelve un estado 5xx; solo se resuelve cuando la nueva comprobación obtiene un 2xxCriticalCódigo de estado antes y después, por URL
TITLE_MISSINGLa página no tiene elemento title; una corrección aparece como resuelta en la misma URLCriticalFilas de incidencias de la línea base y de la nueva comprobación para la URL
H1_MISSINGLa página no tiene encabezado H1ImportantFilas de incidencias de la línea base y de la nueva comprobación para la URL
CANONICAL_MISSINGLa página no tiene elemento link canonicalImportantFilas de incidencias de la línea base y de la nueva comprobación para la URL
REDIRECT_CHAINLa redirección pasa por dos o más saltos antes de la URL finalImportantEstado por salto en la nueva comprobación
BAD_REDIRECT_TYPESe usa un 302, 303 o 307 donde se espera una 301 permanenteTipEstado por salto en la nueva comprobación

Un solo comando

bash
seohead verify-fixes --baseline ./report/audit.json --urls https://example.com/old-page --out-dir ./verification-1

Primero, instala SpiderHead: guía de instalación. Cada comando también funciona como herramienta MCP para agentes de IA.

Qué necesitas

  • Una línea base: un audit.json guardado o un escaneo SQLite
  • Una selección: IDs de incidencias, URL, un archivo de URL o una vista guardada
  • Una carpeta de salida nueva (--out-dir) para los archivos de verificación
  • Opcional: la configuración original del rastreador si la línea base ocultó credenciales (--config)

Límites

  • Sin --after, envía peticiones de lectura a las URL que selecciones.
  • Solo se comprueban las páginas seleccionadas. No vuelve a escanear el sitio.
  • Un escaneo posterior usado con --after debe ser distinto y haberse observado después de la línea base.
  • Las comprobaciones de todo el sitio no se pueden verificar a partir de una comprobación parcial.

Preguntas

¿Cambia algo en mi sitio?
No. Solo envía peticiones de lectura a las URL que selecciones. El resultado es un nuevo archivo de verificación en la carpeta que indiques con --out-dir.
¿Un resultado resuelto significa que todo el sitio está corregido?
No. Solo comprueba las páginas afectadas que has seleccionado. Las comprobaciones de todo el sitio y las no medidas no pueden pasar a corregidas con una comprobación parcial; aparecen como no verificables.
¿Hace falta rastrear de nuevo antes?
Necesitas una línea base: un audit.json guardado o un escaneo SQLite. Para comprobar sin peticiones de red, pasa --after con una auditoría posterior que ya exista, y funciona sin conexión.
¿Cuántas incidencias puedo verificar en una sola ejecución?
Hasta 500 objetivos de rastreo y 5000 incidencias. Las selecciones más grandes fallan en lugar de tomar una muestra, así que divídelas.
¿En qué se diferencia de compare-crawls?
compare-crawls compara dos archivos guardados y no descarga nada. verify-fixes vuelve a pedir las páginas que seleccionas y da un veredicto por incidencia. Usa compare-crawls para una visión general de una publicación y verify-fixes para cerrar tareas concretas.
¿Puedo usarlo desde un asistente de IA?
Sí. La misma operación está disponible en el servidor MCP local como seo_verify_fixes, con los mismos argumentos que la CLI.

Pruébalo en tu propio sitio