
Lista de tarefas de SEO para desenvolvedores

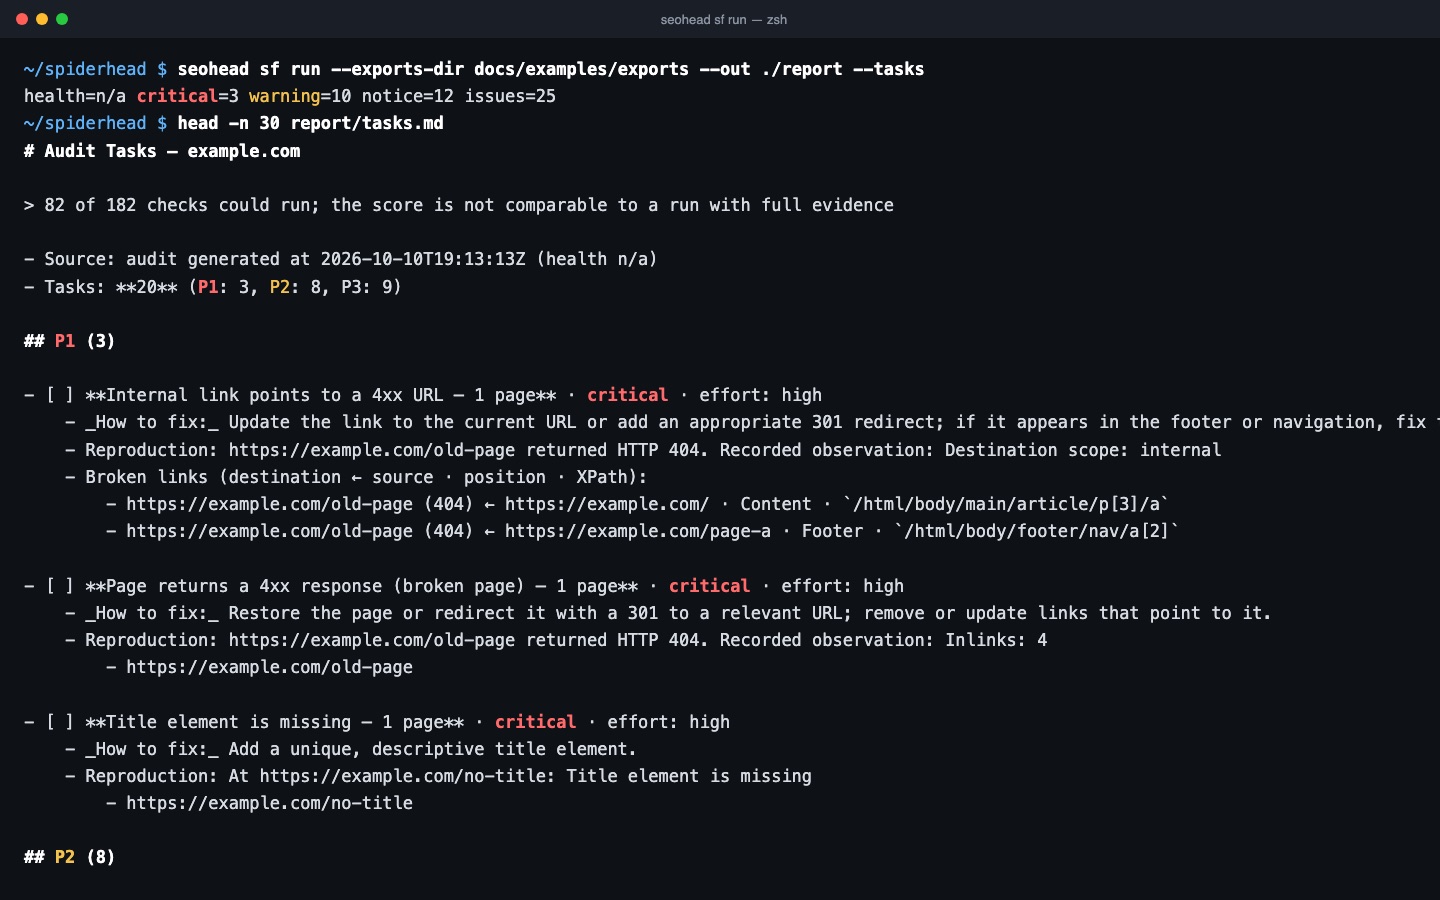
Uma auditoria pode gerar um backlog de tarefas priorizado: uma tarefa por tipo de problema, com prioridade, esforço, URLs afetadas, dica de correção e linhas de reprodução. Links quebrados também listam a página de origem, a posição do link e o XPath.

O que faz

P1 a P3

As tarefas são agrupadas por prioridade no tasks.md e também salvas como tasks.json, para scripts e agentes. Por padrão, problemas críticos viram P1 com esforço alto, avisos viram P2 com esforço médio e notas viram P3 com esforço baixo. O mapeamento é uma regra, não uma estimativa para cada site, e pode ser alterado.

  • Uma tarefa por verificação, por padrão; o group_by também pode criar uma tarefa por URL ou por template declarado
  • Cada tarefa traz uma dica de correção tirada da verificação
  • As URLs afetadas são limitadas por tarefa, e a tarefa informa quantas ficaram de fora
  • Gravidades, verificações e ocorrências mínimas podem ser filtradas na configuração

Reprodução e evidências

Cada tarefa lista linhas de reprodução tiradas da auditoria salva: a URL, o código de status e, no caso de links, onde eles estão na página. Se a auditoria não tiver reprodução, o tasks.md informa isso e não inventa uma. As tarefas também mantêm referências às observações salvas de onde vieram, quando a auditoria as tiver.

  • Links quebrados: destino, página de origem, posição do link e XPath
  • Auditorias parciais ou com verificações puladas levam esse aviso para o tasks.md
  • URLs ocultas por regras de exclusão não aparecem na lista, e o arquivo informa quantas são

Nova verificação

O tasks.md é um backlog proposto, não um plano aprovado. Depois de uma publicação, não considere uma tarefa como corrigida só porque ela sumiu da lista. Confirme com uma nova verificação nas URLs afetadas, usando as ferramentas de correção ou o verify-fixes, e compare um scan antes com um scan depois.

  • O verify-fixes verifica de novo os problemas de referência selecionados em um subconjunto explícito de URLs
  • O remediation-recheck trabalha com casos exatos do registro e grava a evidência da verificação
  • Um problema que desapareceu não prova a correção quando o scan posterior foi parcial

Três passos, um rastreamento salvo

  1. Rode a auditoria a partir das exportações

    Aponte a CLI para uma pasta de exportações CSV ou XLSX do Screaming Frog e adicione --tasks para obter o backlog na mesma execução.

  2. Veja as tarefas ranqueadas de P1 a P3

    Cada tarefa tem prioridade, estimativa de esforço, as URLs afetadas, a correção e a reprodução. Links quebrados também listam a página de origem, a posição do link e o XPath.

  3. Verifique de novo depois da publicação

    Confirme cada correção com a ferramenta de nova verificação do registro, e não pelo fato de a tarefa ter sumido da lista.

Verificações deste recurso

VerificaçãoO que significaGravidadeEvidência
BROKEN_PAGE_4XXA página retorna uma resposta 4xxCriticalURL afetada e seu código de status
BROKEN_INTERNAL_LINKUm link interno aponta para uma URL 4xxCriticalDestino, página de origem, posição do link e XPath de cada link quebrado
REDIRECT_LOOPUm ciclo de redirecionamento que nunca chega a um destino válidoCriticalLinhas do relatório de cadeia de redirecionamentos
TITLE_MISSINGA página não tem a tag titleCriticalURLs afetadas, limitadas por tarefa
REDIRECT_CHAINDois ou mais saltos de redirecionamento antes da URL finalImportantSaltos no relatório de cadeia de redirecionamentos
DESC_MISSINGA página não tem meta descriptionImportantURLs afetadas, limitadas por tarefa
H1_MISSINGA página não tem título H1ImportantURLs afetadas, limitadas por tarefa
BAD_REDIRECT_TYPEUm 302, 303 ou 307 é usado onde se espera um redirecionamento permanenteTipURLs afetadas, limitadas por tarefa

Um comando

bash
seohead sf run --exports-dir ./exports --out ./report --tasks

Instale primeiro: guia de instalação. Todo comando também funciona como ferramenta MCP para agentes de IA.

O que você precisa

  • Uma pasta com exportações CSV ou XLSX do Screaming Frog, ou um audit.json já existente
  • Ou um scan nativo salvo (arquivo SQLite scan.v1) gerado pelo crawl-site
  • Um config.json opcional com um bloco tasks_pipeline
  • Uma CLI do Screaming Frog com licença, apenas se você quiser que o sf run inicie o rastreamento

Limites

  • Ele monta um backlog proposto a partir de uma auditoria. Não aprova, não atribui nem publica trabalho
  • Prioridade e esforço vêm da gravidade, por regra, e não do tamanho do seu site ou da equipe
  • Listas de URLs e linhas de reprodução são limitadas por tarefa, então cada tarefa mostra uma amostra mais a contagem
  • A cobertura depende da auditoria: uma verificação que não rodou não gera tarefa

Perguntas

Preciso de licença do Screaming Frog?
Não para o gerador de tarefas. Ele lê exportações que você já tem (CSV ou XLSX), um audit.json ou um scan nativo. Só o sf run com --crawl inicia um rastreamento, pela CLI do Screaming Frog com licença.
Ele muda alguma coisa no meu site?
Não. O gerador de tarefas lê a auditoria e grava arquivos: tasks.json e tasks.md, na pasta indicada com --out. Você decide o que publicar.
Posso mudar as prioridades?
Sim. Passe um config.json com --config e defina priority_map, effort_map, group_by, include_severities, max_urls_per_task e min_occurrences dentro de tasks_pipeline.
E se uma tarefa não tiver passos de reprodução?
O tasks.md informa que a reprodução não está disponível na auditoria salva. Ele não inventa uma.
Posso montar tarefas a partir de uma auditoria que já tenho?
Sim. Rode o sf tasks com --json apontando para um audit.json ou para um arquivo de scan nativo. Ele grava tasks.json e tasks.md sem rastrear nem enviar requisições.
Um agente de IA pode rodar isso?
Sim. Os mesmos passos existem como ferramentas MCP: sf_audit_run para a auditoria e sf_audit_tasks para o backlog.

Teste no seu próprio site