
Интеграция с Google Search Console

Запрашивайте Search Console, архивируйте её данные в локальном SQLite-файле и соединяйте их с данными сканирования по каждому URL. Доступ только на чтение, используются ваши учётные данные Google.

Что делает

Подключение только на чтение

SpiderHead использует только область доступа Search Console «только чтение». Доступ можно передать тремя способами, и выбираете один вы. Затем provider-verify отдельно проверяет доступ к ресурсу, потому что успешный вход не доказывает, что вы можете читать конкретный сайт.

  • Согласие в браузере через ваш OAuth-клиент типа Desktop и скрипт scripts/gsc_oauth_login.py. Refresh-токен хранится в вашей локальной папке конфигурации.
  • Сервисный аккаунт Google, которого вы добавляете пользователем в ресурс.
  • Готовый токен доступа в настройке GSC_ACCESS_TOKEN.

Локальная история

gsc-archive ставит диапазон дат в очередь и загружает его небольшими порциями, которые можно продолжить, в SQLite-файл, который вы укажете. sources-sync ведёт ежедневную историю по каждому проекту и загружает только недостающие дни. Ничего не уходит в облачный сервис, а файлы создаются с правами только для владельца.

  • Даты включаются в диапазон и считаются по тихоокеанскому времени.
  • Срезы (итоги, страницы, запросы) — отдельные наборы данных, и их никогда не суммируют.
  • Архивы могут содержать запросы и URL, поэтому не публикуйте их в открытых отчётах и не кладите в Git.

Проверка URL

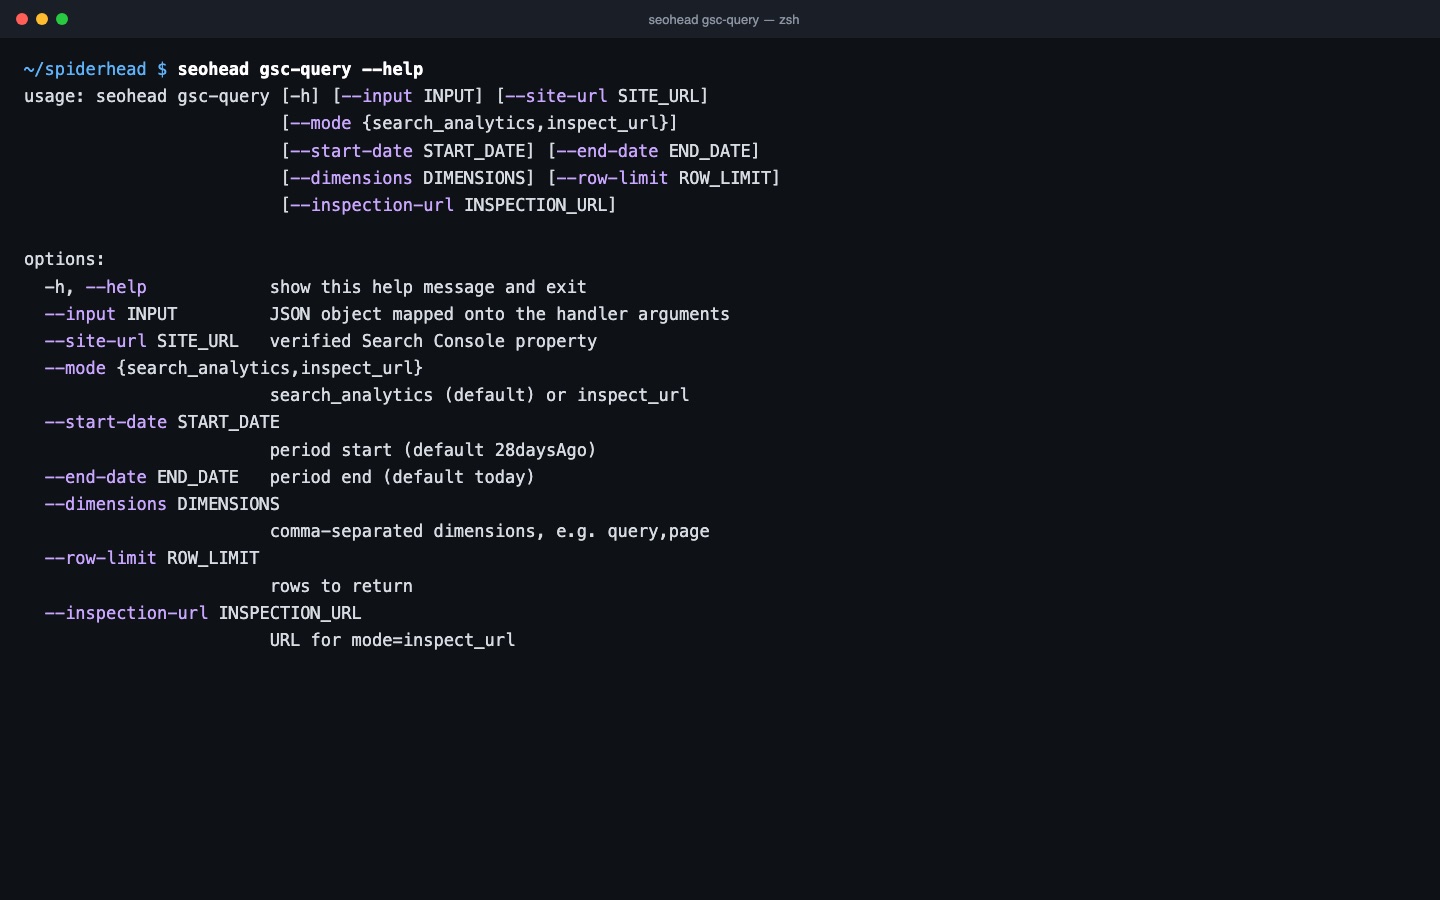
gsc-query в режиме inspect_url возвращает собственный вердикт индексации Google по одному URL. Он выводится отдельной строкой, отдельно от проверок краулера. Внутри sf run флаг --gsc-inspect проверяет детерминированную выборку до 50 URL с локальными лимитами: 600 в минуту и 2000 за 24 часа.

  • Проверить можно только индексируемую версию страницы.
  • Поверх локальных лимитов действуют лимиты Google на сайт.
  • Непроверенные URL остаются в статусе «неизвестно».

Три шага — один сохранённый скан

  1. Подключите один доступ только на чтение

    Подключите доступ Google только на чтение для ресурса, которым владеете. Статус можно проверить в любой момент.

  2. Заархивируйте локально

    Поставьте диапазон дат в очередь и загрузите его небольшими ограниченными порциями в SQLite-файл на вашем компьютере. Повторные запуски догружают только недостающие дни.

  3. Соедините с каждым URL

    Клики, показы, позиция и CTR соединяются со страницами сканирования по URL. Собственный вердикт индексации Google по одному URL остаётся отдельной строкой.

Одна команда

bash
seohead gsc-query --site-url sc-domain:example.com --start-date 2026-09-01 --end-date 2026-09-30

Сначала установите: руководство по установке. Каждая команда работает и как MCP-инструмент для ИИ-агентов.

Что нужно

  • Ресурс Search Console, который вы владеете или можете читать (доменный ресурс или префикс URL)
  • Один вид доступа: согласие через OAuth, сервисный аккаунт или токен доступа (все только на чтение)
  • Диапазон дат в пределах примерно последних 16 месяцев
  • Необязательно: сканирование или скан, к которым привязать строки

Ограничения

  • Google хранит около 16 месяцев данных.
  • Анонимизированные запросы опускаются, а строки могут быть ограничены. Ограниченное задание помечается и не является полной выгрузкой.
  • Клики, показы, CTR и позицию нельзя суммировать между разными срезами данных.
  • Вердикт индексации относится только к URL, которые вы проверяете.

Вопросы

Мои данные уходят в облачный сервис?
Нет. Запросы идут с вашего компьютера напрямую в API Google Search Console, с вашим доступом. Результаты хранятся в локальных SQLite-файлах с правами только для владельца. Не публикуйте эти файлы в открытых отчётах и не кладите в Git: в них могут быть запросы и URL.
Может ли инструмент изменить мой ресурс в Search Console?
Нет. Доступ только на чтение. Инструмент лишь читает аналитику поиска и результаты проверки URL.
Как далеко назад уходят данные?
Примерно на 16 месяцев: столько истории доступно в Google. Даты включаются в диапазон и считаются по тихоокеанскому времени.
Почему некоторых запросов как будто нет?
Google не показывает анонимизированные запросы и может ограничивать число возвращаемых строк. Ограниченное задание не является полной выгрузкой, и инструмент помечает его именно так.
Вердикт индексации Google заменяет проверки сканирования?
Нет. Вердикт Google по одному URL приходит из gsc-query в режиме inspect_url. Собственные проверки краулера (метаданные, заголовки, robots, редиректы, структурированные данные, рендеринг) выполняет inspect-url. Оба результата остаются отдельными.
Сколько это стоит и что хранится локально?
API бесплатен в пределах квот Google. SpiderHead хранит ваш refresh-токен или путь к файлу сервисного аккаунта в локальной папке конфигурации, а архив и файлы истории там, куда вы их направите. В файлы истории токен не записывается.

Проверьте на своём сайте